2026 年 10 月 22 日
Sarah Chieng
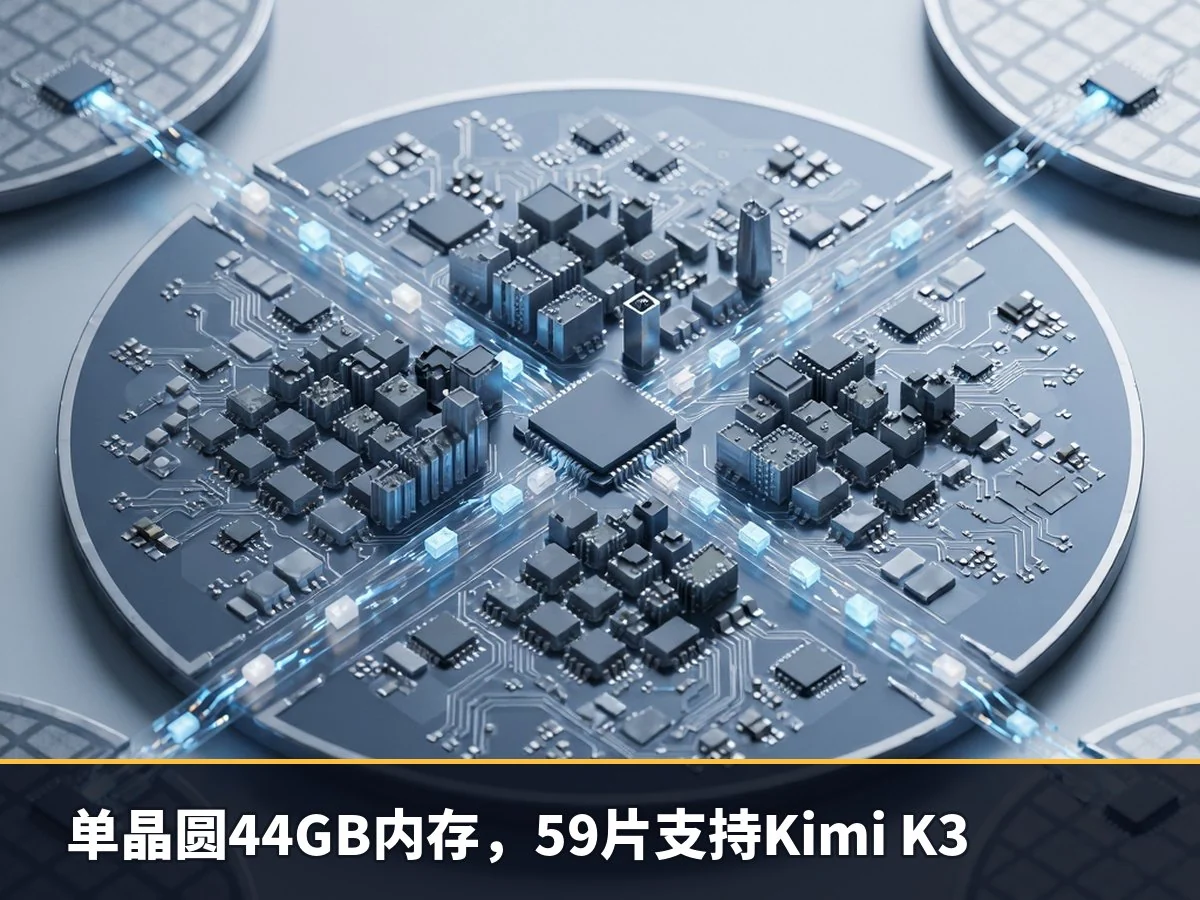
如何在 Cerebras 晶圆芯片上部署大型模型是业界关注焦点。单个 Cerebras WSE-3T 晶圆配备 44GB 片上内存。本文以开源模型 Kimi K3(3 万亿参数)为例,解析如何将大型边界模型分割并映射至多个 WSE-3T 晶圆,从而实现每秒 1000-2000+ 代币的推理速度。
核心内容涵盖:
- 模型权重与完整架构在芯片内存中的适配策略
- 跨多晶圆的模型映射机制
- 高并发请求的处理逻辑
Kimi K3 模型特性
Kimi K3 是一个拥有 3 万亿参数的开源模型,包含 69 个线性注意层和 24 个密集层。
性能测试显示,Kimi K3 在 Terminal Bench 2.1 中得分 88.3%(对比 GPT-5.6 Sol 的 88.8%),在 BrowseComp 中得分 91.2%(对比 GPT-5.6 Sol 的 90.4%)。这表明其在编码和代理能力方面已达到前沿水平,部分基准表现优于领先的专有模型。
本案例基于以下假设进行计算:
- 平均请求大小为 256k
- 采用 4 位权重量化(参考 Hugging Face 实现)
- 使用 8 位 KV 缓存
层级大小估算
为确定支持 Kimi K3 所需的 Cerebras WSE-3T 晶圆总数,首先需计算每层模型的大小。
Kimi K3 总参数量为 3 万亿。若全部以 4 位存储,原始参数负载如下:
将该负载均分至 93 层,得出单层大小约为:
晶圆数量计算
已知每层约需 16GB 空间,结合 44GB 的单晶圆容量,可容纳的层数取决于层类型:
- 密集层:需要额外空间存储 KV 缓存,因为每个活跃请求在每个密集(全注意力)层中都要存储每个代币的键和值。剩余 SRAM 用于此目的。
- 线性注意层:无需额外的 KV 缓存空间。此类层不存储每个代币的键值对,而是保持固定大小的状态,不受上下文长度影响。因此,单个晶圆可容纳两个线性层(2 × 16 GB = 32 GB)。
基于 Kimi K3 的 69 个线性层和 24 个密集层配置,所需晶圆数计算如下:
总计需要 35 + 24 = 59 个晶圆。
晶圆互联机制
模型执行采用流水线方式。Cerebras 编译器将模型层映射到晶圆区域后,运行时负责管理晶圆间的代币流动路径。为实现超低延迟,仅需在晶圆间传递激活值,通过以太网 RDMA 完成,每跳延迟约为 2 微秒。
由于每个 Cerebras 晶圆拥有 44GB 片上 SRAM,而单层仅需 16GB,通常可将整个模型层直接驻留在芯片上。这意味着大多数情况下,模型权重无需移动,也无需在晶圆内部拆分层,只有激活值会在晶圆间传输。
单请求处理流程
每个晶圆可视为装配线的一个阶段:模型权重保持原位,请求的中间结果在各层阶段间流动。
例如,晶圆 1 执行第 1-2 层并将激活发送至晶圆 2;晶圆 2 执行第 3-4 层并将结果传递给晶圆 3,依此类推,直至最后一个晶圆生成下一个代币。
多请求并发服务
针对“代币必须顺序穿过每个晶圆导致空闲等待”的常见误解,实际系统运行并非如此。
若串行发送请求并等待完成,将导致管道利用率低下。正确做法是让不同请求同时充满整个管道。由于模型已划分为管道阶段,每个阶段可同时处理不同请求。例如,当阶段 3 处理请求 A 时,阶段 2 正在处理请求 B,阶段 1 正在处理请求 C。在本例中,每个阶段对应一层;在生产环境中,Cerebras 使用更细粒度的阶段划分。
Loading player...每个阶段还可处理微批次(一组请求而非单一请求)。飞行中的请求总数大致等于阶段数乘以微批次大小。
Loading player...权衡关系在于:较小的微批次提升单个请求的速度,较大的微批次则增加总吞吐量。
并发请求容量评估
分配给 KV 缓存的芯片内存量决定了最大并发请求数。每个飞行中的请求需在每个密集层晶圆上占用独立的 KV 缓存空间,因此芯片内存限制了并发上限。此处仅计算密集层的 KV 缓存需求。
对于承载一个密集层的 44GB 晶圆,KV 缓存剩余空间计算方式为:总晶圆存储减去密集层大小。
并发请求数量计算:
首先计算单个 256k 请求占用的缓存量:
随后根据该配置支持的并发请求总数进行除法运算:
同步请求总数代表任意时刻通过管道流动的并发请求量。不同于 GPU 批处理,这些请求无需互相等待,而是持续流经管道。
需注意,并发性和批量大小并不完全等同于推理效率。评估推理系统吞吐量的更有效指标是在相同输出生成速度下的单位功率通量(如每秒每兆瓦)。
扩展至更大模型
该方法同样适用于更大规模的模型:计算权重及请求状态所需的内存,将模型分布至多个晶圆,并连接成管道。每个额外晶圆提供计算能力和芯片内存,从而容纳超出单一芯片容量的模型。
设计者:Harry。感谢 Atharva Talpade, Zhenwei Gao, Angela Yeung, Jessica Liu, Joyce Er, Emma Call 和 Rohan Gupta 的评论与反馈。