DDR5 价格飙升催生新硬件:TradeMAV 推出 RAMDeck 众筹项目
在 DDR5 内存成本较 2025 年中期上涨约五倍的背景下,小型科技公司 TradeMAV 提出了一种替代方案:通过名为 RAMDeck 的众筹硬件,将家中闲置设备(如旧 PC、Mac 和 Android 手机)的内存整合起来,以运行更大的 AI 模型。
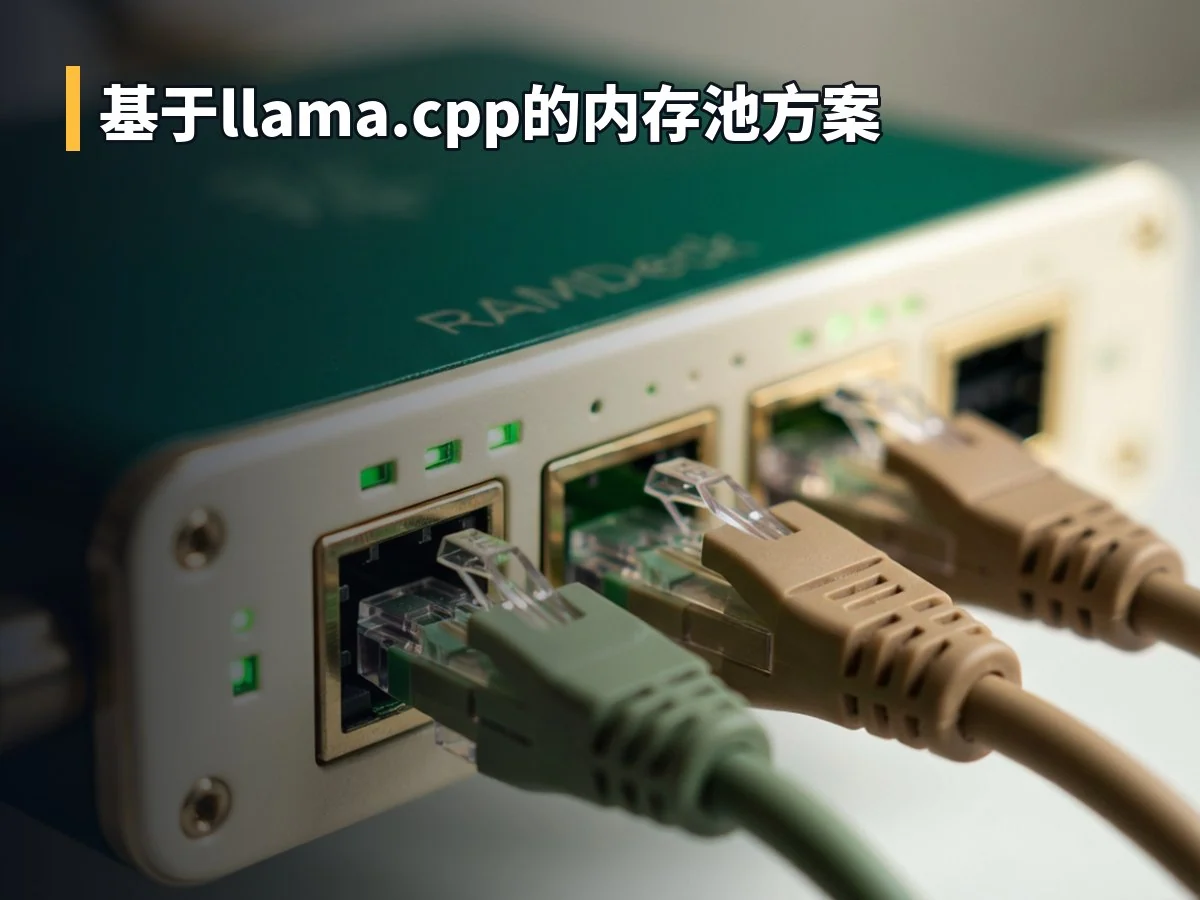
该项目目前在 Indiegogo 平台进行众筹,目标金额为 10,000 美元,截止日期为 2026 年 11 月 8 日。早期支持者的价格为 109 美元。RAMDeck 本质上是一个低功耗网络枢纽,旨在连接 Windows、macOS、Linux 及 Android 设备,构建家庭局域网内的内存池。
底层技术基于开源软件 llama.cpp
尽管 RAMDeck 是一款硬件产品,但其核心引擎并非专有技术,而是基于开源项目 llama.cpp 的 RPC 后端。根据 TradeMAV 发布的 GitHub 仓库信息,该机制在每个贡献设备上启动 llama.cpp 的 ggml RPC 服务器,协调者通过标准协议驱动这些节点。
硬件层面并未实现物理内存合并。相反,AI 模型的层被分割并分配至不同机器,每台设备利用本地内存处理部分数据,仅通过网络传输中间结果以生成每个代币(token)。TradeMAV 的主要贡献在于编排系统,包括自动设备发现、层放置策略、优先填充 GPU 快速内存、故障恢复以及提供兼容 OpenAI API 的仪表板。
目前,RAMDeck 的具体硬件规格(如处理器型号、内存大小、端口类型及功耗数据)尚未公开披露。对于具备终端脚本操作能力的用户,直接免费使用 llama.cpp 或 Exo 实验室的 exo 等开源工具可能是更灵活的选择。
性能表现与竞品对比
受限于内存带宽和网络延迟,RAMDeck 的性能取舍明显:以容量换取速度。TradeMAV 在其基准测试文章中坦承,追求原始推理性能的用户应优先考虑配备更高 VRAM 的独立 GPU,而非此类聚合方案。
演示数据显示,最快性能依赖于混合专家模型(MoE),这类模型每个代币仅激活约 30 亿参数。具体案例如下:
- Qwen3-Coder 30B:在搭配 RTX 3060 的 Beelink 迷你 PC 和 M4 Mac mini 组合中,达到每秒 39 个代币。
- Qwen3-Coder-Next (40B REAP 变体):在上述配置下,速度约为每秒 16 个代币。
- 7B 模型:在 RTX 3060 上运行时,可达每秒 43 个代币。
相比之下,密集模型(Dense Models)的表现较为缓慢:
- 27B 密集模型:在四个设备组成的集群中,速度仅为每秒 1.92 个代币。
- gpt-oss-120b:在六个设备集群上,速度为每秒 1.37 个代币;在五台不同机器的组合中,提升至每秒 3.1 个代币。
这一表现优于因显存不足导致的崩溃情况,这也是 TradeMAV 推广该方案的主要卖点之一。
市场背景与竞争格局
该项目的兴起与全球内存短缺密切相关。德国零售数据机构 3DCenter 显示,截至 8 月中旬,DDR5 价格已攀升至 2025 年 7 月水平的 486%。三星曾向分析师表示短缺将持续至 2028 年,而 SK 集团董事长则警告可能延续至 2030 年。TradeMAV 引用其内部指南指出,一套 64GB DDR5 内存套装的价格从 2025 年 8 月的约 191 美元飙升至一年后的 1,118 美元,这与 TechRadar 调查得出的平均 2x32GB DDR5-5600 套装价格翻近四倍(达约 800 美元)的数据大致吻合。
多设备协同计算并非新概念。自 2025 年初以来,Exo 实验室的开源 exo 已在计算机、手机和单板计算机间实现了自动设备发现和 API 调用。在高端领域,Apple 的新款 M5 Ultra Mac Studio 支持基于 Thunderbolt 5 的 RDMA 集群,官方声称四台机器的推断速度可达单机的三倍。
RAMDeck 的独特之处在于其广泛的兼容性,承诺可将 Windows CUDA 桌面、Apple Silicon Mac、旧款 Intel Mac、Linux 主机及 Android 手机纳入同一集群。这种异构设备的组合能力得益于 llama.cpp 后端的灵活性。
免责声明:本文不构成对任何众筹项目的推荐或背书。众筹活动存在固有不确定性,包括交付延迟、规格变更或产品无法兑现的风险。潜在支持者应自行评估细节并谨慎决策。