Meta生产环境启用Google TPU,PyTorch原生支持落地
Meta生产环境启用Google TPU,PyTorch原生支持落地。三方合作推出TorchTPU方案,使SGLang等引擎无需重写代码即可在TPU运行,降低对Nvidia生态依赖。
共 3 篇相关文章
Meta生产环境启用Google TPU,PyTorch原生支持落地。三方合作推出TorchTPU方案,使SGLang等引擎无需重写代码即可在TPU运行,降低对Nvidia生态依赖。
AI代币成本正以每年数个数量级的速度骤降,大模型预计一至两年内将整合进计算各层面成为基础设施。GPU能效约每两年翻一番,叠加推理引擎优化,同等质量下任务成本大幅降低,瓶颈转向质量与访问权限。
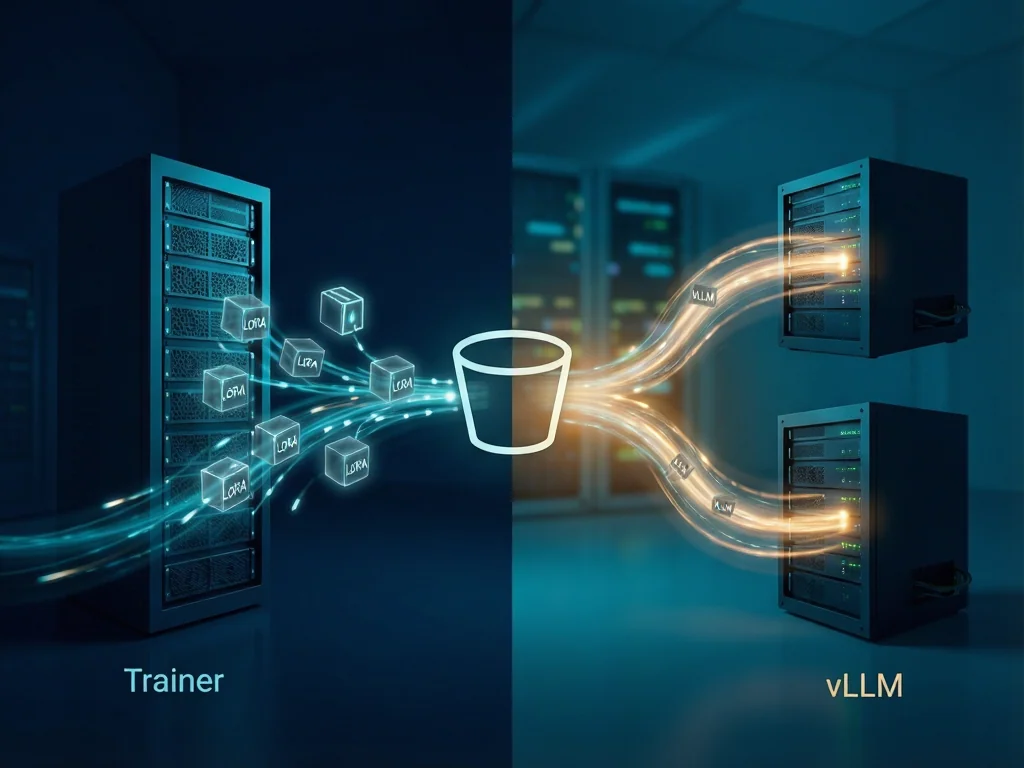
TRL v1.14 的 AsyncGRPOTrainer 新增 LoRA 适配器训练与同步能力。利用 Hugging Face Jobs 和存储桶挂载,实现了训练器与 vLLM 推理副本在独立机器上的异步运行,无需 NCCL。实测显示,相同配方下 500 步训练耗时从 3 小时 27 分钟压缩至 53 分钟。