Mistral Large 4发布:1T参数MoE模型支持百万上下文
Mistral发布1T参数MoE模型Large 4。该模型支持百万上下文,含49B活跃参数,具备多模态能力。其双重稀疏设计提升效率,在网络安全基准测试中表现优异,以开放权重形式提供多种格式版本。
共 14 篇相关文章
Mistral发布1T参数MoE模型Large 4。该模型支持百万上下文,含49B活跃参数,具备多模态能力。其双重稀疏设计提升效率,在网络安全基准测试中表现优异,以开放权重形式提供多种格式版本。
Recursive发布开源编码模型Flint,专为本地运行设计。该MoE模型总参数400亿,推理仅激活250亿,在M4 Pro芯片上生成速度达131 token/s,约为同类模型两倍,支持开发者免费获取以保护代码隐私。
DeepSeek发布V4.1 Flash快照,基于CED架构。其采用不对称激活策略,输入端8B、输出端16B参数,配合压缩KV缓存将内存占用降至前代四分之一,主打编码及代理场景的高性价比。
Reflection发布501B参数开源模型Beam,采用MoE架构且每token仅激活23B参数。该模型支持1M上下文窗口及Apache 2.0许可证,主要面向编码与代理场景,并提供多种推理强度选项。
Meta开源816B参数多模态模型Muse Spark Open。该模型采用MoE架构,支持文本、图像等输入及百万上下文,专为代理编码任务优化,推理速度接近42B参数模型。
Liquid AI发布LFM2.5-24B-A2B端侧推理模型。该MoE架构每Token仅激活2B参数,在Apple M5 Max上达184 tokens/秒,部分基准表现优于更大总参数量模型。
Mistral发布万亿参数开放模型Large 4。该模型采用MoE架构,运行时仅激活约49亿参数,可在8路高端GPU集群部署。作为欧洲主权AI成果,其性能在非中国开源模型中领先,预计一个月内开放下载。
Reflection推出501B参数MoE模型Beam,主打编码与代理任务。该模型推理仅激活23亿参数,基于23.8万亿token预训练及大规模强化学习,性能逼近前沿开源模型,计划本月晚些时候开放权重。
Kolibri主权大模型开源,78B参数支持1M上下文。该MoE架构单次激活仅3B参数,专为受监管领域设计,在双语环境下实现质量与成本帕累托最优,并采用Apache 2.0许可证发布。
Redis创始人antirez开源ds4,支持本地运行超大MoE模型。通过不对称2-bit量化与KV缓存磁盘化,让DeepSeek V4等模型在128GB内存设备上实现高效推理。
Ai2发布Olmo-core 3,将MoE训练扩展至万亿参数。新框架重构训练堆栈,在8台B300 GPU上使47亿参数模型吞吐量提升约2.7倍,有效解决大规模稀疏模型的效率瓶颈。
H Company发布Holo4代理模型系列。该系列含27B稠密及35B-A3B MoE两种规格,支持GUI、代码等多接口交互。在OSWorld 2.0基准中,27B版本得分61.7%,以更低成本实现接近前沿模型的性能。
AI代币成本正以每年数个数量级的速度骤降,大模型预计一至两年内将整合进计算各层面成为基础设施。GPU能效约每两年翻一番,叠加推理引擎优化,同等质量下任务成本大幅降低,瓶颈转向质量与访问权限。
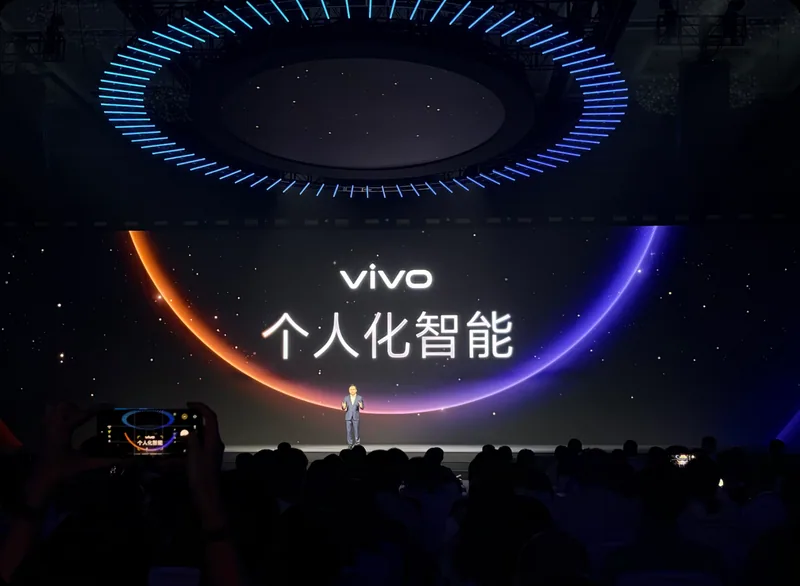
vivo高管详解AI Phone新架构。30B MoE模型借按需调度将内存占用压至2-4GB,预计2028年成熟;系统引入Harness执行中枢,让端侧大模型从单点功能升级为具备长期上下文理解的个人化智能。