华为麒麟 9050 Pro 采用类 3D V-Cache 堆叠设计,实测性能表现强劲
科技媒体极客湾(Geekerwan)近日发布了针对华为 Mate 90 Pro Max 所搭载的麒麟 9050 Pro SoC 的深度拆解报告。通过物理切割与 3D 重建技术,实验室揭示了该芯片内部独特的双裸片堆叠架构。
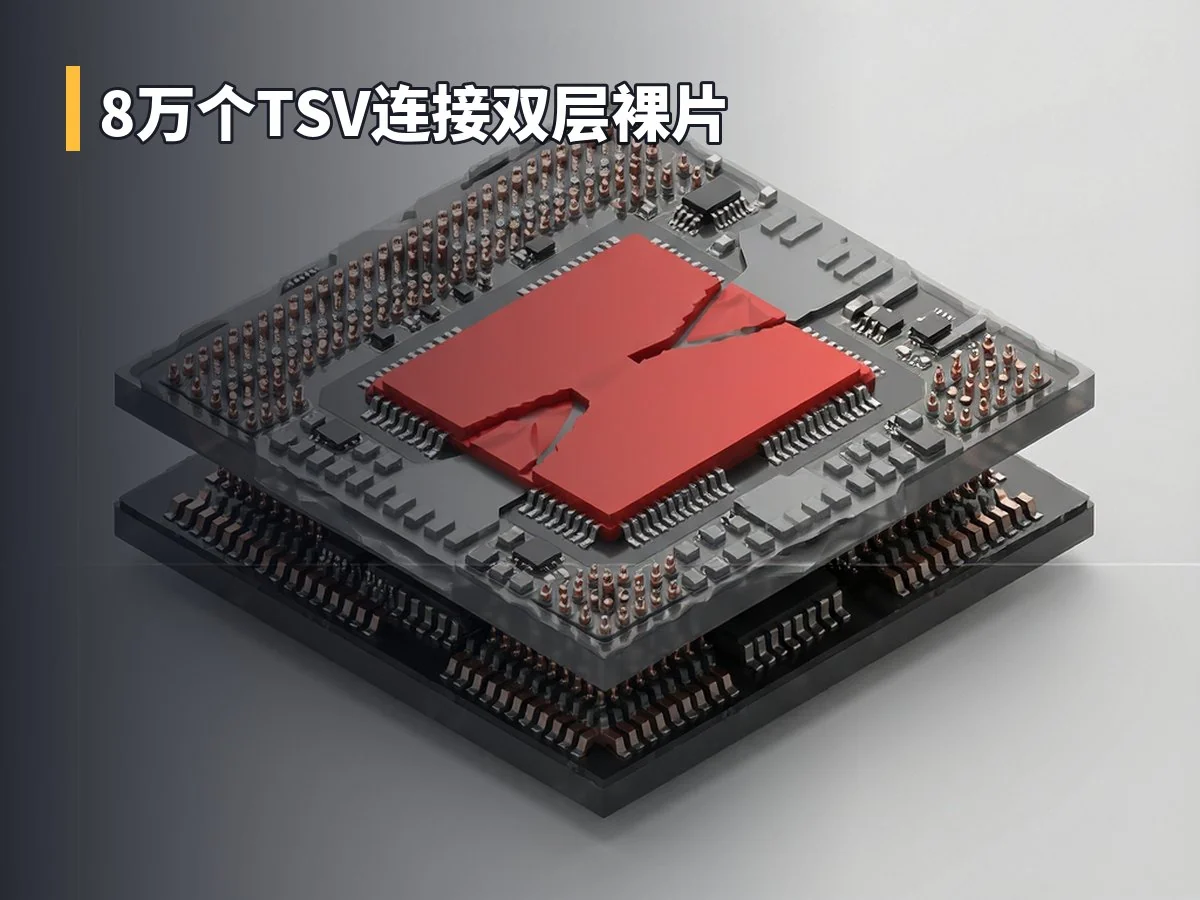
与传统单逻辑层、金属层及基板的常规 SoC 结构不同,麒麟 9050 Pro 采用了两个堆叠的裸片(Die),并通过铜-铜混合键合技术连接两者的金属层。在制程方面,计算模块位于 SMIC N+3 节点上制造,其工艺水平大致相当于其他代工厂的 6nm 级节点;而承载缓存、I/O 接口和 PLL 的第二模块则基于 SMIC N+2 节点制造,约等于台积电 N6 工艺。目前,华为与中芯国际均未直接确认具体的节点名称。
电源与信号传输依赖于硅通孔(TSV)技术。据极客湾统计,约有 80,000 个 TSV 将上下两层芯片连接至基板。这些 TSV 穿透下层裸片直达上层裸片,其禁布区占用了底部裸片约 8% 的可用面积。
LogicFolding 架构:类似 AMD 3D V-Cache 但更复杂
这一设计理念与 AMD 的 3D V-Cache 相似,即在独立的粘接模块上放置缓存。然而,麒麟 9050 Pro 的混合键合密度更高,旨在缩短执行单元与缓存之间的物理路径,从而降低延迟。
华为采用的“LogicFolding”技术并非简单地将功能块整体分配至某一模块,而是让每个主要功能块跨越两个模块分布。拆解显示,在主核心中,大多数执行单元位于顶部模块,而 L1 和 L2 缓存则位于底部模块,直接置于负载/存储单元下方。GPU、ISP、NPU 和调制解调器也遵循类似的跨模块布局。这种设计利用较短的互连距离来减少延迟,并允许在相同时钟频率下降低电压。此外,由于缓存、I/O 接口和 PLL 运行温度较低且对工艺敏感度不高,因此被放置在底层;而发热量较大的计算块则置于顶层,以获得更好的散热效果。
NPU 算力提升显著,支持端侧大模型
此次升级幅度最大的是 NPU 部分。两个模块的总面积比前代麒麟 9030 Pro 增加了 150%。在使用 3B 参数模型进行测试时,极客湾测得 INT8 吞吐量为 68 TOPS,预填充速度提升了三倍。
搭载该芯片的手机支持设备端运行 30B-A2B 混合专家模型(总参数 30B,激活参数 2B)。该模型用于离线照片组织、编辑建议以及为华为 AI 助理提供动力,并与一个 6B 的多模态模型配合使用。作为对比,苹果使用的端侧模型为 20B-A4B。由于所有麒麟 9050 Pro 手机均配备 16GB RAM,华为能够将更大的模型放入高速内存中,尽管其单次激活的参数数量少于苹果的解决方案。
游戏性能接近旗舰竞品,受限于系统适配
在游戏实测中,极客湾指出华为 Mate 90 Pro Max 在《原神》中的表现优于部分搭载骁龙 8 Elite Gen 5 的手机,仅略低于搭载骁龙 8 Elite Extreme Gen 6 和苹果 A19 Pro 的设备。在《崩坏:星穹铁道》中,该芯片领先于天玑 9500 机型。在《绝区零》测试中,其帧率几乎追平天玑 9500 和骁龙 8 Elite 安卓手机,尽管后者的分辨率设置略高。
需要注意的是,最终结果很大程度上取决于游戏向 HarmonyOS 的移植质量。对于需要通过翻译层运行的标题,例如《明日方舟:终末地》,其运行效率相对较低,帧率表现也受到一定影响。