即便在明令禁止的情况下,研究人员仍难以完全摆脱对人工智能工具的依赖。一项针对顶级机器学习会议的实证研究显示,限制使用大语言模型(LLM)进行同行评审,并未显著改变论文的录用结果或评审质量。
实验背景与政策对比
这项大规模随机实验由 Microsoft Research 的计算机科学家团队主导,于 2026 年 7 月在韩国首尔举行的国际机器学习会议(ICML)期间开展。作为全球最大的人工智能学术会议之一,该届会议共收到约 24,661 篇论文投稿,涉及 17,886 名审稿人。
研究团队将审稿人分为两组,分别执行不同的评审政策:
- 保守政策组:完全禁止使用大型语言模型辅助评估论文。
- 宽容政策组:允许使用 LLM 帮助理解论文内容、检查相关工作以及润色写作风格,但严禁利用 AI 判断论文优劣或直接起草评论意见。
评审结果差异微乎其微
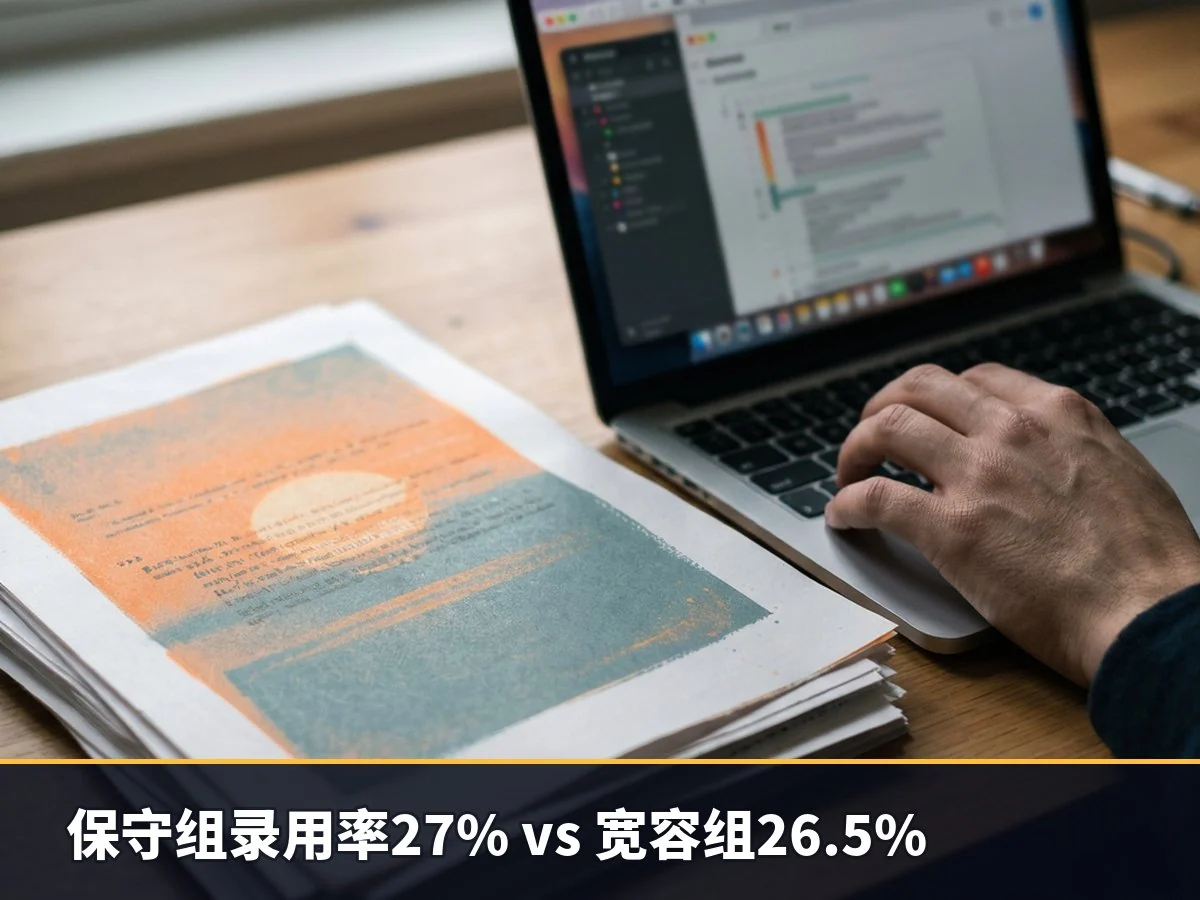
数据显示,两种政策下的最终录用率几乎持平。在严格的“保守政策”下,论文接受率为 27%;而在“宽容政策”下,这一比例为 26.5%。平均评审分数同样相差无几,分别为 3.31 分和 3.32 分。此外,审稿人在两种模式下的信心水平也未出现明显波动。
尽管依据“宽容政策”撰写的评论长度增加了约 5.5% 至 7%,且专家评价其质量略高,但在对每位评论员进行个体比较时,并未发现具有统计学意义的显著差异。
合规性挑战:近四分之一审稿人违规
为何政策差异未能带来显著影响?一项涵盖 1,486 名参与者的匿名调查揭示了原因。在被告知不得使用人工智能的“保守政策”组中,有 22.5% 的审稿人承认他们实际上仍然使用了 LLM。
Microsoft Research 科学家、同时也是会议组织者的 Miro Dudík 表示:“23% 的自我报告不合规率绝对高于我的预期。”
调查显示,违规使用 AI 的目的包括构思反驳观点、起草审查文本、阅读并总结论文优缺点等。审稿人违反规则的主要诱因包括庞大的评审工作量以及规则界定不够清晰。
英国沃尔弗汉普顿大学学者 Kayvan Kousha 指出:“这项研究表明,在同行评审中禁止使用人工智能极难执行。由于学术界普遍存在的工作压力,人们很难抵御使用 AI 带来的诱惑。”
AI 检测器的局限性
为了进一步验证审稿人的自报行为,研究人员使用 AI 文本检测器 Pangram 对提交的评论进行了分析。尽管研究者警告此类检测工具并非完美无缺,但结果显示,在“保守政策”组中,仅有 52.2% 的评论被归类为完全由人类撰写。这意味着即使在被禁止的情况下,仍有相当比例的评审内容可能借助了 AI 生成。
Microsoft Research 研究员 Kim Sunnie S 认为,这项工作不仅对计算机科学领域的其他会议具有参考价值,也可能为面临类似挑战的其他学科领域提供启示。
相关研究已发表于 arXiv,DOI: 10.48550/arXiv.2609.19420。