当一百万退伍军人通过美国退伍军人事务部的“百万退伍军人计划”分享其遗传数据时,美国能源部阿贡国家实验室(Argonne National Laboratory)数据科学与学习部门的高级科学家 Ravi Madduri 并未感到惊讶。他深知这些数据的捐赠条件:即便将一切献给国家,捐赠者往往愿意付出更多且不求回报。这份礼物构成了美国最大的生物样本库,也是世界上祖先多样性最丰富的退伍军人数据集。
Madduri 表示:“当我看到这些数据时,我觉得我有义务实现退伍军人的初衷。”这种初衷意味着无论身份如何,所有人都能从这些数据中获益。“我们不能拖延。”自 2001 年以研究生身份加入阿贡以来,Madduri 在过去二十年中一直深耕于超级计算与生物医学的交叉领域。他指出,虽然硬件机器已基本完成既定任务,但在宝贵数据与最终成果之间存在的障碍,并不总能通过更快的计算机来解决。理解这些挑战是通往更优科学路径的关键。
任何两个人类基因组在数百万个特定位置上存在差异。全基因组关联研究(GWAS)旨在从海量数据中回答一个看似简单的问题:特定的基因变异是否与某种疾病相关?然而,当这一测试扩展到每一个值得研究的变体以及病历中记录的每一种病情时,它便演变成了一个巨大的数学难题。核心问题在于代码是否真正适配了硬件性能。
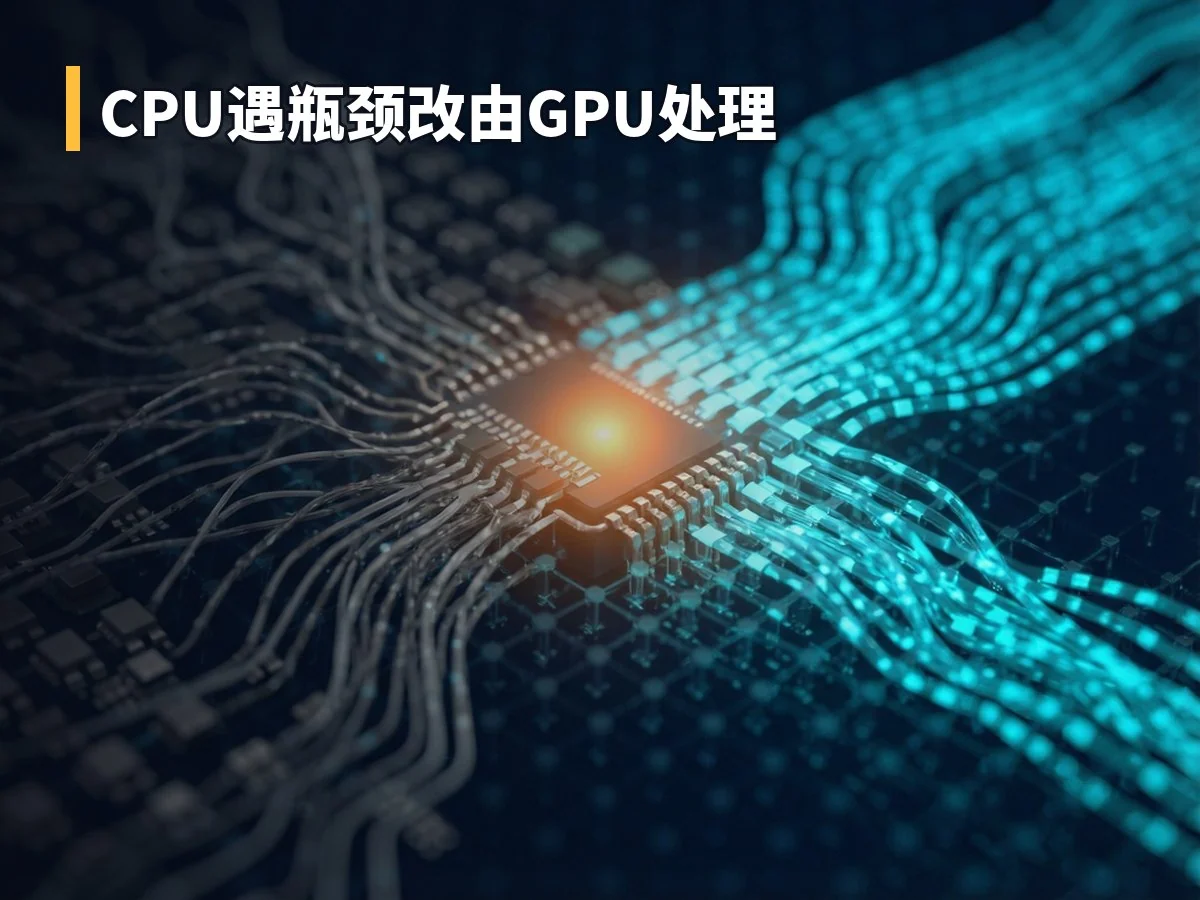
Madduri 的团队在美国能源部的橡树岭领导计算设施(OLCF)的 Summit 系统以及阿贡领导计算设施的 Aurora 系统上运行了这一分析。在 Summit 系统上,团队发现 CPU 无法胜任这项工作。随着队列增长,每个组所需的分析矩阵超出了内存容量。Madduri 回忆道:“我们决定打开黑盒,检查代码。”他们发现,瓶颈不仅仅是速度问题,更是编码问题。由于遗传学界普遍使用通用处理器,原有算法是为 CPU 编写的。在底层逻辑中,代码花费几乎所有时间执行一项任务:乘以非常大的数字网格。这正是图形处理器(GPU)的设计初衷,也是现代人工智能训练引擎的核心能力。正如 Madduri 所指出的,加速 AI 发现的同一套计算架构,也为人口基因组学奠定了基础。
因此,由阿贡的 Alex Rodriguez 领导的团队对部分代码进行了 GPU 重写。原本需要约 481,000 个 CPU 核心小时的分析工作变得可处理。这次转换不仅加速了一项缓慢的工作,更使原本几乎不可能完成的任务成为可能。该团队将广泛使用的基因组件 SAIGE 改编为 SAIGE-GPU,并在《生物信息学》(Bioinformatics)期刊的另一篇文章中对此进行了描述。“我们不擅长起名字,很抱歉。”Madduri 调侃道。
在 SAIGE-GPU 出现之前,几乎所有的全基因组关联研究都始于选择一种特定疾病。Madduri 直言不讳地指出了这种方法的代价。