Reddit 用户 markpronkin(以下简称 OP)近日分享了一则极具性价比的硬件改造案例:他以约 35 美元(折合 3,000 卢布)的价格,从一位卖家手中购得一台曾在车库闲置多年的旧加密货币矿机。尽管该设备外观锈迹斑斑,且卖家拒绝在交易前进行通电测试,但 OP 最终成功激活了其中的九块 Nvidia P106-100 GPU,获得了总计 54GB 的显存资源。
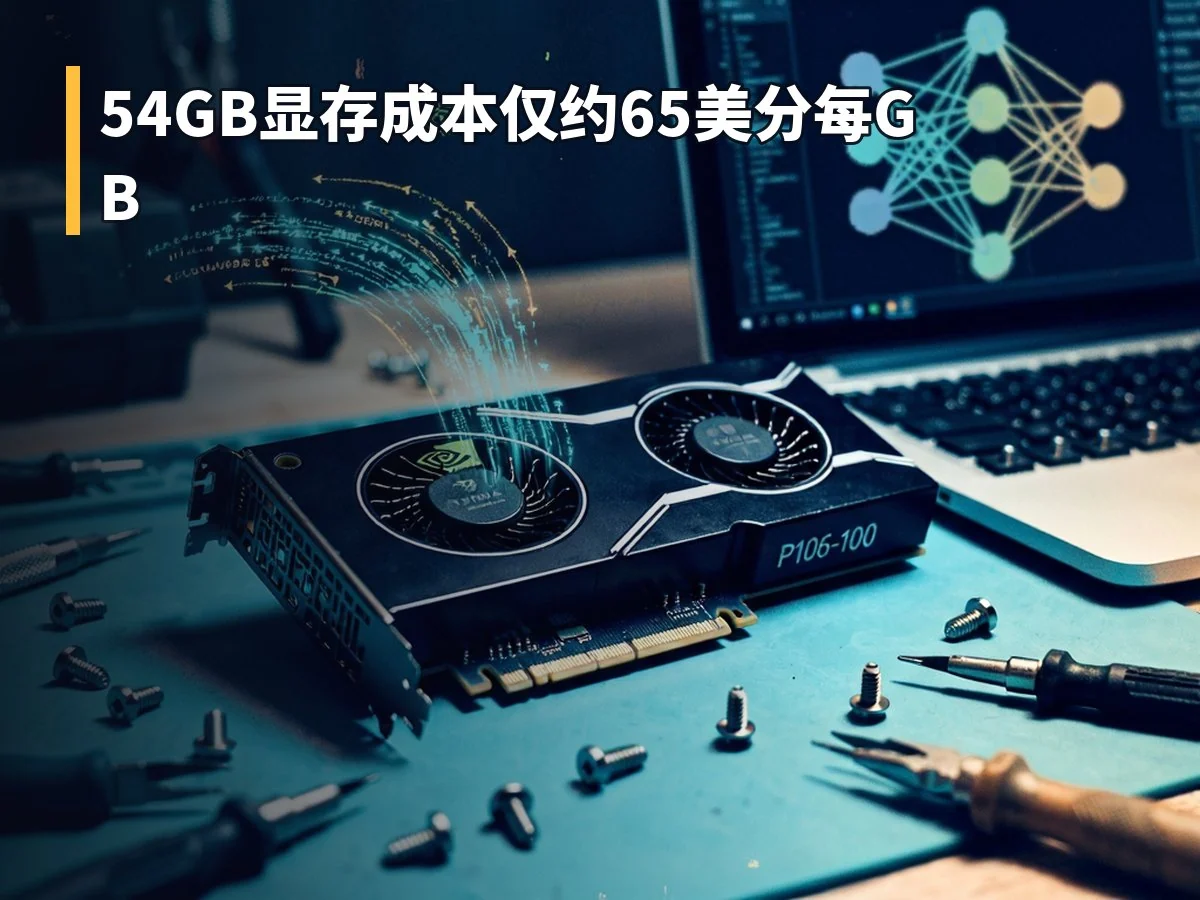
54GB 的 Vram 为 35$
据 OP 介绍,这台矿机是卖家数年前购入并长期搁置在潮湿车库中的产物。由于无法确定设备能否正常工作,OP 曾提议支付更高费用以获取测试机会,但遭到卖家拒绝。考虑到 35 美元的风险成本较低,OP 决定直接购买。虽然原主机搭载的 Celeron CPU 性能较弱且系统内存不足,难以发挥全部算力,但这并未阻碍后续对 GPU 部分的利用。
Pascal 架构显卡与本地大模型运行表现
该矿机核心组件为九张 Nvidia P106-100 专用挖矿显卡。这些显卡基于 Pascal 架构,单卡配备 6GB GDDR5 显存,其规格大致相当于 GTX 1060 6GB 版本。技嘉(Gigabyte)版本的 P106-100 显存频率为 8,008 MHz,位宽为 192-bit,单卡带宽约为 192 GB/s。该系列硬件最早于 2017 年中旬推出。
值得注意的是,Nvidia 已在 CUDA 13.0 中移除了对计算能力低于 7.5 的 GPU(包括 Pascal 架构)的离线编译支持,驱动分支 580 成为最后一个支持此类旧架构的版本,不过官方承诺安全更新将维持至 2028 年 10 月。
在初步测试中,OP 使用 Ollama 平台成功运行了阿里巴巴 Qwen 团队的混合专家模型 Qwen3.6-35B-A3B。该模型总参数为 350 亿,激活参数为 30 亿,下载体积约 24GB。在未进行深度优化的情况下,推理速度超过每秒 30 个 token。另一位评论者指出,这种性能表现通常仅见于高端 CPU 方案,而 OP 强调这是在仅花费 35 美元的二手设备上实现的。对于非 MoE(混合专家)架构的密集模型如 Qwen3.8-27B,受限于 PCIe 2.0 x1 插槽带宽及显存容量,可能无法顺利运行;但任何能完全装入 VRAM 的 MoE 模型均具备可行性。
显存容量限制与理论性能瓶颈
尽管拥有 54GB 总显存,系统仍面临特定限制。例如,8-bit 量化下的 Qwen3.6-35B-A3B 需占用约 36.9GB 空间,而 4-bit 量化的 Llama 3.3 70B 模型则需约 42.5GB。若采用 5-bit 量化,Llama 3.3 70B 的占用略低于 50GB,剩余空间极为有限。更大的模型可能因显存溢出而无法加载。
此外,即使是 4-bit 的 Llama 70B 模型,其生成速度也可能受限。理论上,每个 token 的生成需要读取所有 42.5GB 权重数据,受限于单卡 192 GB/s 的带宽,速度天花板约为每秒 4.5 个 token。因此,MoE 模型因其稀疏激活特性,成为此类多卡低带宽配置下的最佳选择。
成本效益分析与未来升级计划
从单位成本来看,此次交易每 GB 显存的代价仅为约 65 美分。作为对比,2025 年初发布的 RTX 5090 售价高达 1,999 美元,虽拥有 32GB 显存和 1,792 GB/s 的高带宽,但其单卡带宽约为 P106-100 的九倍。目前市场上,纯计算用途的 P106 显卡价格通常仅为对应 GTX 产品的一半左右。据评论员估算,这九张卡的总 TDP 功耗约为 1,080 瓦。
鉴于设备已成功点亮,OP 计划下一步将 GPU 迁移至更强大的外部扩展坞,搭配 i7-7700K CPU 和 32GB RAM 使用。该扩展坞支持最多 12 个 GPU,若再增购三张 P106-100,总显存容量可提升至 72GB。OP 向 WiredEntrepreneur 表示,这一方案的核心吸引力在于无限的使用权和数据隐私保护。通过重新利用二手硬件构建自主托管的 AI 解决方案,不仅成本低廉,也为爱好者提供了更高的自由度——更多的 VRAM 意味着更多的可能性。