VPN 在 AI 交互中的隐私边界:能隐藏什么,不能保护什么
使用 VPN 可以掩盖用户的地理位置以及互联网服务提供商(ISP)可见的连接信息,但这并不等同于全面的隐私保护。即便部署了顶级 VPN 服务,也无法阻止 OpenAI 或 Anthropic 等人工智能公司读取、存储并利用用户输入的内容进行模型训练。
聊天机器人可获取的数据与 VPN 的实际作用
在未启用 VPN 的情况下,OpenAI(ChatGPT)和 Anthropic(Claude)通常能够识别用户的连接特征。IP 地址会暴露大致地理位置,同时平台还能收集设备元数据,包括浏览器类型、操作系统版本及独特的设备标识符。
根据 OpenAI 的隐私政策,其收集的数据范围涵盖 IP 地址、包含唯一标识符的设备信息、Cookie 数据、电子邮件地址及支付信息。Anthropic 的政策同样涉及位置信息、连接细节及设备使用模式,尤其在移动应用端更为明显。尽管两家公司的条款措辞不同,但结果一致:它们均能掌握用户的大致位置及接入终端类型。
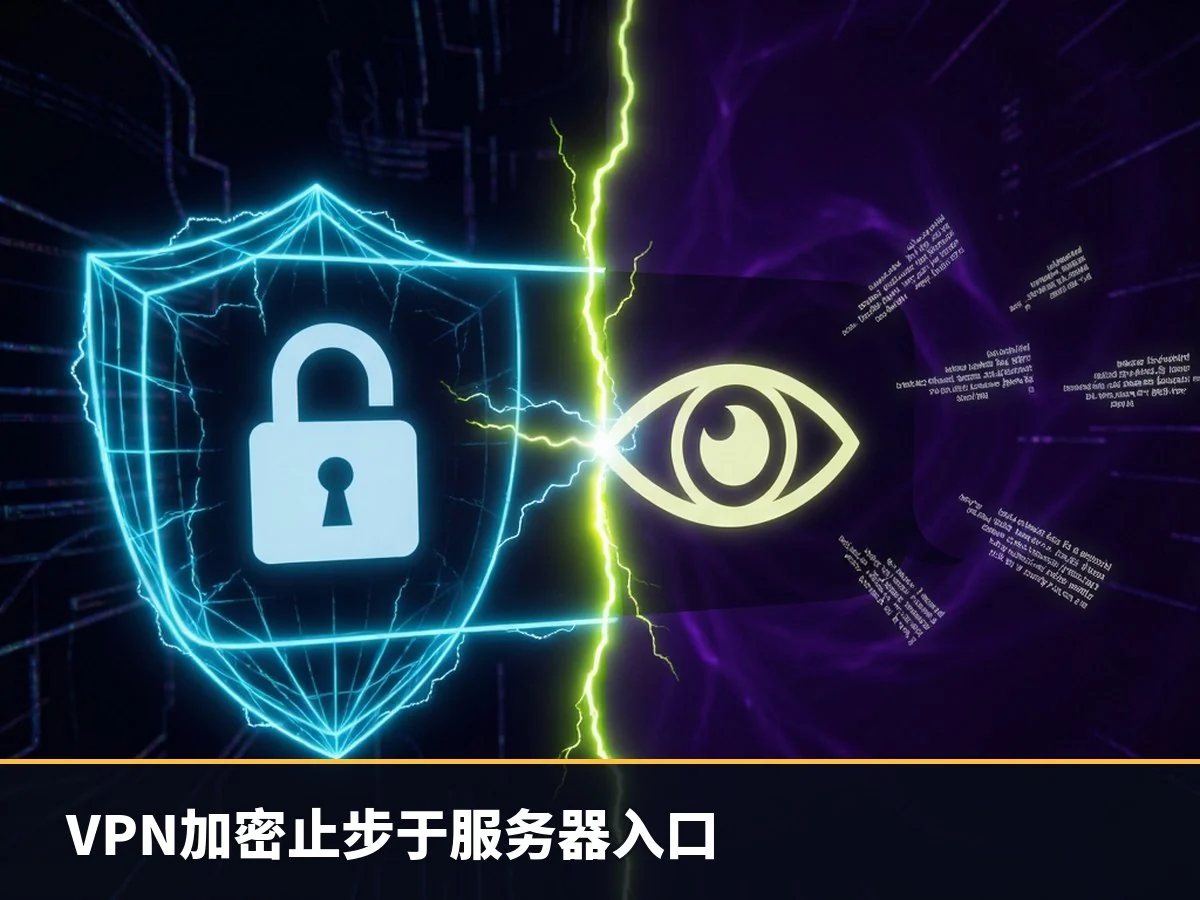
VPN 在此场景下仅发挥部分作用。它能有效隐藏真实 IP 地址并对传输流量进行加密,但这种保护止步于 VPN 服务器出口。一旦数据到达 AI 服务商的服务器入口,加密隧道结束,AI 公司仍可完整接收并处理所有传入数据。
加密技术的局限性:无法遮蔽的核心内容
这是常被忽视的关键技术限制:当用户提示词抵达 OpenAI 或 Anthropic 服务器时,VPN 提供的保护即刻失效。为了让人工智能模型进行处理,数据必须被解密。此时,用户的原始文本已完全暴露在服务商系统中。
无论 VPN 隧道多么坚固,以下信息均无法通过加密手段向 AI 公司隐藏:提示词的具体内容、上传的文件或图像、账户详细信息、对话历史记录以及支付凭证。VPN 仅保障了用户与服务端之间的传输链路安全,而非服务端内部的数据可见性。
数据留存机制与隐私控制选项
目前,大多数面向消费者的聊天机器人默认无限期保存对话记录,并可能将其用于后续模型训练。用户需手动调整设置以删除聊天记录。
针对 ChatGPT,除非用户主动选择退出,否则 OpenAI 可能会利用用户内容改进服务。即使关闭该选项,出于安全和法律合规要求,聊天数据仍可能被存储。对于 Claude,Anthropic 要求所有消费者用户明确授权是否将聊天数据用于训练。若启用,数据保留期可达 5 年;若拒绝,则保留期为 30 天。
用户可通过账户设置随时禁用数据训练功能,或利用“临时聊天”(ChatGPT)及“隐藏模式”(Claude)确保对话不进入历史保存列表。此外,付费商业层级的默认隐私协议通常比免费层级更为严格。
结论与建议:优先保护隐私的策略
VPN 是网络安全的基础措施,主要用于隐藏位置信息并防止 ISP 窥探,但它无法阻止 AI 公司读取、记忆并从用户提示中学习。若高度重视隐私,建议采取以下措施:在 ChatGPT 和 Claude 中关闭数据训练选项,使用临时聊天或隐藏模式,并避免在对话中共享敏感个人信息。
对于追求更高私密性的用户,可考虑 Proton AG 推出的 Lumo。该服务采用零访问加密技术,仅用户本人可解密保存的对话,且服务器端不留存明文记录。Lumo 运行于欧洲基础设施之上,遵循 GDPR 及瑞士隐私法标准。另一种方案是通过 Ollama 或 LM Studio 等工具,在本地离线运行开源大语言模型。