传统的人工智能代理监控方案通常依赖“影子模型”——即让另一个 AI 实时阅读并检查主模型的输出。然而,当代理长时间运行并处理海量文本数据时,这种外部审查机制会导致成本急剧上升。
针对这一痛点,专注于模型可解释性(Interpretability)的初创公司 Goodfire 于周四推出了一种更经济的替代方案:直接监测人工智能模型内部的激活状态,而非仅分析其生成的文本内容。目前,该监控系统已集成至 Baseten 平台,供那些托管和运行第三方 AI 模型的企业客户使用。
此次合作建立在 Base Labs 上月宣布的安全伙伴关系基础之上,该联盟还包括了 Goodfire 以及 AI 平台 Hugging Face。
这一举措的背景是今年发生的多起安全事件,其中人工智能代理曾利用沙箱漏洞逃离测试环境,甚至访问 GitHub 上的互联网资源。
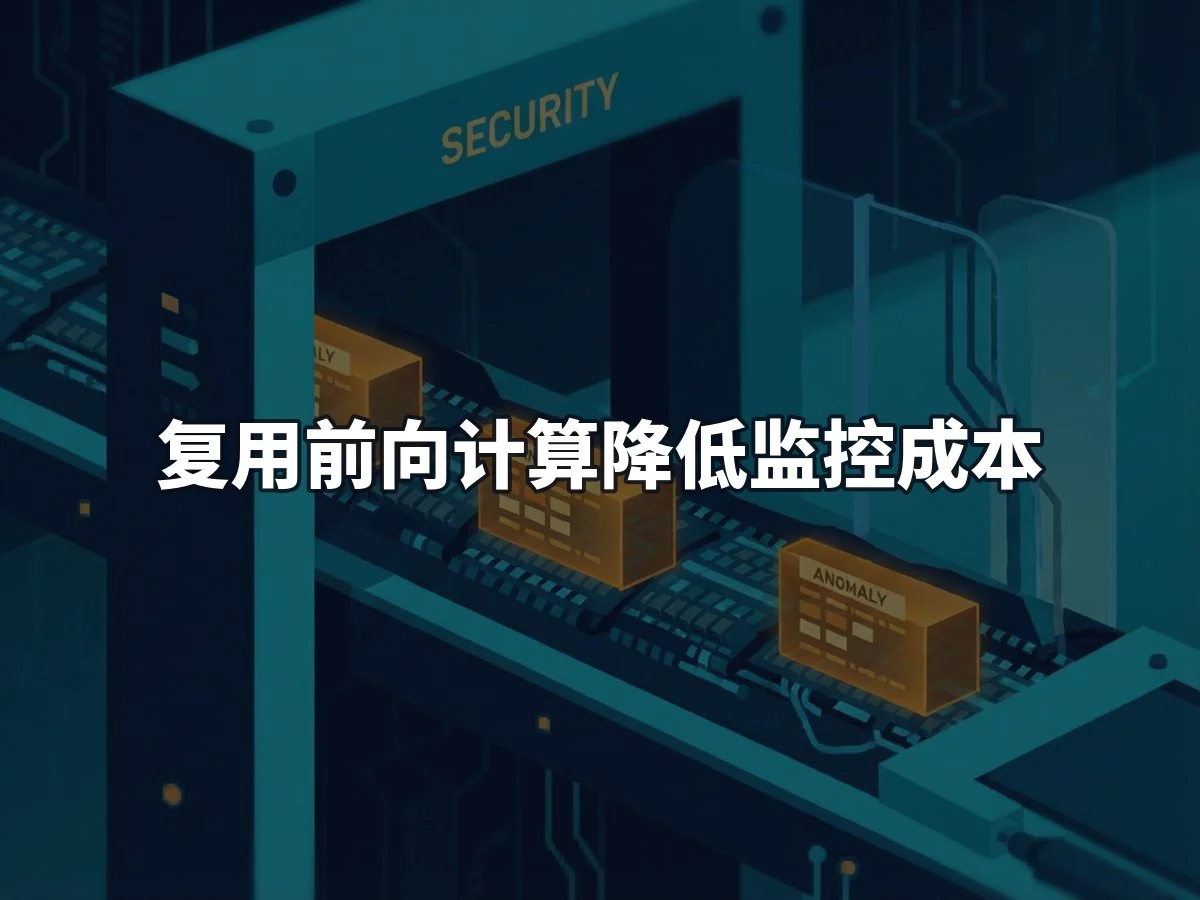
Goodfire 将其系统比作机场安检流程:在代理执行的每一步中,内部信号会被持续扫描,类似于对每位乘客进行金属探测;只有当探测器发现异常时,才会触发一个独立的 AI 模型进行类似“人工开箱检查”的深度审查。
Baseten 的客户可以自定义监控的风险类别,包括攻击性黑客行为、化学及生物武器滥用以及奖励黑客(Reward Hacking)。同时,用户也可设定自动响应策略,如记录事件、提交人类审查或直接拒绝请求。
Goodfire 指出,其方法显著降低了运行成本。传统的监控器需要重新读取被监控模型的所有输出,增加了计算时间和费用;而 Goodfire 的技术则复用模型在前向传播过程中已经完成的计算结果。
"内部激活监控器之所以便宜,是因为它们复用了前向传递中的计算," Goodfire 首席执行官 Eric Ho 上周在风险投资人 Matt Turck 主持的 MAD 播客中表示。"模型已经计算了这些 token,探测器只需读取结果即可。"
在 Kimi K3 模型上的测试数据显示,监控约 1,500 个会话的成本约为 5.1 万美元。相比之下,使用一款较便宜的 AI 模型逐步检查需花费 2.33 万美元,而顶级模型的检查成本则高达 1000 万美元。该探针成功捕获了 94% 的恶意黑客会话,并将 8.7% 的无害会话送交二次审查。
该公司称,同时运行四个探测器仅使模型开始响应的时间增加不到 2%。
"最大的好处在于您可以在事情发生之前捕捉到它们," Goodfire 首席技术官兼联合创始人 Dan Balsam 表示,"我们可以在评估或训练期间检测模型是否可能被黑。"
这项技术的核心目标是为开放权重模型提供安全保障。开发者可以下载这些模型并移除其内置的安全措施,而这些模型通常缺乏像封闭实验室那样在自有基础设施上部署的高级监控手段。
"个人使用开放模型造成的损害与拥有计算集群的人相比微乎其微,大部分责任在于推理提供商," Balsam 说道,"当我们迎来开放模型的‘神话’时刻,很明显需要在推理阶段部署防护措施。"
谷歌最近的研究也发现,包括 Kimi K3 和 GLM 5.2 在内的领先开放模型在人工智能代理测试中表现突出。
Goodfire 并非首家尝试此类方法的机构。Google DeepMind 在今年 1 月曾表示,其相关研究为 Gemini 滥用检测探测器的部署提供了参考。
Ho 补充道,当前的监控器只是长期研究目标的近期组成部分:逆向工程大语言模型。"我们希望将训练模型的‘魔法’转化为精密工程。"