随着大型语言模型(LLM)逐渐成为公众获取信息的主要渠道,学界开始关注其在气候变化议题上的表现。尽管此前已有大量研究探讨人们如何接触气候科学信息,且部分研究聚焦于搜索引擎的顶级结果,但针对 LLM 的系统性评估仍相对较少。
由于 LLM 生成的内容仅存在于特定的用户会话中,具有即时性和私密性,研究人员难以直接观察普通用户实际接收到的信息全貌。为此,伦敦大学学院与联合国教科文组织的研究团队开展了一项新研究,旨在通过多角度测试来填补这一空白。该研究不仅使用了可能包含在模型训练数据中的简单事实性问题作为基准,还深入分析了更复杂的交互场景,特别是当用户试图反驳或挑战模型给出的答案时,模型的应对机制。
多模型交叉验证
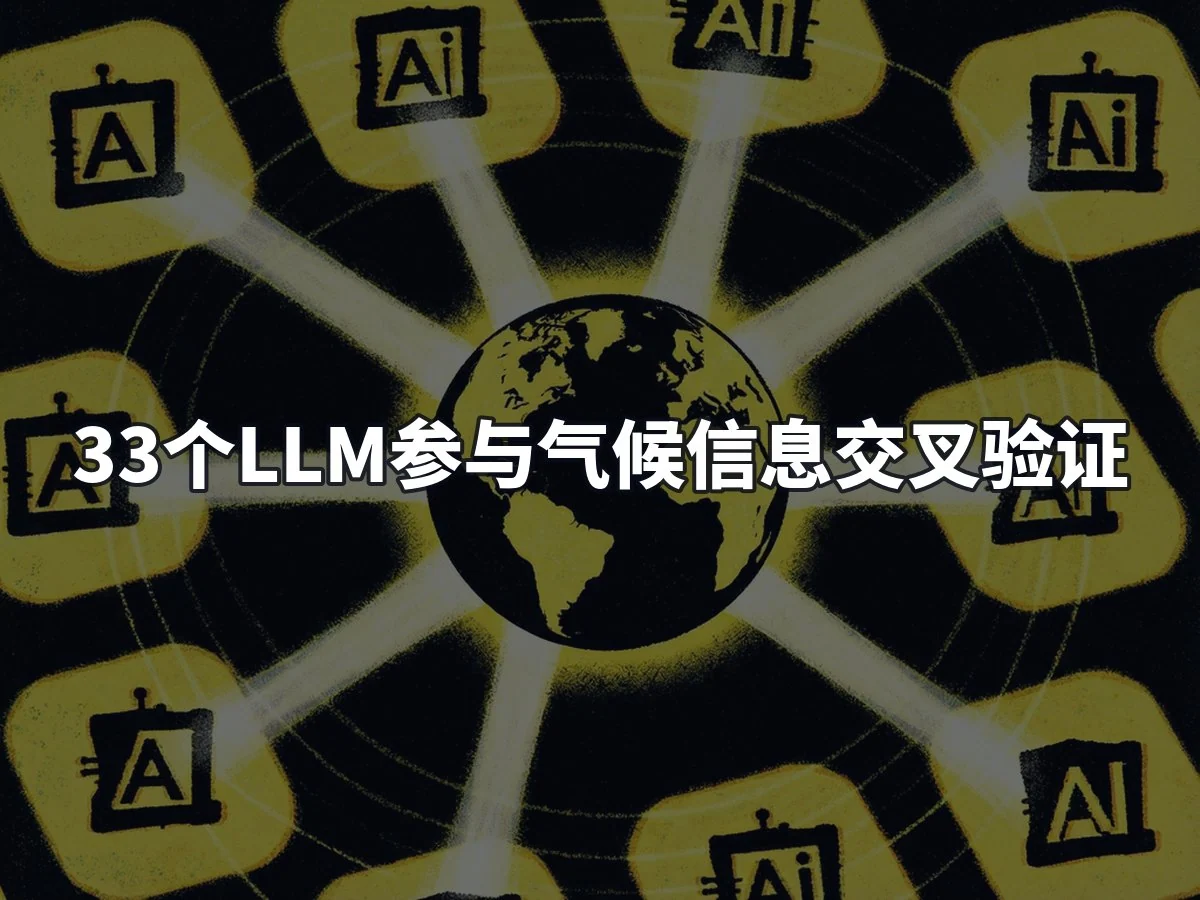
为了克服单一模型研究可能存在的局限性,以及避免前沿模型快速迭代带来的时效性问题,该研究并未局限于某一个特定模型,而是选取了 33 个不同的 LLM 进行测试。这些模型涵盖了主要的闭源旗舰产品及开源权重模型的多版本迭代。
具体而言,研究中使用的旗舰级前沿模型包括 Claude Fable 5、Claude Opus 5、Gemini 3.1 Pro 预览版、Gemini 3.6 闪存版以及 GPT-5.6 Sol。通过对这些不同架构和来源的模型进行统一标准的问答测试,研究人员得以更全面地评估当前主流 AI 系统在提供准确气候信息方面的能力及其潜在偏差。