2026 年 9 月 21 日
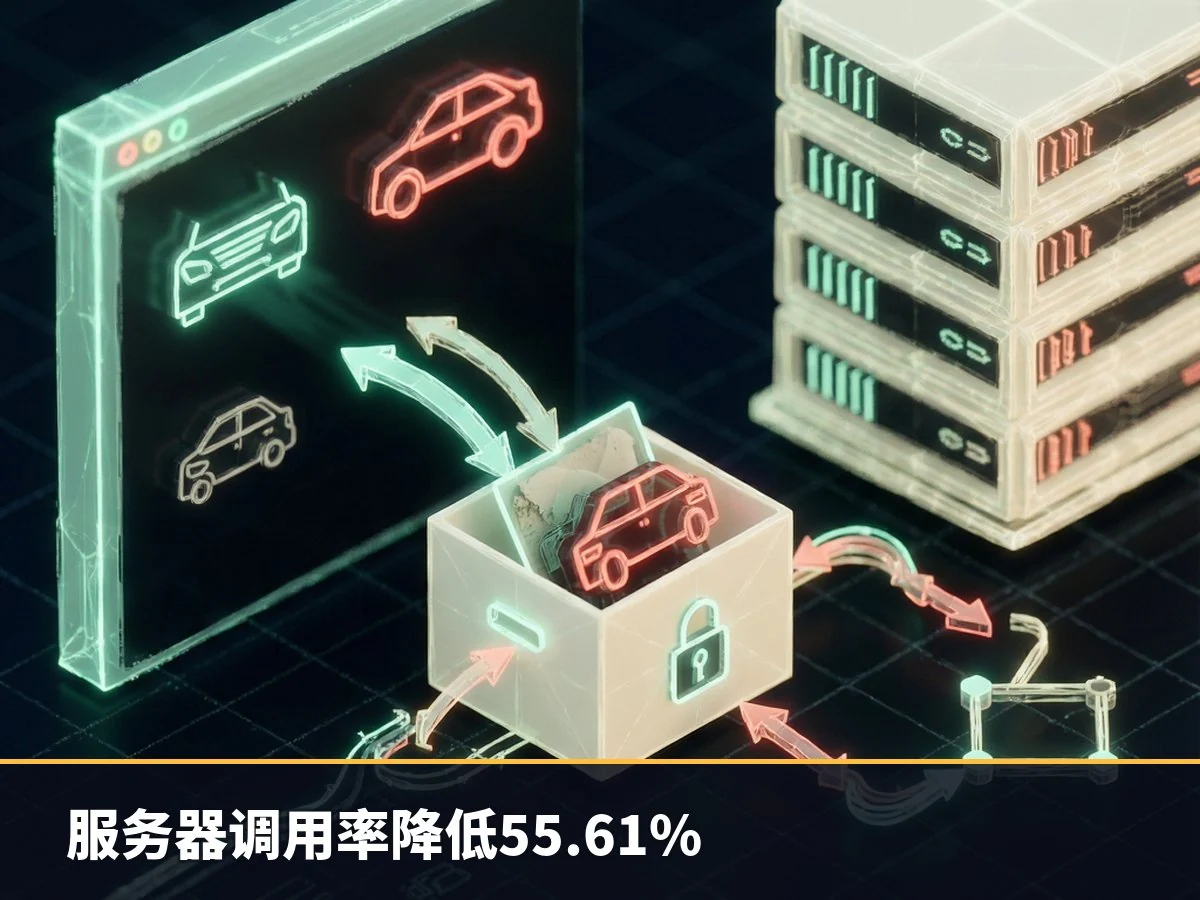
韩国先进科学与技术学院 (KAIST) 的研究团队近期公布了一项名为 CURE(累积知识再利用)的新人工智能技术。该技术旨在解决智能手机等终端设备上小型 AI 模型在处理复杂任务时依赖云端服务器的问题,通过让设备“记住”并复用过往的解决方案,显著降低了对服务器的调用频率。
打破“一次性求助”的低效循环
受限于处理能力和内存,智能手机通常运行轻量级的小型 AI 模型。这些模型虽然响应速度快,但在面对复杂或陌生的图像识别任务时,准确率往往不足。传统的解决方案是将数据发送至拥有强大算力的服务器端大型模型进行处理,但这会导致数据传输延迟、网络流量增加以及服务商运营成本上升。
现有的协作方法中,设备端模型虽会评估输入,但缺乏存储机制,导致每次遇到类似难题时仍需向服务器重新请求帮助。这好比学生解题时不记录过程,下次遇到同类题目仍需再次请教老师。KAIST 计算机学院 Jae-Gil Lee 教授领导的研究小组开发的 CURE 技术,正是为了将这些“一次性答案”转化为设备可长期复用的知识资产。
CURE 的工作机制:从独立判断到经验复用
CURE 采用了一种三级决策流程:
- 第一级:检查设备端模型是否能可靠地处理当前输入。
- 第二级:若无法直接处理,系统首先查阅存储在设备本地的、此前从服务器获取的知识库。
- 第三级:仅当本地知识库不足以解决问题时,才向服务器发起新的请求。
以汽车型号识别为例,当设备端模型无法识别照片中的车辆时,它会向服务器求助。CURE 不会简单地将结果丢弃,而是利用服务器的预测结果结合图像特征,更新设备的本地知识存储。值得注意的是,CURE 并不保存原始照片,而是提取并存储如车身形状、前灯设计等关键特征的摘要。这意味着,当设备后续遇到相似车型的照片时,即便从未见过完全相同的图片,也能凭借积累的“经验”在本地完成识别。
性能测试:服务器调用减少超五成,速度提升近三倍
研究团队使用视觉语言模型对 CURE 进行了验证。实验配置如下:
- 设备端模型:MobileCLIP2
- 服务器端模型:EVA-CLIP(拥有 180 亿参数)
参数是模型在训练过程中编码信息的数值,决定了其区分物体及识别关系的能力。在一系列图像分类数据集的测试中,CURE 展现了以下优势:
- 准确性:接近于将所有输入均发送至大型服务器模型的处理方式。
- 服务器调用率:相比不保留历史知识的设备-服务器协作基线,平均减少了 55.61%。
- 端到端速度:包含通信时间在内,CURE 的运行速度是非累积基线的 2.80 倍,是全量发送服务器方法的 3.67 倍。
Jae-Gil Lee 教授指出:“CURE 允许小型设备上的 AI 模型记住并重新使用已获得的知识,而不是反复向服务器提出同样的问题。”此外,该技术无需对设备端或服务器端的模型进行重新训练,只需添加一个独立的知识存储库,因此具备良好的通用性,可适配多种 AI 模型和服务架构。
应用前景与局限性
这项技术不仅适用于智能手机,对于计算资源受限且需实时感知环境的机器人和可穿戴设备同样具有价值。在网络连接缓慢或不稳定的场景下,机器人可利用本地积累的知识做出更多即时决策,减少对云端响应的等待。
然而,实际效果仍取决于具体设备的处理能力、存储空间、网络状况以及输入数据的特性。目前,针对不同设备和环境下的进一步测试仍在进行中。
相关研究成果已发表于《计算机科学讲座笔记》(Lecture Notes in Computer Science)。论文题为《CURE: Effective Device-Server Hybrid Inference with Cumulative Knowledge Reuse in Vision-Language Models》,作者包括 Youngjun Lee 等人。