AI 基础设施的隐忧:搜索与分析系统的割裂
人工智能(AI)表面上看似无缝衔接,但在底层基础设施中,数据处理正朝着不同方向分化。当提及 AI 基础设施时,业界往往聚焦于芯片、模型及其上层应用,却忽视了支撑这些应用的基石——负责数据检索与分析的系统。
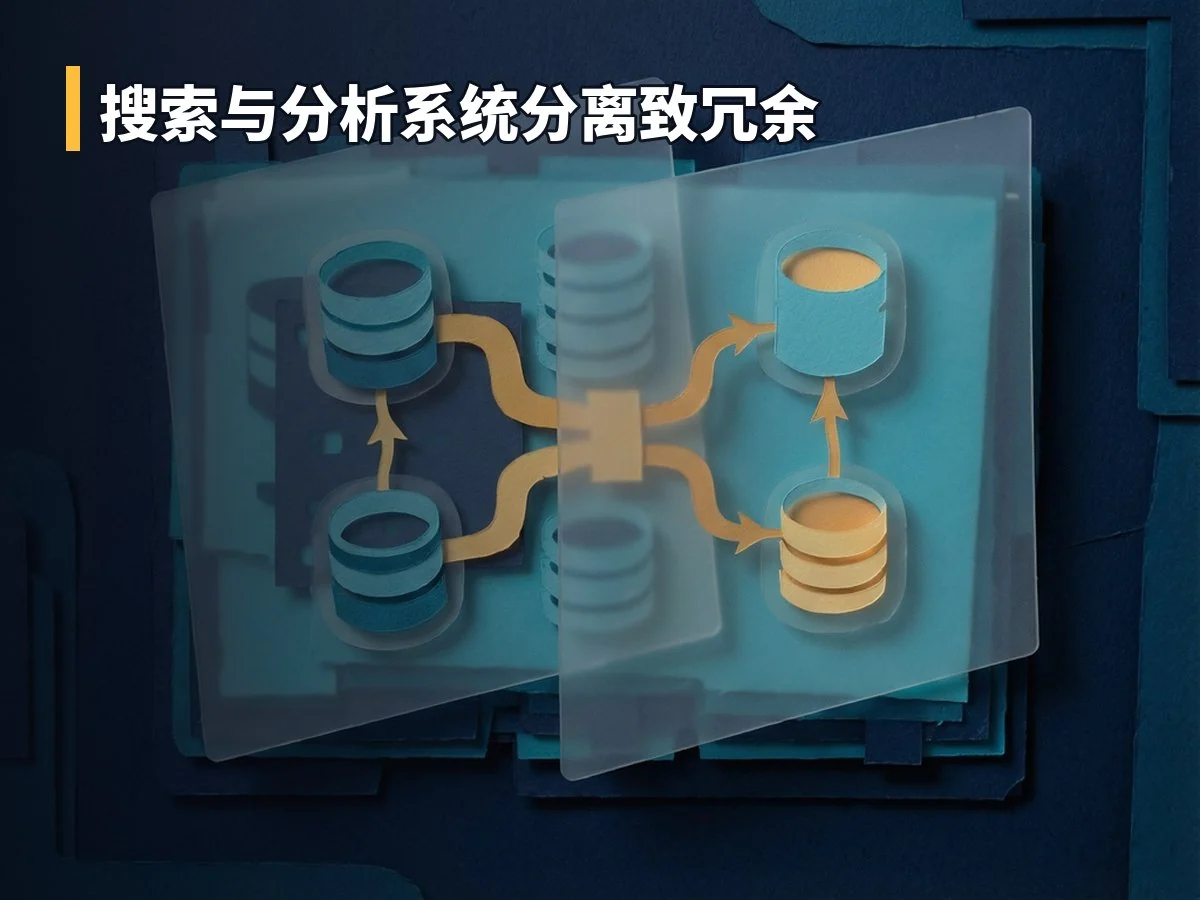
在许多企业架构中,搜索系统与分析数据库依然独立运行。前者用于从非结构化数据中定位信息,后者则负责计算、比较及模式识别。这种分离并非设计失误,而是为了适应早期的硬件限制和用户需求。然而,随着自然语言接口和 AI 代理的普及,这一架构缺陷日益凸显。
用户的一个普通提问,在底层可能被拆解为多次搜索、一次检索任务以及独立的分析查询。这并非 AI 技术本身造成的问题,但它使得传统基础设施的局限性变得难以忽视。
单一请求转化为多重负载
AI 代理在执行任务时,会将一个人类请求分解为多个较小的机器查询。代理可能分别搜索请求的不同部分,对结果进行排序,并评估证据是否充分以继续下一步。对于用户而言,这只是一次交互;但对于后端系统,这可能引发重复且密集的数据库操作。
部分请求仅需检索功能,而另一些则需要系统先找到证据再进行计算。当任务同时涉及两者时,搜索与分析系统的界限变得模糊:一个系统负责定位相关材料,另一个则需汇总数值或识别趋势。自然语言并不遵循数据库行业的分工逻辑,用户在询问同事时不会区分“查找文件”与“计算含义”,AI 代理同样如此,它们将单一意图转化为所需的搜索与计算序列。
即便在没有大规模并行 AI 代理群的情况下,额外的数据库活动已不容忽视。一个简单的提示词可能触发远超用户预期的后台工作量。系统间的每一次数据交换都会增加延迟、成本,并带来上下文丢失的风险。
搜索与分析的分立发展
搜索引擎旨在从杂乱的文本、日志和文档中提取相关信息,而分析数据库则专为处理结构化数据构建,擅长聚合大数据集、连接记录及计算平均值。这种分立在企业主要需求为单纯的信息查找时是合理的。
然而,当一个问题需要同时结合检索与分析时,挑战随之而来。搜索系统能识别出正确的文档,但往往需要另一种系统来处理其中的数字;分析工具能快速计算,但前提是用户已知晓相关数据的位置和结构。
为了弥合这一差距,企业不得不构建额外的数据副本、提取转换管道以及同步机制。向量搜索技术的引入又增加了一个专门的系统层。数据工程师花费大量时间维护这些管道,而这些工作本身并不直接创造业务价值。尽管部分产品试图融合搜索与分析功能,但许多企业仍在运行独立系统,并依赖复杂的基础设施将它们连接起来。
独立系统带来的隐性成本
维护独立的搜索和分析系统意味着支付高昂的数据冗余成本。随着源数据变化,搜索索引需不断更新,分析存储中可能存在相同信息的另一版本,向量搜索层则进一步增加了复杂性。每一个同步任务都需要监控,每一次数据交换都是潜在的数据过时点或性能瓶颈。
这些成本在 AI 代理增加查询量之前就已存在。AI 代理通过将一个用户操作转化为同一系统链中的多个操作,使得这些低效环节更加显眼且难以容忍。
开放格式改变经济模型
减少数据重复的一种有效途径是将基础数据存储在对象存储中,并采用开放格式。例如,数据可存放于 Amazon S3(Amazon Web Services 的对象存储服务),并以 Apache Parquet 文件格式存储,由 Apache Iceberg 组织成表格。
这种方法实现了存储与计算处理的解耦。搜索和分析工具可以基于相同的基础数据进行工作,而非在每个产品中保留完整副本。虽然索引和计算层仍然必要,某些特定工作负载也可能证明专用系统的合理性,但数据复制不再是默认选项。随着企业对数据存储位置控制力的增强,行业内的搜索与分析功能开始趋同。面对新工作负载时,企业可以利用现有基础数据,避免自动添加新的数据库、副本和管道。
代理规模化加剧压力
随着企业赋予 AI 代理更多职责,减少数据和管道重复的价值将进一步凸显。虽然庞大的并发代理群尚未成为日常生产现实,但代理已在改变数据库工作负载特征。一个自然语言请求可能演变为几个基本的数据库操作,且代理会连续重复此过程。
随着代理处理的工作量增加,查询量可能不再与员工人数挂钩,而是跟随软件活动增长。这种额外需求的早期迹象通常不是数据库崩溃,而是表现为排队、响应缓慢、停机、基础设施费用上升以及系统间管道压力的增加。企业无需等待代理群完全成熟即可审视数据层,因为现有的重复基础设施和运营成本已经存在,更多的智能体只会放大这些问题。
现状仍是最大竞争对手
更简化的数据层必须战胜企业熟悉且信任的现有基础设施。“遗留系统”常被视作贬义词,但实际上它代表了当前的稳定状态。现有系统之所以占主导地位,是因为它们曾成功解决了重要问题,且在许多场景下仍能良好运作。
企业不应仅因 AI 流行而拆除正在运行的基础设施,而应提出更务实的问题:有多少个完整系统包含相同数据的版本?有多少管道仅用于传输信息?回答一个结合非结构化证据与数字分析的问题需要多长时间?专家花费多少精力维持这条路径的运行?如果答案显示当前架构简单且经济,那么维持现状可能是合理的。但如果每个新的 AI 功能都需要另一个存储、另一个副本,那么重构便势在必行。
正如大象站在细腿上,上方的建筑越重,下方的支撑就越需要关注。然而,改变基础并不容易,因为没有任何竞争对手比“现状”更强大。