人工智能就绪数据的核心标准
对于企业而言,构建可靠的人工智能系统依赖于数据的可靠性与机器可访问性。数据产品通过提供必要的结构,确保人工智能代理能够有效地发现和使用企业数据。
人类员工在面对指标矛盾的仪表板时,通常能识别出模棱两可的情况并加以调整;然而,当人工智能代理遭遇类似的数据冲突时,往往会将错误规模化放大。因此,区分“模型可信任”与“破坏模型”的数据至关重要。这并非工程师的个人偏好,而是模型产生组织可支持结果的必要条件。
人工智能就绪的数据必须满足以下四个核心要求:
值得信赖:具备完整的治理与溯源能力
数据必须受到严格管理、具备可追溯性,并支持端到端的审计。这里的“值得信赖”超越了传统的数据目录或血缘图谱概念,意味着每一个被模型接触的数据集都必须携带其元数据信息:包括来源、最后验证时间、所有者以及经历的所有转换过程。
治理规则应与数据本身一同传播,而非孤立地存在于下游工具中。一旦治理与数据脱节,系统可能在无声中崩溃——例如,模型可能吸收了重新定义的领域、变更的政策或过时的数据源,从而生成自信但错误的答案。只有当监护链在推断过程中保持完好无损时,组织才能解释并支持模型产生的结果。
及时性:数据延迟需匹配决策周期
基于过时数据进行推理的人工智能系统并非真正的智能应用,而更像是一份昂贵的检查表。人工智能就绪的数据必须具备足够的新鲜度,以支撑相应的决策场景。
对于欺诈检测、库存再平衡或客户升级等操作型决策,数据需要极高的实时性;而对于市场规模评估或季度规划等战略型决策,每日或每周的更新节奏可能已足够。关键在于将数据延迟与决策所需的时效性相匹配。
语义一致性:建立统一的商业词汇
同一术语在不同系统中含义迥异,是人工智能项目失败最常见的原因之一。例如,“收入”这一术语在CRM系统中可能指代预订额,在财务仓库中指确认收入,而在数据湖中则可能代表总交易量。
缺乏共享语义层的模型会将这些不同定义视为同一事物,导致逻辑混乱。人工智能就绪的数据需要在数据层达成一致的通用商业词汇,这些定义应被记录和执行于底层架构中,而非仅在提示层进行临时修正。
机器可访问性:超越人类视角的结构化设计
大多数企业数据原本是为分析师设计的,他们依赖隐性知识来知道查看哪个表、如何连接组合以及不信任哪些字段。然而,人工智能代理并不具备这种制度性知识。
为了使数据对人工智能友好,它必须经过结构化处理,使机器能够自主发现数据、理解其代表的含义,并在无需人类干预的情况下获取正确的片段。在此过程中,数据的组织和展示架构与数据内容本身同等重要。
数据产品的优势:从原始数据到智能接口
那些已将数据结构化为“数据产品”的组织,正凭借复合优势进入人工智能时代。数据产品不仅仅是一个干净的数据集,它是一个“知道自身是什么”的数据单元,其定义中包含了模式、更新节奏、所有权、访问政策和语义意义。
这种离散、拥有明确归属且独立部署的数据结构,几乎直接映射了人工智能代理所需的可靠操作环境。当代理需要回答业务问题、启动工作流程或生成报告时,它需要一个一致且机器可读的界面。
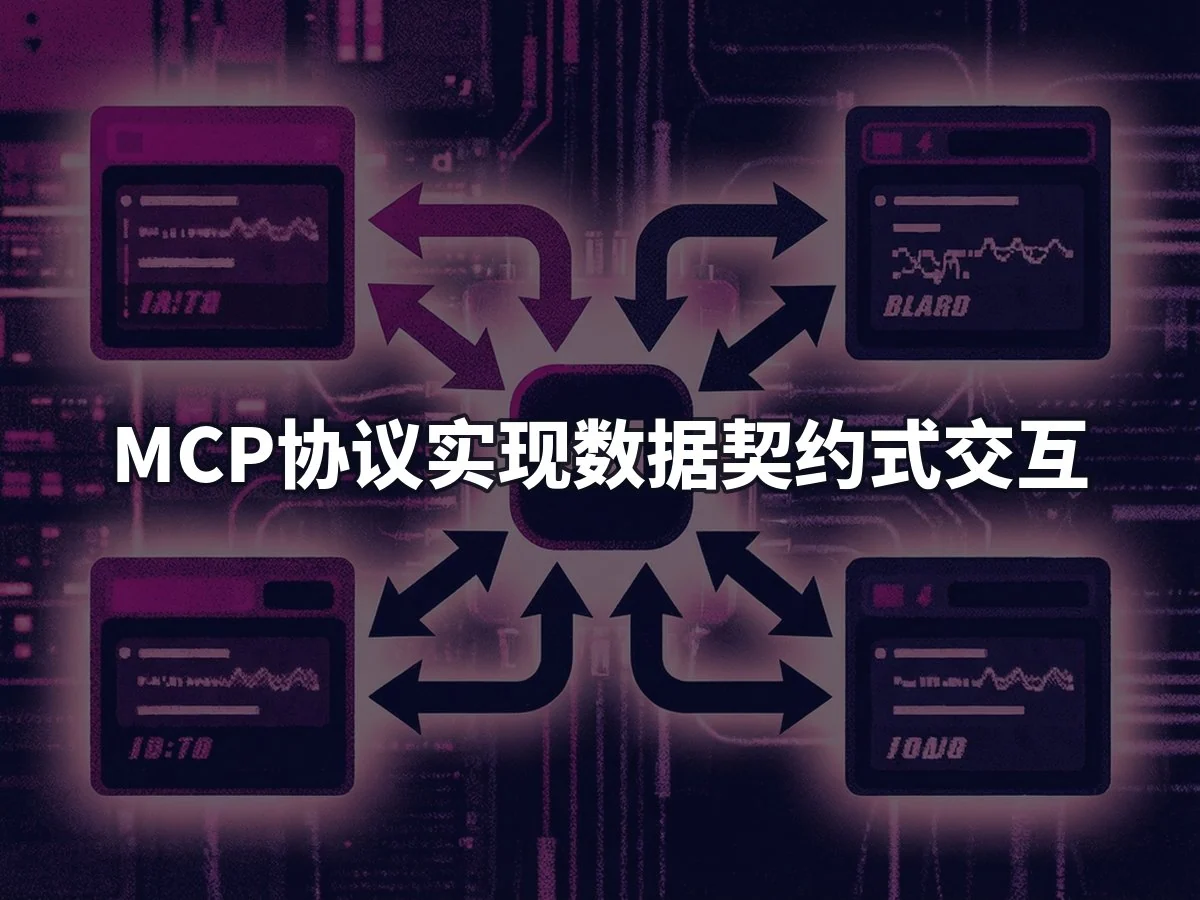
已建立数据产品体系的组织可以通过MCP(模型上下文协议)暴露这些数据。MCP是一种新兴标准,旨在为人工智能代理提供对外部系统和数据源的结构化、许可访问。
在实际应用中,这意味着人工智能代理可以发现如“客户终身价值”这样的数据产品存在,了解其包含的内容及当前状态,并检索正确片段,而无需人类编写自定义集成或由提示工程师硬编码SQL查询。这是一种基于契约而非猜测的交互方式。
相比之下,仍在使用原始、无差异化数据湖工作的组织面临截然不同的现实。在其代理能够进行有效推理之前,必须为每个新用例手工构建导航层。而数据产品组织已经建立了这一层基础设施,使其人工智能系统部署速度更快、性能降解更少,且在推断过程中对人类干预的需求显著降低。在当前环境下,这已不再是边缘优势,而是根本性的竞争壁垒。