在人工智能辅助编程领域,传统的“按 Token 计费”模式正面临严峻挑战。当开发者向 AI 代理下达编码任务时,代理并非一次性输出答案,而是经历规划、生成代码、运行测试及纠错的循环过程。这种复杂的交互导致单一任务的 Token 消耗量可达简单聊天提示词的 10 至 50 倍。随着代理功能的增强,调用次数激增,基于每 Token 定价的模式使得创造最大价值的工作流程反而成为成本最高的环节。
经济压力已显现端倪。据报道,Uber 在扩大使用 Claude Code 后,于 4 月份前便耗尽了其 2026 年的人工智能预算。GitHub Copilot 也已从固定价格转向计量信用制度。Gartner 预测指出,到 2028 年,AI 代码生成的 Token 成本将超过开发人员的平均工资。
尽管开发者在推出代理前通常会设置使用上限、座位限制和审批流程,但通用的限制措施往往制约了高价值工作流程的运行,且优化了错误的指标。每 Token 的成本仅衡量了消费量,而非结果。部分支出源于重试或失控循环造成的浪费,另一部分则代表了实际的软件交付工作。现有的计量器和支出上限无法区分这两者。
以合并请求为衡量标准
更有效的衡量指标应为“每次合并拉动请求(Pull Request)的成本”,即人工智能辅助开发的总成本除以通过审查并合并的代码变更数量。这一指标能防止低成本替代品掩盖低质量产出。若随着 AI 使用量的增加,单位合并成本下降,说明开发人员将更多消费转化为有效软件。核心问题不在于消耗了多少 Token,而在于投资产生了多少成品。
优化这一公式需要两方面变革:一是将昂贵的推理资源保留给必要任务,二是降低常规工作的成本。
模型与任务的匹配策略
代理编码无需在每一步都使用最强大的模型。前沿模型或本地旗舰模型应用于处理困难的规划和新颖推理任务;而代码生成、测试创建和重复性重构等常规工作,可路由至自运营的开放权重模型。
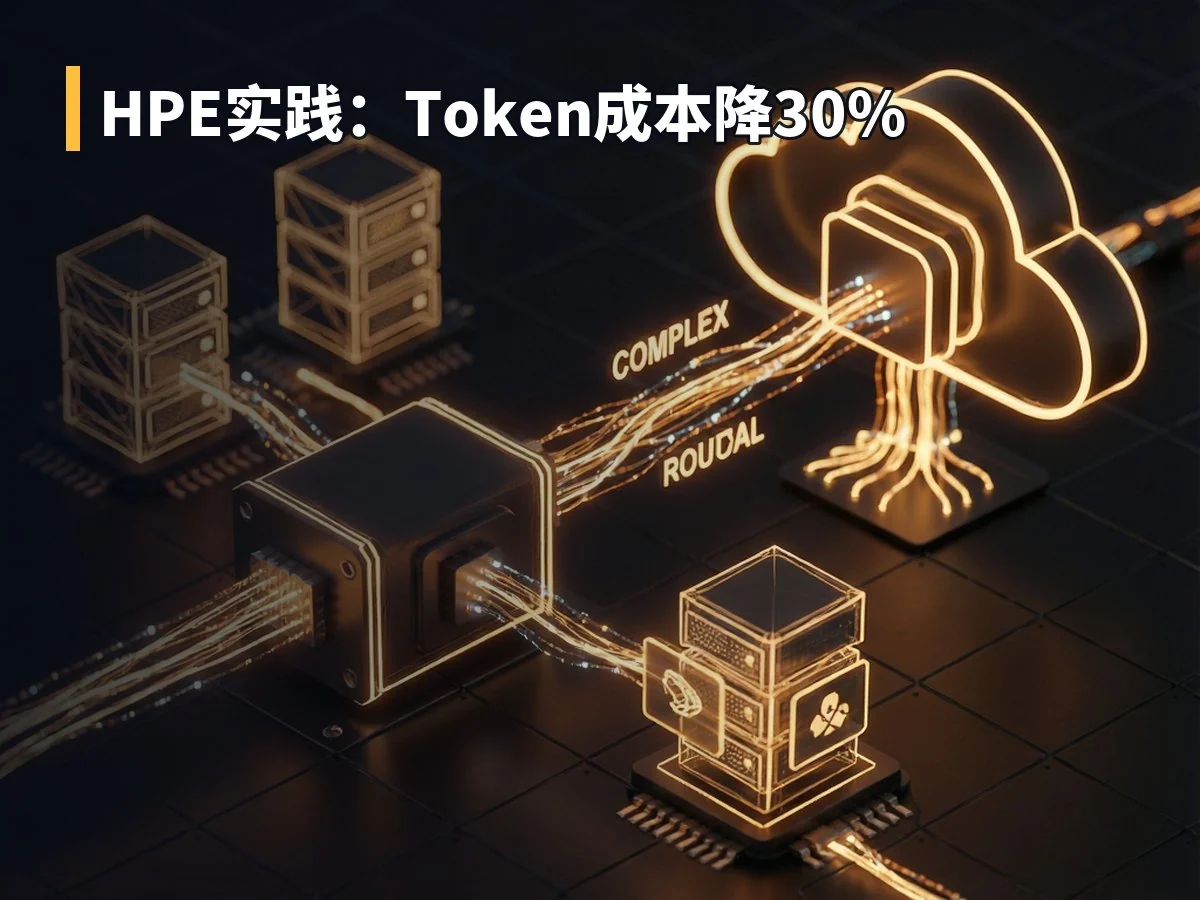
网关可根据任务复杂性、数据敏感性、成本和延迟对请求进行智能路由。这种做法将溢价推理保留在合理时刻,避免对整个工作流程应用高价定价,从而精准测量异常而非单纯的工作量。
开放式模型使这种划分日益可行。软件工程基准显示,领先的开放权重模型在某些任务上已接近前沿性能。但这并不意味着在所有仓库或工作流中完全等价。在分配生产任务前,需根据自身的代码、测试和验收标准评估候选模型。
改变重复使用的经济性
企业还需决定谁拥有算力资源。在 API 模式下,每次调用都会增加账单;而在自有算力模式下,随着使用量增加,边际成本会降低。
经济学逻辑表明,每 Token 定价使大规模使用变得昂贵,而拥有算力的效率随团队使用量增加而提升。然而,所有权并非免费,电力、运营、维护和折旧均需计入成本。关键在于计算“每个合并提取请求的全负载成本”。
自有算力还带来一项发票之外的价值:对敏感代码的控制权。当代码生成和测试在本地运行时,专有代码留在企业内部。只有经批准的规划提示和受规范的异常才通过组织控制的网关进入外部模型。这有助于在安全顾虑阻碍采用的场景下,打开敏感代码库的应用大门。
HPE 的混合模型实践
在 HPE,其混合人工智能平台将来自 150 多个内部应用程序的常规工作负载路由至内部运行的开放式模型(包括 HPE 私有云 AI)。结果显示,Token 成本下降了 30% 至 50%。
这正是混合架构的意义所在:拥有自有推理能力并不意味着放弃前沿模型,而是通过网关将最难的任务发送给外部最强模型。
数据表明,驱动支出的主要是实际使用量,而非许可人数。重度用户的使用量约为同一许可证下轻度用户的 450 倍。如果重度用户占比从少数人增长到劳动力的一半,每月支出可能增加约 4.4 倍。由于每家企业的混合比例不同,自行测量至关重要。
HPE 跟踪两个关键指标,并建议客户效仿:首先,跟踪每位活跃开发者的成本,因为所有许可证的平均值会隐藏高级用户的开支;其次,跟踪每个合并提取请求的成本,以将 AI 支出与交付的软件直接关联。
在改变基础设施之前,应先对这两个成本进行基准计算。随后,利用自有能力完成一个完整的开发周期。若两项指标未随使用量增长而改善,目前的模型可能仍是更佳选择。
为采用率而建,而非配给
并非所有企业都适合拥有算力。对于低用量或不可预测的使用场景,API 更具优势,无需绑定资本于基础设施。当持续需求能让算力保持忙碌时,自建才具有回报。大多数企业将运行混合模式:使用边界 API 处理苛刻或间歇性工作,同时拥有可重复量的产能。受控制的网关决定了哪些数据可以离开企业,从而确保获取前沿模型的能力。
随着开发人员日益依赖编码代理,使用量将持续上升。真正的抉择在于,这种增长是否表现为更高的可变成本账单。引领 AI 辅助开发的公司不会为控制成本而限制采用,他们将建立一种运营模式,使更多的 AI 使用能够改善而非破坏经济效益。