- Marvell 展示光子织物存储模块(Photonic Fabric Memory Module),该架构通过光纤连接 16 个模块,实现跨 16 台主机的 32TB DDR5 和 1,152GB HBM3e 共享内存池
- 该技术概念源自 Celestial AI 的演示,目前处于早期阶段,目标是在 2027 年向客户采样
- Nvidia 已持有 Marvell 价值 20 亿美元的股份,并推出了 BlueField-4 STX 上下文内存及 Vera Rubin NVL72 等竞争方案以应对内存瓶颈
在人工智能基础设施领域,Marvell 提出了一种旨在解耦计算与内存的新架构。该公司在 10 月 6 日的投资者日视频中展示了其“光子织物存储模块”,将其定义为“首个光学互联的高容量、高带宽存储器”。这一设计的核心理念是用光信号替代铜缆连接,从而将数十 TB 级别的内存整合到独立的设备池中。
架构细节:从单模块到系统级共享
需要澄清的是,宣传中的 32TB 总容量并非指单个模块的容量,而是整个光子织物存储系统的规格。该系统由 16 个独立模块组成,通过被动全对全光纤混合网络进行连接,形成一个可供多达 16 台主机(可以是服务器或单独的加速器)共享的内存池。
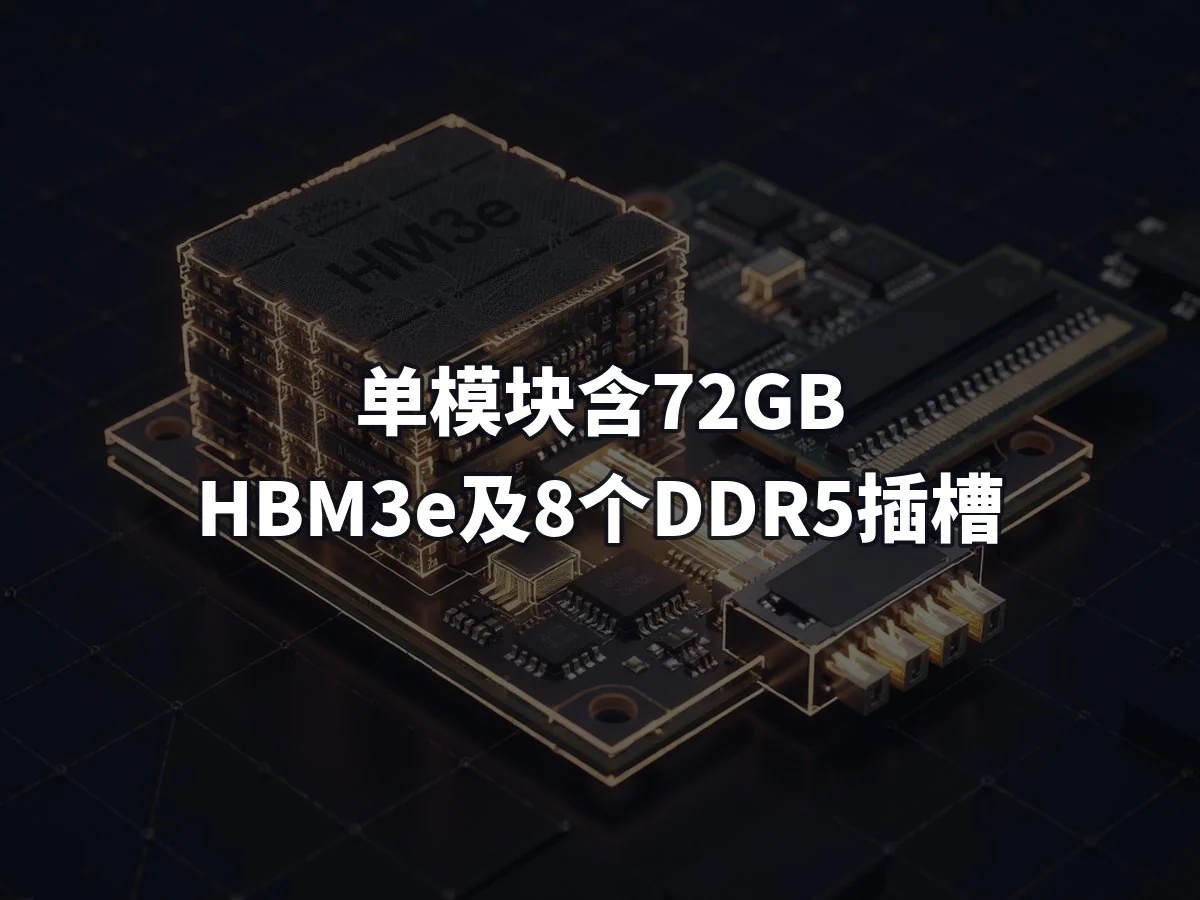
根据 Marvell 在 2026 年 8 月的热互连演示数据,每个物理模块包含以下组件:
- 72GB 的 HBM3e 内存
- 最多 8 个 DDR5 DIMM 插槽
- 一个光子织物 ASIC
- 7.2Tbps 的光学 I/O 接口
当使用 256GB RDIMM 填满所有 8 个插槽时,单个模块容量可达 2TB。16 个模块组合后,系统提供总计 32TB 的 DDR5 内存以及约 1TB(1,152GB)的 HBM3e 内存。其中,HBM3e 部分作为 DRAM 前的快速写入缓存运行。尽管这种设计理论上可覆盖超过 16 个 GPU 的场景,但目前尚无出货产品,Marvell 计划于 2027 年开始向客户提供工程样本。
经济性与技术背景
Marvell 此举旨在解决当前 AI 加速器的经济性痛点。Dave Lazovsky 指出,由于 HBM 价格高昂且必须绑定处理器购买,GPU 实质上成为了“世界上最昂贵的内存控制器”。对于大型语言模型而言,KV 缓存(Key-Value Cache)是主要的性能瓶颈之一。当 KV 缓存超出本地 HBM 和主机 DRAM 容量时,服务器不得不驱逐数据并重新计算,或从更慢的存储中读取,这将严重拖累推理性能。
负责 Photonic Fabric 部门产品管理的 Ravi Mahatme 表示,该共享层最大的收益在于实现“跨节点 KV 缓存”,允许一个加速器复用另一个加速器已计算的环境状态。Marvell 云解决方案副总裁 Will Chu 进一步阐述,随着 AI 规模扩大,内存必须从计算单元中独立出来。如果运营商能够单独采购内存而不必为了容量被迫购买更多 GPU,CAPEX(资本支出)有望降低。然而,Marvell 尚未公布具体的成本节约数字,仅在 2026 年 5 月的博客中提到每 GB 内存成本和推理成本的潜在降低。
值得注意的是,该架构并非全新发明。Celestial AI 早在 2025 年 8 月的热联网演示中就展示了类似的架构,即通过 16 个模块容纳 32TB DDR 和约 1TB HBM。TechRadar 此前也在 2024 年报道过其 DDR5-plus-HBM 方法。目前的差异主要在于物理模块的实现和采样时间的推进。
Nvidia 的多重对冲策略
面对内存扩展的挑战,Nvidia 并未坐视不管,而是采取了包括投资与自研在内的多重策略。
首先,在资本层面,Nvidia 已于 2026 年 3 月在 NVLink Fusion 和光子领域的交易中向 Marvell 投资了 20 亿美元。黄仁勋当时宣称“推理转折点已经到来”。由于每个 NVLink Fusion 平台必须包含至少一款 Nvidia 产品,即便定制芯片赢得市场,Nvidia 仍能从中获益。
其次,在产品层面,Nvidia 提供了多种针对同一内存问题的解决方案:
- Vera Rubin NVL72 机架:可携带 54TB LPDDR5X 内存,容量超过 Marvell 的整个设备。
- BlueField-4 STX:在 2026 年 GTC 大会上推出,这是一种基于闪存的上下文内存层,专为 KV 缓存构建。Nvidia 声称其代码吞吐量是基于 CPU 存储的五倍,黄仁勋强调推理 AI 需要“一种新的存储类别”。合作伙伴系统预计于 2026 年下半年推出。
- Enfabrica 收购:据报道,Nvidia 在 2025 年花费超过 9 亿美元收购 Enfabrica,其 EMFASYS 系统可为 GPU 集群提供高达 18TB 的内存。
此外,在光学互联方面,Nvidia 已向 Lumentum 和 Coherent 投入 40 亿美元,并于 2025 年 GTC 上推出光学交换机。公司计划在 2028 年的 Feynman 世代系统中,为 NVLink 选项提供共包光学技术。对于铜缆与光学扩展之间的选择,黄仁勋明确表示:“我们将两者都做。”
目前,Marvell 的光子织物存储模块仍是一个经过充分论证的蓝图。虽然 CAPEX 节省是其核心卖点,但具体数值尚待验证。Marvell 还需要争取知名客户、确立内存合作伙伴关系,并在真实硬件上展示测量吞吐量而非模拟曲线。与此同时,持有 Marvell 大量股份的 Nvidia 正在通过自有产品线积极布局,使得这场关于 AI 内存架构的竞争充满变数。