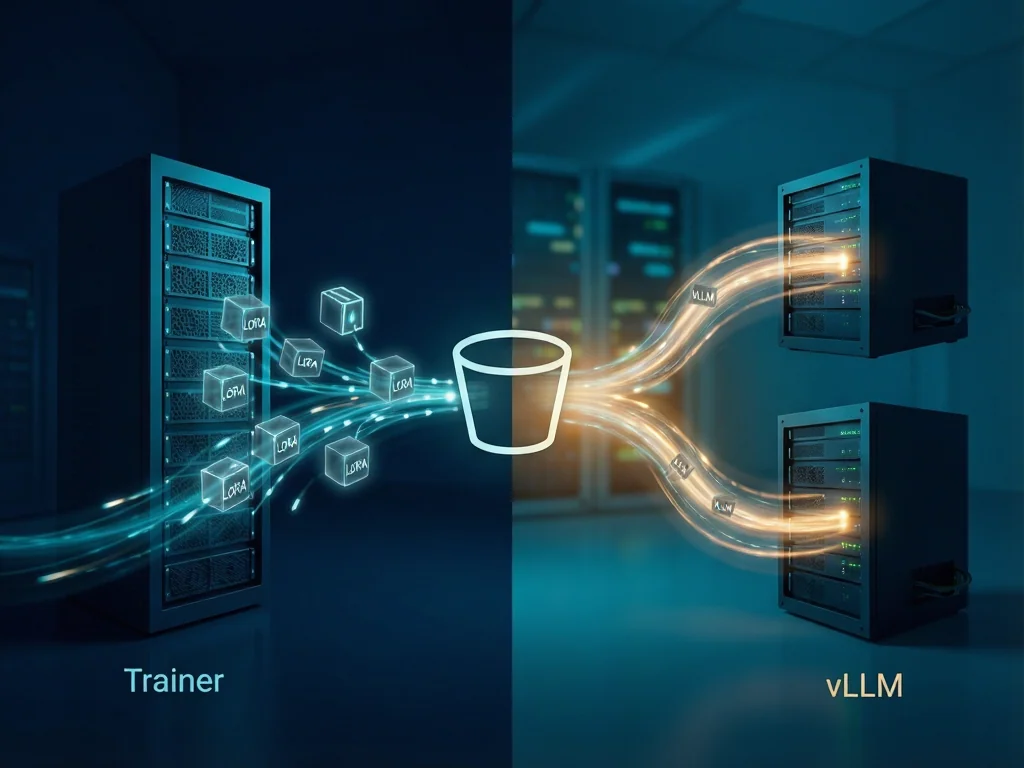
TRL v1.14 支持 LoRA 异步训练,配合 HF Jobs 实现训推分离
TRL v1.14 的 AsyncGRPOTrainer 新增 LoRA 适配器训练与同步能力。利用 Hugging Face Jobs 和存储桶挂载,实现了训练器与 vLLM 推理副本在独立机器上的异步运行,无需 NCCL。实测显示,相同配方下 500 步训练耗时从 3 小时 27 分钟压缩至 53 分钟。
共 2 篇相关文章
TRL v1.14 的 AsyncGRPOTrainer 新增 LoRA 适配器训练与同步能力。利用 Hugging Face Jobs 和存储桶挂载,实现了训练器与 vLLM 推理副本在独立机器上的异步运行,无需 NCCL。实测显示,相同配方下 500 步训练耗时从 3 小时 27 分钟压缩至 53 分钟。
本文介绍使用TRL库中的GRPO算法对LFM2.5-350M模型进行低成本微调,以优化其结构化输出能力。在IFStruct基准测试中,得分从22.6%提升至29.7%,验证了小模型通过特定任务微调可接近大模型水平。