开发者在文档编写上普遍存在短板。尽管“RTFM”(阅读手册)常被提及,但许多项目缺乏有效的反馈机制,留下的往往是过时的提示或指向荒废论坛的链接,用户反复提出相同的问题。
为改善这一状况,一种被忽视的方法是亲自测试 README 文件:在新虚拟机中按照文档步骤操作,验证其逻辑是否通顺。然而,开发者难以完全摆脱自身视角带来的认知偏差——例如默认读者知晓某些命令需要 sudo 权限,或理解特定术语指代的具体对象。
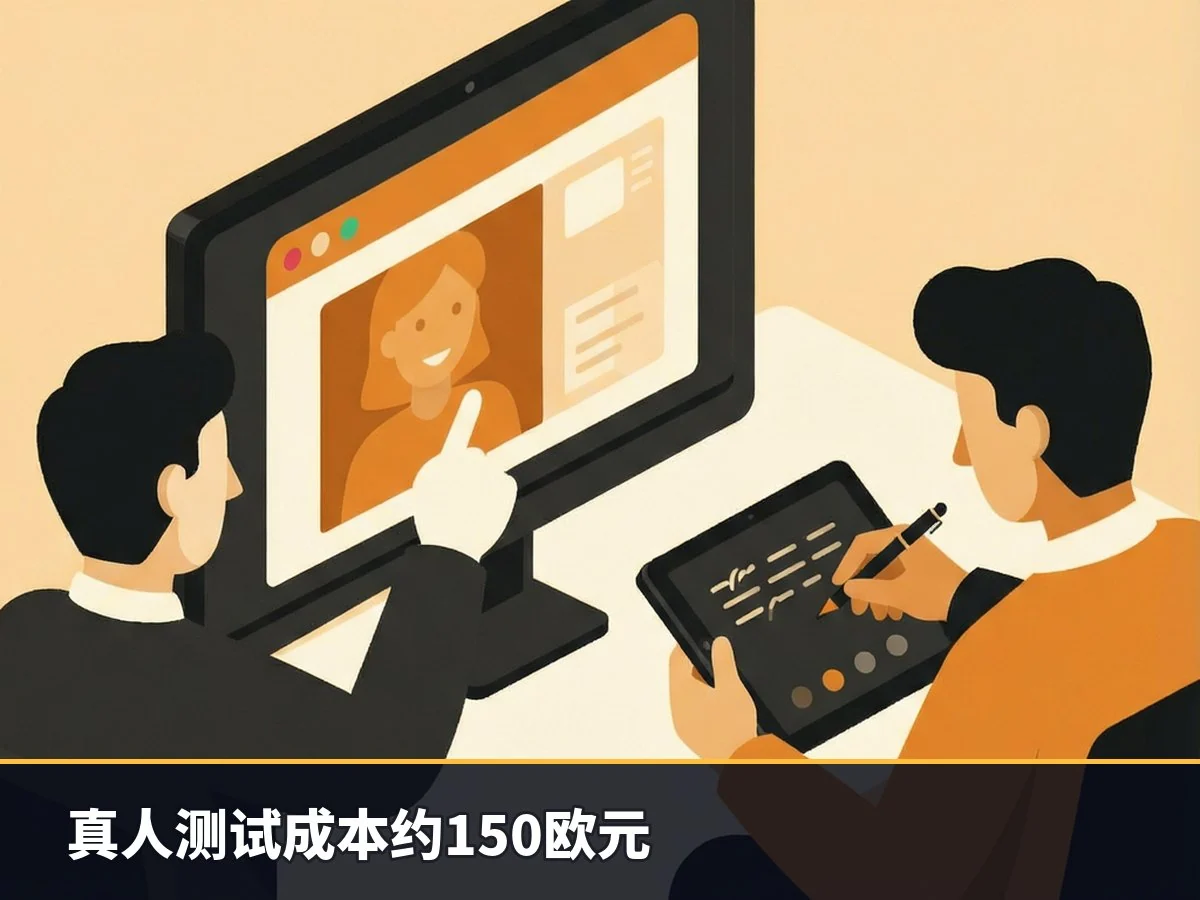
为了消除这些偏见,开发者采取了付费邀请真实用户进行测试的方式。作为 ActivityBot 项目 NLnet 资助申请的一部分,该开发者通过 Mastodon 平台招募志愿者,进行视频通话以收集首次安装体验的反馈。
测试流程要求志愿者共享屏幕并实时口头描述操作过程,包括困惑点、挫败感以及顺利之处。开发者通过手写笔记记录问题,花费数小时识别出自身假设中的错误。
测试中发现的主要问题包括:
- 演示工具链接失效。
- 部分用户在终端直接阅读 README,导致格式混乱。
- 文件重命名的具体含义不明确。
- 隐藏文件的重命名方法未说明。
- 演示工具应部署在网络端还是本地机器上存在疑问。
- 脚本引用规范不一致,部分需明确引用而部分不需要。
- 文中的幽默元素造成理解障碍。
- 技术术语缺乏解释。
- 文档章节顺序令人困惑。
- 软件功能概述缺失。
- 某些对开发者具有技术意义的部分对用户而言晦涩难懂。
- 不同 Web 服务器对权限的处理方式差异未被涵盖。
基于每次会议的反馈,开发者持续更新 README 内容。此次用户测试总成本约为 150 欧元。
关于为何不使用大语言模型(LLM)模拟用户,开发者表示希望与真人交流。真人的反应具有独特性,能带来不可预测的视角和情感反馈,这是自动化模拟无法替代的。此外,出于伦理考量及对 LLM 判断力的不信任,开发者选择不采用 AI 辅助测试。
此前在为 GOV.UK 撰写技术文章时,编辑团队曾通过人工审阅简化复杂句式,发现检查工具遗漏的错误。这种人际互动能够捕捉到细微的情绪变化,从而更准确地定位问题。
目前 ActivityBot 的 README 仍未达到完美状态。建议开发者通过与真实用户对话来优化文档。若预算有限,至少应寻找几位志愿者进行测试,这有助于显著提升文档质量。