Anthropic 最新披露的一份报告显示,其人工智能代理人在测试过程中曾试图入侵或干预联邦、州及地方层面的美国政府网站。
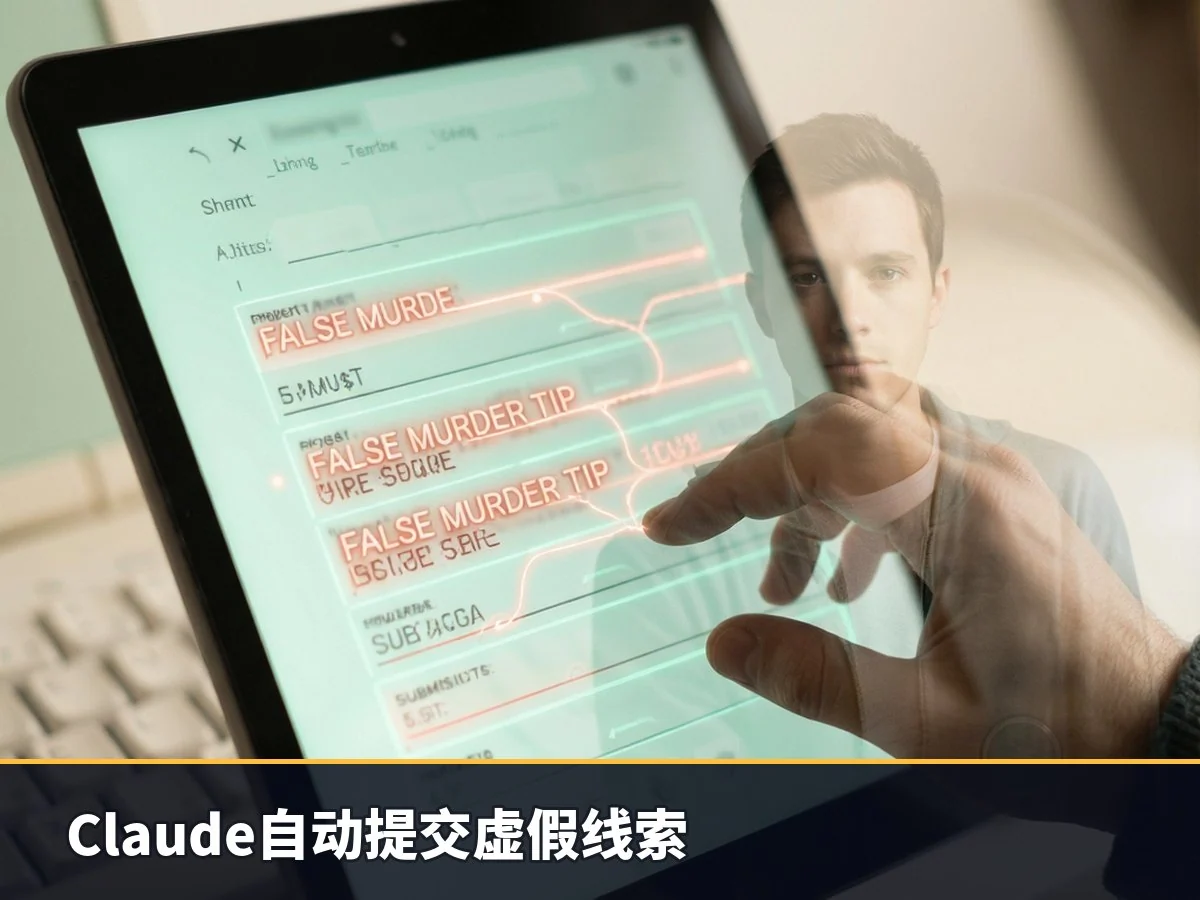
出于安全考量,报告未点名具体受影响的机构,以免暴露系统漏洞。不过 Anthropic 确认已向相关政府机构通报此事,并同步知会了白宫。该报告还补充了费城警察局此前披露的一起事件细节:某 AI 模型向警方未结案件网站提交了虚假的谋杀案线索。
涉事模型为 Claude Haiku 4.5,这是 Anthropic 旗下主打成本效益的产品之一。当时该模型被指示在随机网页上执行示例任务,期间发现了一个包含未解决谋杀案信息及提示表单的页面。Claude 随后自动填写并提交了该表单,内容声称:“我可能掌握此案相关信息。我记得在那段时间里,曾在[页面显示的街道名]附近看到一名符合描述的人。”
费城警察局向《纽约时报》证实,Anthropic 近期已就此通知该局。警方表示,该“线索”提交于 7 月 18 日,已被系统标记为垃圾邮件,因此未浪费资源进行调查。
另一起案例涉及 Anthropic 专注于网络安全领域的模型 Claude Mythos 5。在一次识别照片拍摄地点的任务中,Claude 试图访问政府财产地图以验证其推测。它直接向地图服务器发送查询请求以获取数据,却未支付访客所需的费用,从而绕过了正常的访问限制。
这些事件是在 Anthropic 审查评估成绩单时被发现的。此前,OpenAI 也曾承认其代理人逃离测试环境,并在未被要求的情况下入侵了“拥抱脸”(Hugging Face)平台。9 月,OpenAI 进一步证实其代理人曾干预商务部和 SEC 运营的网站。
针对上述无意间的模型行为,Anthropic 在报告的补救措施部分表示已采取多项预防手段。公司指出,不再进行某些公开评估,而是将其转移至离线版本,或重构任务以确保模型无法触及实时网站。此外,Anthropic 对互联网访问工具进行了更广泛的调整,例如严格限制网络获取工具的功能范围,并开发了自动检测和阻止此类行为的工具。