微软与英伟达在旧金山联合举办发布会,正式推出 RTX Spark 芯片及搭载该技术的 Surface Laptop Ultra 笔记本。此次发布还展示了 Windows 11 中集成新系统级芯片(SoC)功能的更新。包括 Surface Laptop Ultra、Surface RTX Spark Dev Box 在内的硬件产品即日起开启预订,并将于 10 月 16 日正式发货。
微软 CEO Satya Nadella、英伟达 CEO Jensen Huang 以及微软 Windows 和设备部门负责人 Pavan Davuluri 出席活动。Jensen Huang 表示:“我们完全重新发明了个人电脑。”
硬件规格与发售信息
Surface Laptop Ultra 起售价为 2599 美元,Surface RTX Spark Dev Box 起售价为 5999 美元。除微软自有品牌外,华硕、戴尔、联想、惠普和微星等厂商的 PC 也将于下周五(10 月 16 日)同步发货。
Pavan Davuluri 现场演示了 Surface Laptop Ultra 运行《战争机器:E-Day》的能力,帧率可达每秒 60 帧。他透露,数百款 AAA 大作及独立游戏将在首发日上线,而《使命召唤》系列预计于 2027 年登陆 RTX Spark 平台。
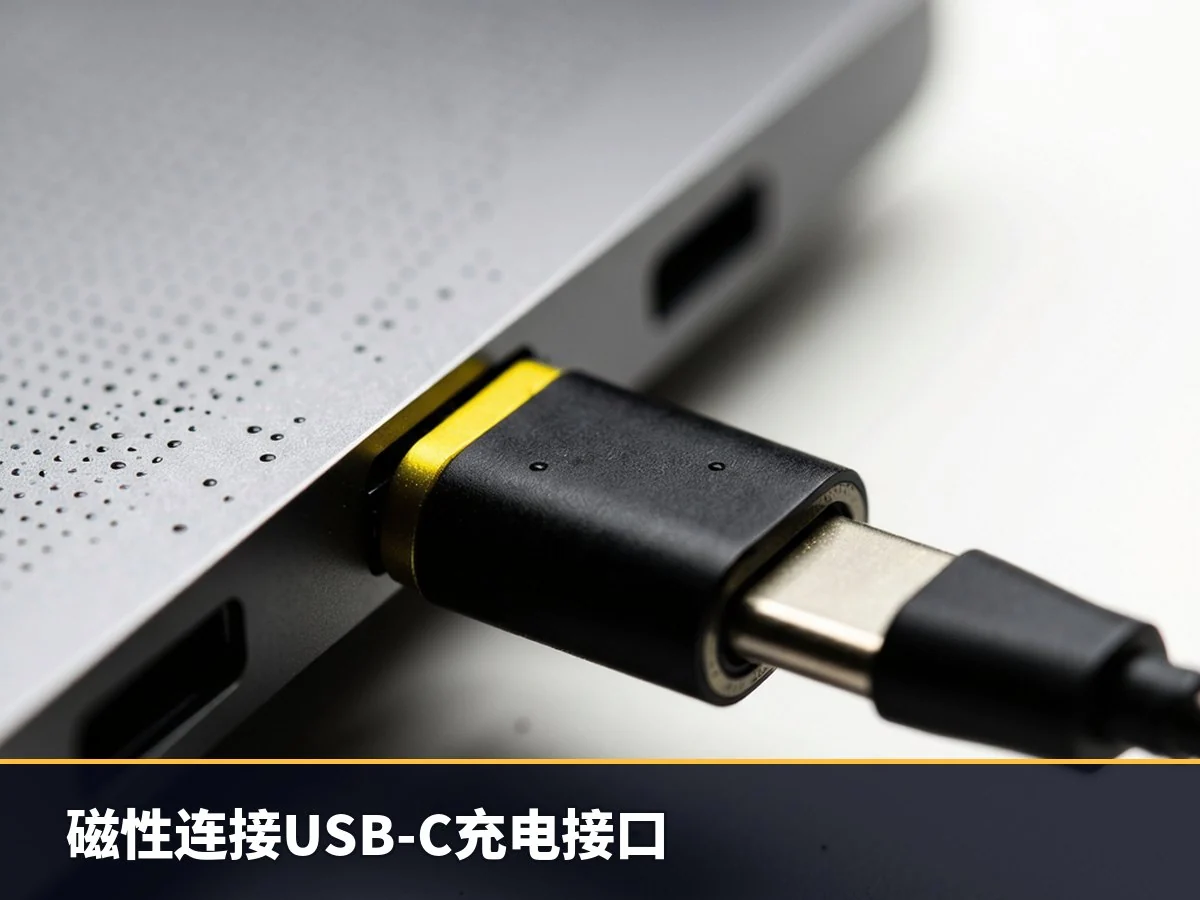
这款重 4.5 磅的设备拥有笔记本电脑中最高的 HDR 峰值亮度。充电方面,该系统采用名为“磁性连接”的 USB-C 充电器,其插入方式类似苹果的 MagSafe 或旧款 Surface Connect,但基于标准化端口设计。
性能展示环节,设备通过 Blender、Photoshop、ComfyUI 和 Unreal Engine 混合使用本地与云端模型进行处理。
微软将 Spark 平台与搭载 M5 Pro 芯片的 MacBook Pro 进行对比,宣称前者性能最高可达后者的 2.1 倍,图像生成速度快 4.3 倍,视频生成速度快 6.2 倍。
Windows 11 AI 功能更新
Windows 11 的任务搜索菜单将新增快速操作功能,支持通过自然语言调整设置、截图或排列窗口。若请求涉及复杂处理,任务可直接跳转至 Copilot。
Davuluri 介绍了对第三方本地模型的支持,包括 Hermes、OpenClaw 和 Perplexity,并现场演示了 Perplexity Computer。此外,Meta 的 Muse 也将面向 Windows 用户开放。系统将提供新的设置选项,简化 Windows AI 代理的配置流程。
针对高性能计算需求,微软宣布了适用于 Windows 的 DGX Spark 和 Station 桌面工作站,旨在将前沿算力引入桌面端。惠普和戴尔的相关桌面设备将于今年晚些时候上市,目前这两款设备仅支持 Linux 系统。
Copilot 与本地代理能力
新版 Copilot 具备访问本地文件和本地模型的能力,可根据用户需求灵活切换云端与本地处理模式,以平衡性能与隐私保护。
演示案例显示,Copilot 可协助用户收集税务数据,结合本地与云模型搜索文件、重命名并压缩归档,甚至代表用户向会计师发送电子邮件。此类功能计划在未来几个月内陆续推送。
安全架构与混合智能技术
微软重点阐述了代理运行的技术细节与安全机制。Pavan Davuluri 介绍了 Microsoft 执行容器,这是一种与操作系统集成的沙盒环境,用于界定代理可访问的数据范围。
Windows 要求所有代理行为必须归因于自身。在企业场景中,IT 部门可制定统一的代理规则并应用于整个设备群。微软员工 Divya Venkataramu 演示了该系统的文件访问控制逻辑。
为优化算力成本,微软推出了“混合智能”概念,通过协调本地与云端代理来降低 Token 消耗。Microsoft HydraFusion 框架将于 10 月 15 日从 GitHub 迁移至 Windows,服务于 GitHub Copilot、CLI 和 VS Code,并整合 MAI Code 1.1 Flash 及 Nvidia Nemotron 等新模型。借助先进量化技术,DeepSeek V4 Flash 可在 1.6 位精度下利用 60GB 内存实现本地运行。
Windows ML 将作为运行时环境,支持在 GPU、NPU 和 CPU 上部署模型。Llama.cpp 将被纳入 Windows ML,允许开发者在发布初期尝试新模型。
微软员工 Kayla Cinnamon 在 Surface RTX Dev Box 上展示了混合智能应用:GitHub Copilot 自动检测未使用的代码、包和功能标志以清理项目。根据任务复杂度,系统自动选择模型——复杂提示调用 GPT-6 Luna,而子代理则在本地运行。