随着人工智能模型训练规模的持续扩大,单纯增加 GPU 数量已无法解决所有问题。电力供应正成为制约集群扩展的严峻物理瓶颈,迫使基础设施团队探索在多个数据中心运行单一培训工作负载的方案。这一转变带来了全新的网络挑战。
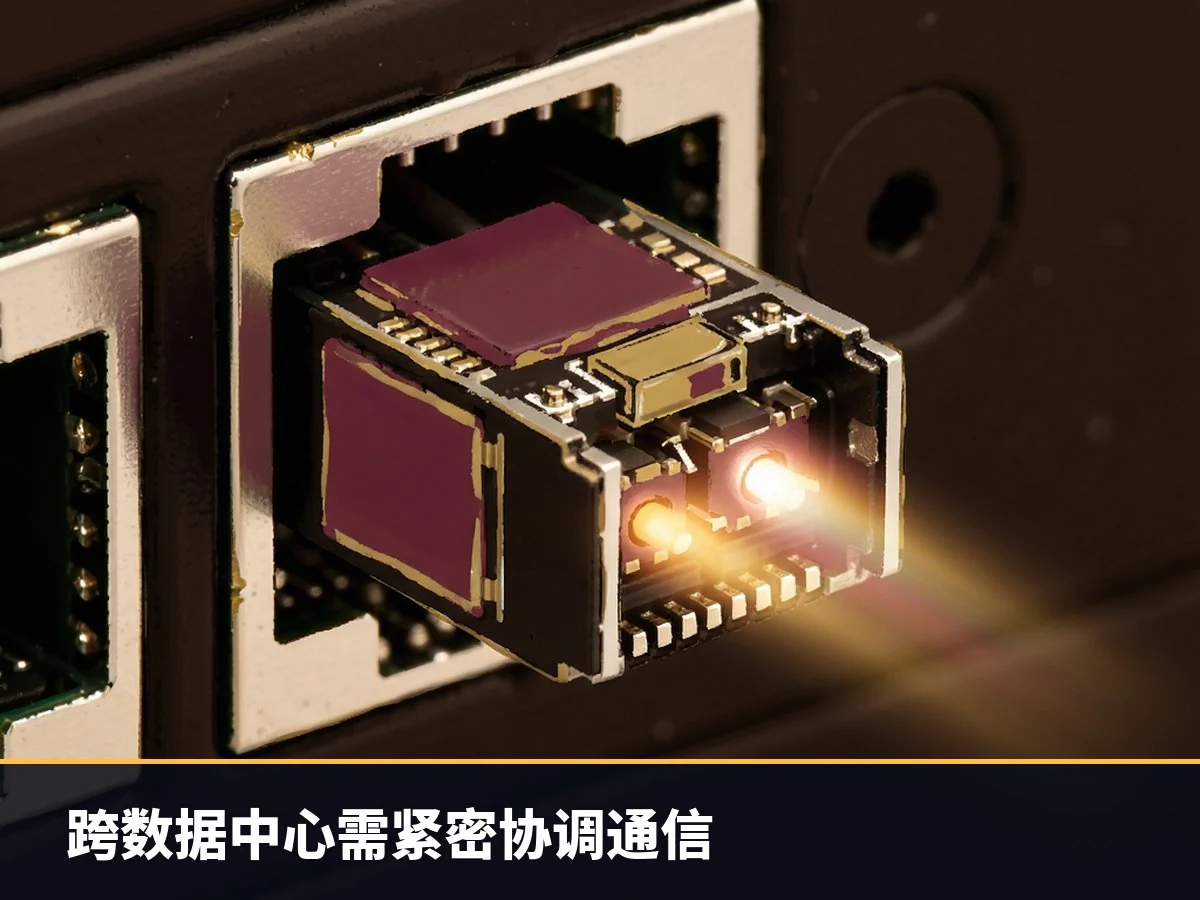
传统的数据中心互连技术主要设计用于网站间的流量传输,而 AI 训练对网络提出了更为严苛的要求:需要处理巨大的同步流量、实现极低的数据包丢失率,并确保 GPU 之间紧密协调的通信。由于分布式训练的强耦合特性,集群中任何部分的停滞都会波及整个工作负载。
针对这一趋势,The Register 记者蒂姆·菲利普斯(Tim Phillips)采访了思科高级副总裁兼系统架构师、思科研究员 Rakesh Chopra。双方深入探讨了思科提出的“跨规模”(Cross-Scale)概念,以及为何分布式 AI 基础设施需要一种新的路由方法,使网络从简单的数据传输通道转变为计算系统的核心组成部分。
Rakesh Chopra 详细阐述了将地理上分离的设施整合为类似单一确定性机器的技术挑战。他指出,当工作负载跨越长距离光纤链路时,缓冲机制、高速相干光模块以及紧密集成的组件变得至关重要。此外,采访还涉及了集群内部的网络架构,Rakesh 概述了思科 One 架构及智能集体网络的设计逻辑。
能效是讨论的另一核心议题,重点在于平衡网络自身的能耗与分配给 GPU 的计算能量。安全性与硬件寿命同样受到关注,采访中提到了硬件加速的 MACsec 和 IPsec 加密技术,以及可编程性在帮助基础设施适应不断演变的 AI 工作负载方面所发挥的作用。
对于规划更大规模、更分布式 AI 环境的基础设施和数据中心领导者而言,此次访谈提供了关于单站点局限性及随之而来的网络挑战的实用视角。