Liquid AI 发布 LFM2.5-VL-DSpark:为视觉语言模型提供投机解码加速
Liquid AI 近日发布了针对其视觉语言模型(VLM)LFM2.5-VL-3B 的实验性 DSpark 草稿模型。该模型通过引入投机解码(Speculative Decoding)路径,旨在以极小的内存开销换取显著的推理速度提升,同时保持输出质量不变。
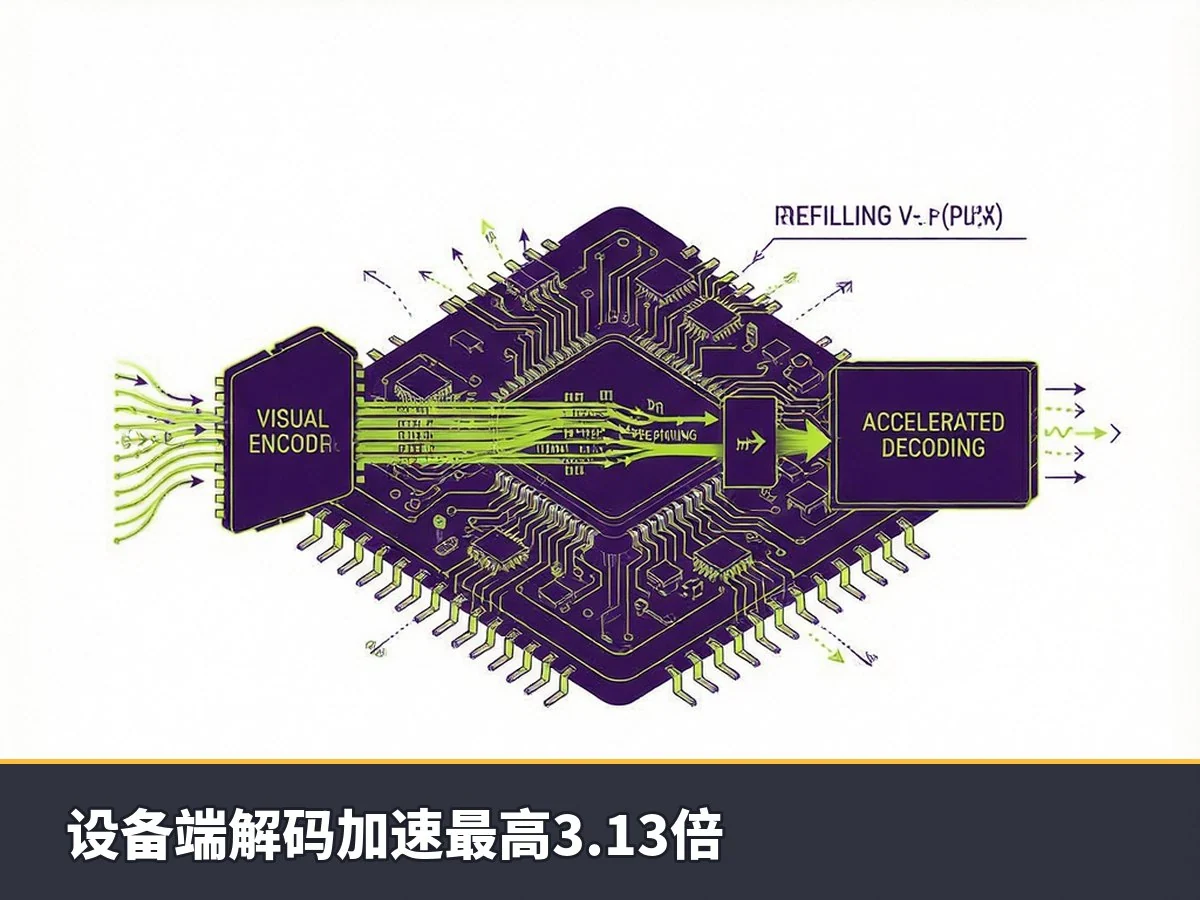
主要特性包括:
- 推理加速:在设备端实现最高 3.13x 的解码加速,在 H100 GPU 上实现 2.66x 的解码加速;端到端延迟分别降低至原来的 2.62x 和 2.27x。
- 低内存成本:草稿模型仅增加约 280M 参数,相比 3B 目标模型的参数量增幅为 8.9%。
- 广泛支持:首日即支持 llama.cpp、MLX-VLM 和 SGLang 等主流推理框架。
VLM 投机解码的技术原理
视觉草稿器采用了与文本版 LFM2.5-DSpark 相同的架构设计。它捕获目标模型在特定层级的隐藏状态,并以此为基础起草 k 个候选代币块。图像补丁和文本代币在进入这些层级前被投射到共享表示空间中,使得草稿器能够处理统一维度的隐藏状态向量,无论输入模态如何。因此,其推断算法逻辑与纯文本模型保持一致。
训练配置与模型结构
训练过程中使用了混合视觉语言监督微调(SFT)数据,并根据预期工作负载进行加权。基于第 3、4 和 5 层的剥离技术,该草稿模型是一个简化的仅关注型(attention-only)架构,包含 4 个层级和 9 个块大小。模型在最终混合数据集上运行了 10 个 epoch,并在每个 epoch 后测量接受率。推断时建议根据硬件条件选择 8 或 9 的块大小。
生成的草稿模型总参数量约为 280M,具体构成如下:
| 组成部分 | 参数量 |
|---|---|
| 解码器堆栈 (4 层) | 193.0M |
| 隐藏状态投影 | 21.0M |
| 马尔可夫头 | 65.5M |
| 规范化 + 置信度头 | 6.4k |
| 总计 | 279.5M |
CPU 与 GPU 上的性能实测
Liquid AI 在多种硬件配置下评估了 DSpark 对 LFM2.5-VL-3B 的加速效果。测试使用 MMSpec 基准,涵盖一般 VQA、文本 VQA、图片描述、图表 VQA、复杂推理和多轮对话六类视觉任务。所有配置均使用大小为 8 的 DSpark 块。
设备端推断:
- 在搭载 MLX 的 Apple M5 Max 上,解码速度提升 2.30x 至 3.13x,端到端延迟改善 1.56x 至 2.62x。
- 在搭载 llama.cpp 的 Apple M3 Ultra 上,解码性能提升 1.57x 至 2.14x,端到端性能提升 1.30x 至 1.77x。
GPU 推断:
在 NVIDIA H100 上,同一草稿模型实现了 2.04x 至 2.66x 的解码加速,端到端改进幅度为 1.64x 至 2.27x。
视觉工作负载中的投机解码局限性
在大语言模型中,预填充阶段通常是计算密集型的,其成本随提示长度呈二次方增长。对于视觉语言模型,图像首先通过视觉编码器处理,随后语言主干网络需处理数百个视觉代币及文本提示。由于边缘设备的算力远低于数据中心 GPU,预填充阶段占据了更多的端到端延迟时间。
根据阿姆达尔定律,整体加速比受限于未加速部分的时间占比。当视觉编码或预填充阶段已占据大部分墙钟时间时,即便解码阶段大幅加速,端到端的总体提升也将受到限制。
部署指南
用户可通过以下命令在不同框架中启用 LFM2.5-VL-DSpark:
使用 SGLang:
需要集成 DSpark 支持的 SGLang 构建版本(参考 PR #40651)。启动命令示例:
python -m sglang.launch_server \
  --model-path LiquidAI/LFM2.5-VL-3B \
  --speculative-algorithm DSPARK \
  --speculative-draft-model-path LiquidAI/LFM2.5-VL-3B-DSpark \
  --speculative-draft-attention-backend flashinfer \
  --speculative-dspark-block-size 9 \
  --disable-radix-cache
服务启动后,可通过 OpenAI 兼容端点 http://localhost:30000/v1 进行查询。块大小从草稿模型的 config.json 中读取;移除三个 --speculative-* 标志即可运行基线模型。
使用 llama.cpp:
需要相应的 llama.cpp 构建版本(参考 PR #29339):
llama-server -m models/LFM2.5-VL-3B-F16.gguf \
  --mmproj models/mmproj-LFM2.5-VL-3B-F16.gguf \
  -md LFM2.5-2.6B-DSpark-F16.gguf \
  --spec-type draft-dspark --spec-draft-n-max 8 --spec-draft-n-min 0 \
  -fa on -ngl 99 -c 8192
使用 MLX-VLM:
需要相应的 MLX-VLM 构建版本(参考 PR #2280):
mlx_vlm.server --model LiquidAI/LFM2.5-VL-3B --draft-model LiquidAI/LFM2.5-VL-3B-DSpark
注:投机解码是精确的,目标模型会验证每一个建议的代币,确保贪心输出的结果与仅使用目标模型时完全一致。响应时间报告格式为 draft_n / draft_n_accepted。
获取方式
LFM2.5-VL-DSpark 草稿模型已在 Hugging Face 平台上线,提供 Safetensors 和 GGUF 两种格式下载。
引用信息:
@article{liquidAI2026vldspark,
  author = {Liquid AI},
  title = {LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm2-5-vl-dspark},
}