Meta 推出高保真全息化身,显著提升 VR 与 AR 设备沉浸感
Meta 在 Connect 发布会上正式宣布将其全息化身(Holographic Avatars)技术引入新款 VR 眼镜及 Meta Ray-Ban 显示眼镜。相较于公司此前推出的数字化形象,新一代技术在真实感和细节还原上实现了显著突破。
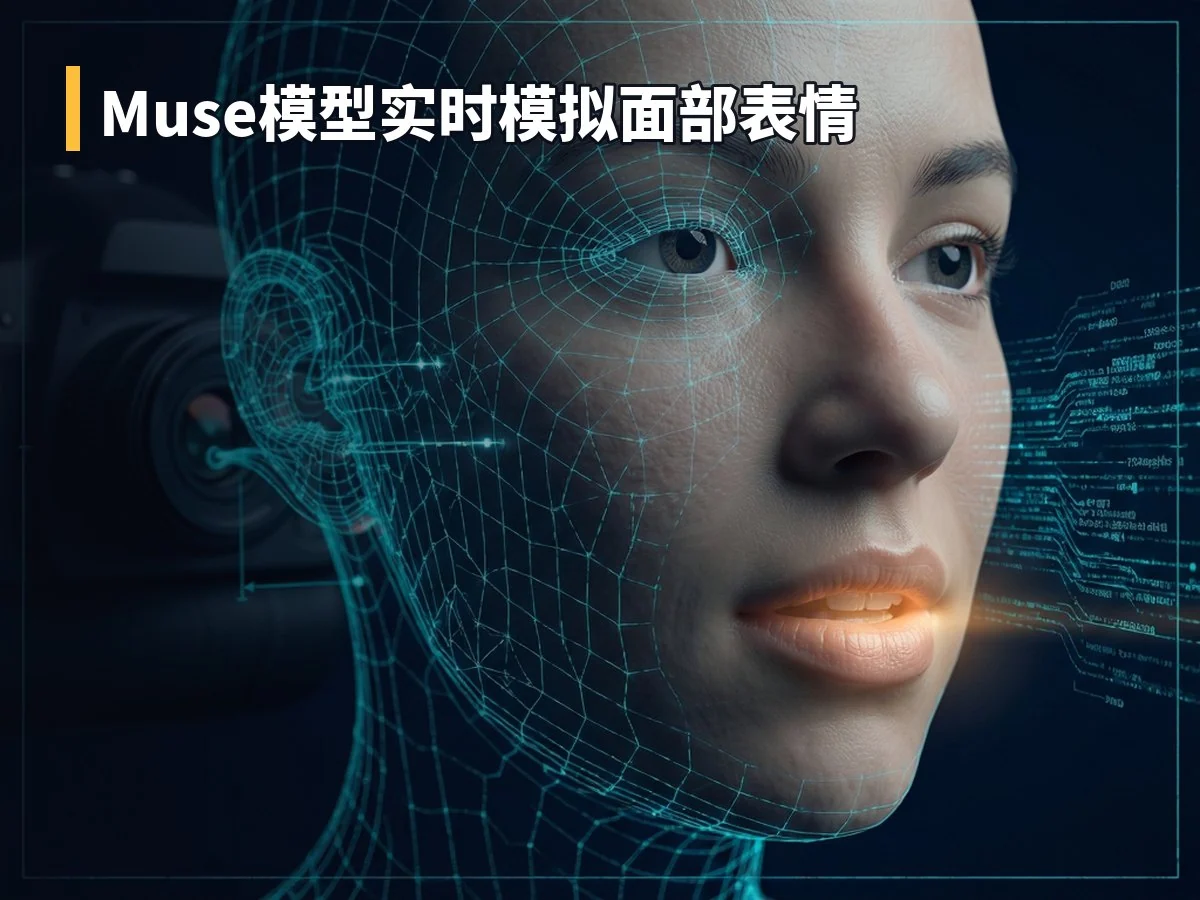
基于 Muse 实时模型的表情模拟
这些化身由 Meta 全新的“Muse 实时化身”模型驱动,该模型通过短暂的训练期来模拟用户在说话时的真实面部表情。在实际体验中,佩戴者可以看到屏幕角落中的自身化身预览,其外观与真人高度相似,尽管观察者仍能直观分辨出这是数字替身而非本人。
当从第三方视角观看时,化身的逼真度更高。在测试场景中,若观众对通话对象不熟悉,很难立即察觉对方使用的是化身而非真人视频流。为了区分真实视频与化身通话,Meta 将在所有涉及化身的视频通话画面中添加透明水印。这一设计旨在确保透明度,避免误导。
不同设备的创建流程与交互限制
根据硬件平台的不同,化身的创建方式有所差异:
- Meta Ray-Ban 显示眼镜:用户需通过 Meta AI 应用程序进行设置,过程类似于 Apple Vision Pro 的“人物”创建。系统会引导用户使用手机摄像头转动头部以捕捉多角度面部特征,并通过回答一系列问题(如描述完美的一天或爱好)来采集声音数据。整个创建过程大约耗时 5 分钟。一旦完成,用户即可在 WhatsApp 或 Zoom 等应用中使用该化身进行视频通话。
- 新款 VR 眼镜:得益于更先进的内置摄像头和传感器,VR 端的化身计划更为雄心勃勃。用户无需预先“教导”系统自己的表情习惯,设备依靠向内看的摄像头和传感器实时捕捉面部动作,从而生成全身化身。
在 VR 环境中,全息化身相比 Apple 的“人物”显得更为自然,避免了后者常见的平滑感和非人化特征。虽然目前的渲染主要集中在正面视图,且在快速移动时边缘可能出现轻微模糊,但整体互动体验已大幅优于以往版本。
当前局限性与未来展望
目前该技术仍存在明显的兼容性限制。现阶段,只有佩戴 Meta Ray-Ban 显示眼镜的用户才能呼叫他人的化身;而佩戴 VR 眼镜的用户仅能与其他 VR 端用户进行化身互动,跨设备(VR 到眼镜)的呼叫功能尚未开放。
Meta 表示,全息化身旨在增强视频通话中的“在场感”。对于不愿展示真实面容的场景,这提供了一种比传统静态头像更具表现力的替代方案。首批支持全息化身的 Meta Ray-Ban 显示眼镜预计将于今年秋季上市。