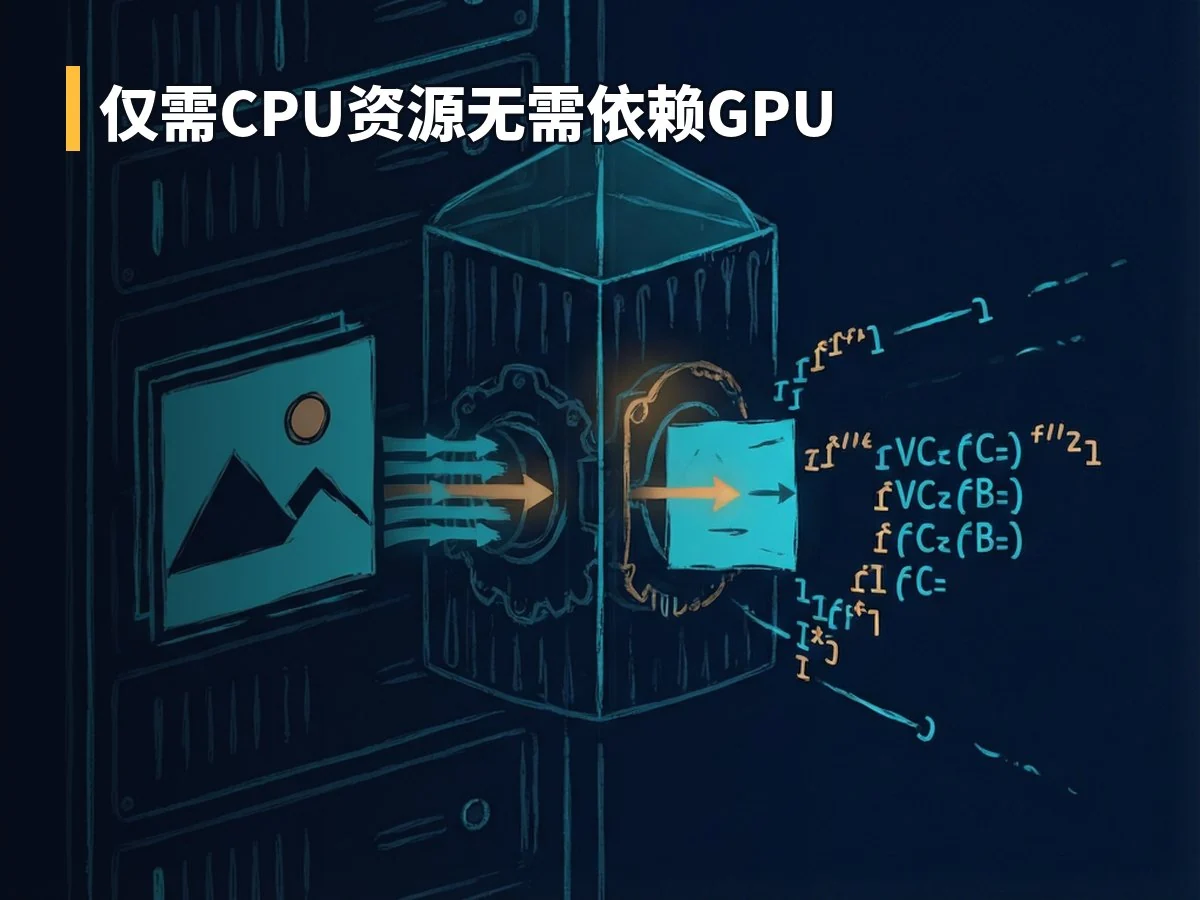
ABBYY 近日推出 FineParser,这是一款将传统 OCR 技术与现代 AI 工作流相结合的新工具。该工具基于 ABBYY 成熟的 FineReader OCR 引擎开发,采用自托管模式,运行于 Docker 容器内且仅需 CPU 资源,无需依赖 GPU。其核心功能是将文档图像转换为保留原始布局的结构化文本,以便后续供生成式 AI 大语言模型(LLM)处理。
FineParser 的设计理念被 ABBYY 称为“确定性”AI。与直接生成内容的 LLM 不同,FineParser 专注于准确提取文本及其在页面中的结构位置,而非生成看似合理的复现版本。这种处理方式旨在解决 LLM 响应难以预测的问题,确保输入数据的准确性。除了为 AI 提供结构化数据外,该工具还可用于将印刷文本导入内容管理系统(CMS)、进行数字归档或集成到各类生产流水线中。
在技术特性上,FineParser 强调对文档结构的保留能力。它能够按阅读顺序识别分栏、标题以及表格——包括无边框表格——从而避免输出杂乱无章的纯文本。此外,该工具支持超过 200 种语言的文档处理,并具备识别手写内容的能力。开发者可通过 REST API 提交文档,获取纯文本、JSON 或 DocLang 格式的输出结果。其中,DocLang 是一种专为 LLM 输入优化的紧凑格式。
目前,ABBYY 还维护着开源的可编程机器学习框架 NeoML,该软件已在 GitHub 上发布。同时,公司提供了 OCR SDK,允许企业将 FineReader 引擎嵌入自身产品。需要注意的是,FineParser 本身并非开源软件,尽管 ABBYY 在其 GitHub 仓库中提供了示例代码和社区支持。在定价策略方面,FineParser 提供为期一年、每月 1,000 页的免费额度。订阅层级需连接许可证服务器进行验证,而完全离线部署则需要购买 Enterprise 计划。
ABBYY 押注于其在 OCR 领域数十年的技术积累,试图证明在由 LLM 主导的 AI 流水线中,作为前置环节的精确文档解析组件仍具有不可替代的价值。