光计算的概念已存在逾 70 年,但长期局限于学术研究领域。近年来,这一技术迅速商业化,相关初创企业的市场总估值达到 22 亿美元(注:原文此处数据逻辑似有误,通常指从较低基数增长至该数值,或对比过去年份,此处严格保留原文数字表述)。行业预测显示,未来几年该市场将呈指数级增长。
推动这一变革的核心动力是人工智能,尤其是 AI 推理过程。随着大模型对算力需求的激增,数据中心能耗问题日益严峻。康奈尔大学应用和工程物理学副教授 Peter McMahon 指出:“人们对光子学的兴趣主要源于 AI 推理在功耗上已触及瓶颈,且这种限制表现得相当显著。”
理论上,光学系统可提供与当前 GPU 相当的计算能力,并具备显著的能效优势。目前,美国、中国、德国和以色列等地涌现出大量光学计算初创企业。尽管直接挑战 Nvidia 等巨头极具野心,但这些投资也催生了多种互补的技术路径,例如在现有数据中心的光网络路径中插入光学计算元件。
耶鲁大学应用物理学助理教授 Logan Wright 认为:“如果这些公司中的许多能成功运行这项技术,将对整个行业有益。光子系统在 AI 浪潮中将发挥重要作用。”
AI 推理的能耗困境与光学解法
AI 推理占据了人工智能能源消耗的绝大部分。业界投入数十亿美元优化 GPU 及其他芯片以提升推理效率。推理计算的核心操作是矩阵向量乘法,每秒需执行无数次。
早在 1978 年,光学计算先驱 Joseph W. Goodman 及其同事便提出利用光进行矩阵向量乘法的方法。其原理相对直观:假设长度为 N 的向量需乘以 N×N 的矩阵。一排 N 个发光二极管(LED)将向量元素编码为光强度,亮度对应数值大小。圆柱透镜将光线垂直散射,相当于复制向量 N 次。随后,光线通过一个 N×N 像素的衰减器,每个像素根据矩阵对应位置的值减弱光线,从而完成乘法运算。最后,另一个垂直于第一个镜头的圆柱透镜收集每行光线并进行累加,由检测器阵列读取最终向量。
矢量矩阵乘法原理
现代 AI 中最昂贵的计算部分即为矢量矩阵(或矩阵矩阵)乘法。对于长度为 N 的向量,电子计算需要 N² 次乘法步骤和 N 次累加步骤。
光学方案的优势在于能量缩放比例。在电子学中,每次乘法都消耗能量,总能耗随 N² 增长。而在光学中,只要矩阵保持不变,通过衰减器的光是被动过程,几乎不耗能。主要能耗仅在于将向量编码为光以及读出结果,这两者的成本随 N 线性增长。因此,随着矩阵规模扩大,光学的能效优势愈发明显。
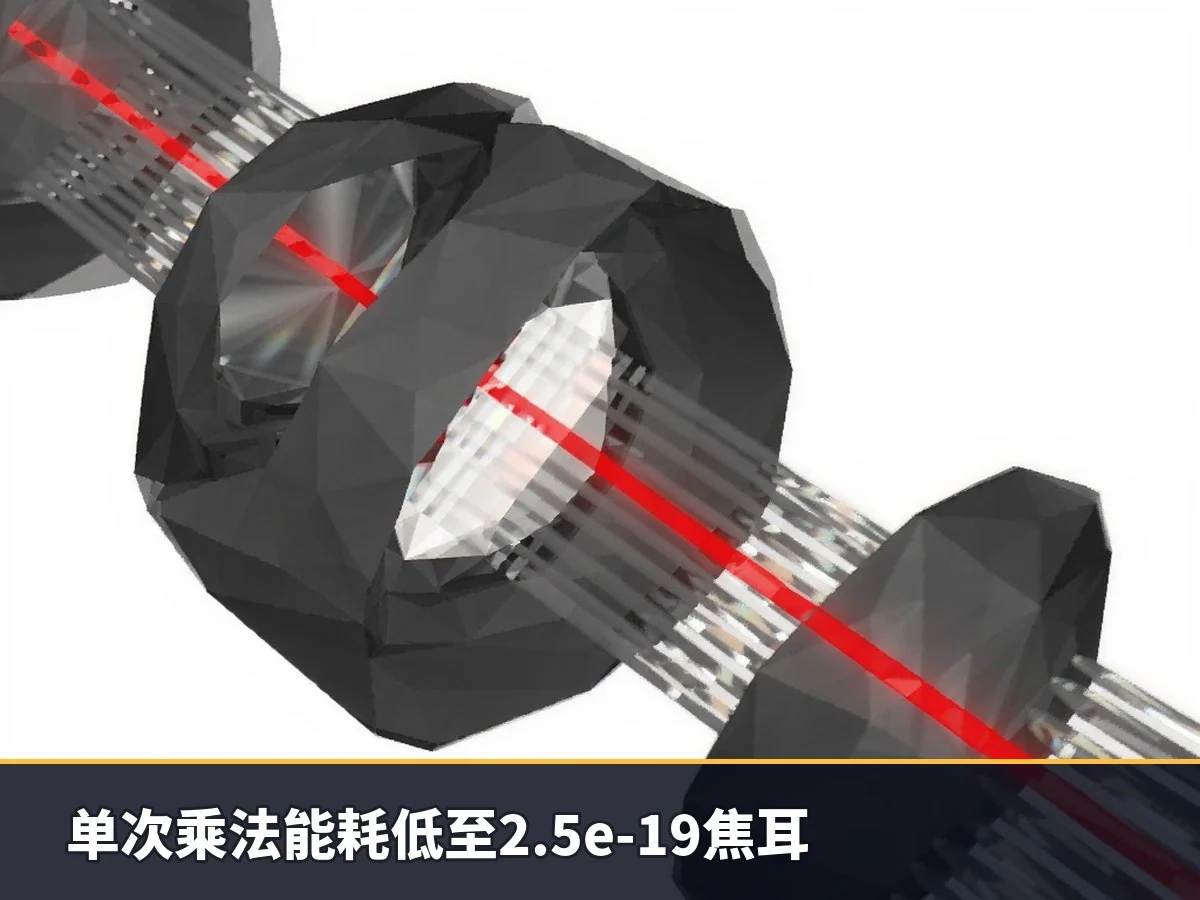
自 1978 年以来,光学元件质量显著提升。2022 年,McMahon 领导的康奈尔大学团队展示了一种光学神经网络,单次乘法运算能耗低于一个光子,约为 2.5×10⁻¹⁹ 焦耳。相比之下,标准计算机的单次乘法能耗在 10⁻¹⁴ 到 10⁻¹² 焦耳之间,这意味着光学潜在可将能耗降低 10 万倍。
然而,McMahon 对此持谨慎态度。首先,上述计算未包含数据编码成本。其次,实际应用中系数至关重要。若电子方式单次乘法耗能为 1 皮焦耳,而光学方式对一个向量元素编码的成本为 1,000 皮焦耳,则当向量长度 N 小于 1,000 时,电子方案仍更优。McMahon 表示:“关键问题是系统需多大才能开始取胜?粗略估计,N 介于 1,000 到 10,000 之间。”
此外,阿姆达尔定律(Amdahl's Law)同样适用。即使加速了 90% 的代码,剩余 10% 的部分限制了最大加速比。AI 推理中并非所有操作都适合光学处理,矩阵乘法仅是工作负载的一部分,还需结合非线性运算。目前,光学计算公司的目标是将能效提高 10 至 80 倍,关键在于能否在传统电子器件提升能效之前抢占市场。
自由空间光学:填补空隙
总部位于英国牛津的 Lumai 受 Goodman 设计启发最深。其产品负责人 Phillip Burr 介绍,Lumai 使用空间光调制器(SLM),这是一种类似精致 LCD 的可编程像素化膜。光线通过空气而非芯片波导传输。虽然实现细节复杂,但原理与 Goodman 设计相似:向量编码为光,经镜头复制,通过 SLM 调制,再收集并转换回数字信号,由电子单元处理非线性函数。完整的矢量矩阵乘法可在单个光学循环中完成。
为了准确比较光学与 GPU 的能耗,需区分推理的两个阶段:预填充(Prefill,输入查询的处理)和解码(Decode,逐词生成输出)。预填充计算密集,涉及大量相同的矩阵向量乘法;解码则耗时于内存读取。Lumai 专注于计算密集的预填充阶段。该公司声称,计划于 2026 年 4 月推出的概念验证服务器 Iris Nova,及其下一代 Iris Aura,将以约 GPU 十分之一的能耗完成预填充任务。
自由空间光学矢量矩阵乘法示意
德克萨斯州奥斯汀的 Neurophos 则对 Goodman 设计进行了改进。该公司利用超材料专业知识,在小于单个波长的尺度上操纵光。CEO Patrick Bowen 指出,标准光子晶体管长达 2 毫米,无法与台积电(TSMC)的最新工艺竞争密度。Neurophos 设计的基于超材料的调制器,可在边长 5 毫米的方形芯片上集成 1,000 x 1,000 个调制器阵列,切换速度比标准液晶 SLM 快 10,000 倍以上。
Bowen 声称,其技术在速度和能效上分别达到 Nvidia Blackwell B200 GPU 的 50 倍和 35 倍,并计划在后续几代产品中实现 250 倍速度和 90 倍能效的提升。该方法与 CMOS 兼容,可利用现有半导体生产线制造。Neurophos 正选址建设工厂,预计 2028 年向客户交付货架产品。
Lumai 和 Neurophos 均押注于在 CMOS 能效提升放缓前进入市场。Burr 表示:“数字效率增长缓慢且成本高昂,而光学提供了不同的缩放关系,效率随矩阵增大而提高。大型模型、长上下文窗口和代理工作负载都在推动预填充向此方向发展。”
集成光子学:芯片上的突破
除自由空间光学外,集成光子学也是重要方向。Logan Wright 指出,自由空间方法虽潜力巨大,但基础设施不如硅光子技术成熟。上海 Lightelligence 和德国斯图加特 Q.ANT 等公司正致力于将自由空间光学的 3D 优势与片上光子集成相结合。
Q.ANT CEO Michael Förtsch 表示:“自由空间光通信每年产量有限,原因在于镜头对准和组装策略。采用半导体工艺制造的集成光子电路在大规模量产方面更具前景。”
集成光子学矢量矩阵乘法示意
在集成光子方案中,向量元素被编码为波导中顺序传递的光脉冲幅度。乘法通过马赫-曾德尔干涉仪(MZI)实现:波导分叉,其中一路光的相位受电压控制,两路重组后的光强取决于相位差,从而完成乘法。矩阵元素编码在相移器中。最后,光电探测器收集所有脉冲执行累加。
Q.ANT 的方法通过片上调制器将输入数据编码为光脉冲的相位和振幅。虽然序列式处理比 Goodman 的全并行光学计算机慢,但可通过多波长复用缓解速度问题。Q.ANT 的原生处理服务器已在慕尼黑莱布尼兹超级计算中心和尤利希超级计算中心使用,并于今年早些时候向云提供商 Ionos 出售商业版本。
Lightelligence 的 PACE2 处理器可执行 128×128 矩阵乘法。2025 年发表的论文显示,其在 1 GHz 频率下延迟仅为 3 纳秒,比传统 GPU 低两倍。然而,能效优势尚未完全证实,主要瓶颈在于模数转换(ADC)的高能耗。Förtsch 承认,在快速低功耗转换器问世前,仍有漫长道路要走。
超越矩阵乘法:微分方程与非线性运算
并非所有公司都聚焦于矩阵向量乘法。光学傅里叶变换早在 20 世纪 50 年代就被研究,单个镜头即可完成信号分解,而数字芯片需数百至数千晶体管及更多周期。利用非线性函数的模型可用更少参数达到同等精度。
Q.ANT 认为其最大优势在于支持替代 AI 架构,如图像分类和分割任务中依赖的傅里叶变换及其他非线性运算。生成式 AI(特别是图像和视频生成)也展现出类似潜力。
以色列初创公司 LightSolver 也在寻找适配硬件的算法。CEO Ruti Ben-Shlomi 指出:“电磁波的传播本质上是在求解微分方程。”该公司的激光处理单元(LPU)旨在以更高能效和速度解决微分方程。
LightSolver 的 LPU 是 Goodman 设计的变体,包含输入光、可编程膜(SLM)和输出光,但置于一个腔体内,光在其中多次反弹直至稳定。腔内还放置了增益介质,功能类似激光器内部介质。一旦问题编码进调制器,增益介质受激发射随机光子,光子在通过增益介质时增强,并通过调制器经历预设变化,相互作用直至达到稳态——即解决方案。随后,相机拍摄稳态结果。仿真显示,其 LPU 解决微分方程的速度比 GPU 快 40 至 80,000 倍,具体取决于工作流程。目前,团队正在基准测试其能效改进,并开发基于自有算法的文本生成图像应用。Ben-Shlomi 强调:“我们做矢量矩阵乘法并不快,而是采用不同方法。若改变训练和推理方式,可显著降低能耗并加速图像生成。”
网络传输中的计算
英格兰利兹的 Optalysys 探索了另一种路径。创始人 Nick New 拥有自由空间光学背景,其核心理念是利用光学在自由空间的傅里叶变换能力。不同于使用镜头,Optalysys 采用被动组件层,通过巧妙设计多个输出组件提取不同数学运算。“我们可以使用模拟光子学方法以超高效率产生非常大的、高精度的数字函数,”New 说道。
Optalysys 的目标不是重新设计加速器,而是分担 AI 工作负载的一部分。随着光学连接日益靠近 GPU 和 CPU,部分计算已在数据传输过程中发生,如在网络交换机卡内合并多个 GPU 的结果。目前这些卡片使用电力计算,而通过被动光学组件,这些计算可基本“免费”完成。
除了 GPU 间通信,该技术还可用于促进 GPU 与内存间的通信,即时进行压缩和格式转换,从而改善解码阶段的性能。解码通常是内存绑定的,最昂贵的是模型数据的进出。New 表示:“我们更注重内存应用,这符合将处理添加到通信路径的原则。我们正在有效地增加目前没有的处理能力。”
光学计算的未来展望
光学计算机是否会取代 GPU?Logan Wright 并不乐观:“算法开发的方向不会自动有利于光学,因为 AI 模型开发者希望它在 GPU 上更好地工作。”
即便未来几年 AI 查询不完全由光学计算,相关投资也不会徒劳。Wright 指出,Nvidia 和 TSMC 等公司在联合封装光子学方面进行了实质性投资。无论该技术最终用于矩阵乘法、定制模拟还是网络内计算,计算生态系统似乎已准备好接纳多种方法。
Q.ANT 的 Förtsch 总结道:“我们将未来的数据中心视为异构系统:CPU、GPU 和光子 NPU [神经处理单元] 各自承担最适合的任务。在最高效的硬件上运行每项任务,可显著降低能源使用和运营成本。”