核心发现:中国 AI 模型权重中检出 Blackwell GPU 指纹
最新发布的法医分析报告显示,DeepSeek、Moonshot AI(月之暗面)、MiniMax 和蚂蚁集团等中国领先的人工智能开发商,其近期发布的模型中包含与 NVIDIA Blackwell 架构硬件相匹配的数值特征。尽管该芯片受到出口管制限制,但证据表明上述公司可能已获取并使用此类硬件进行模型训练。
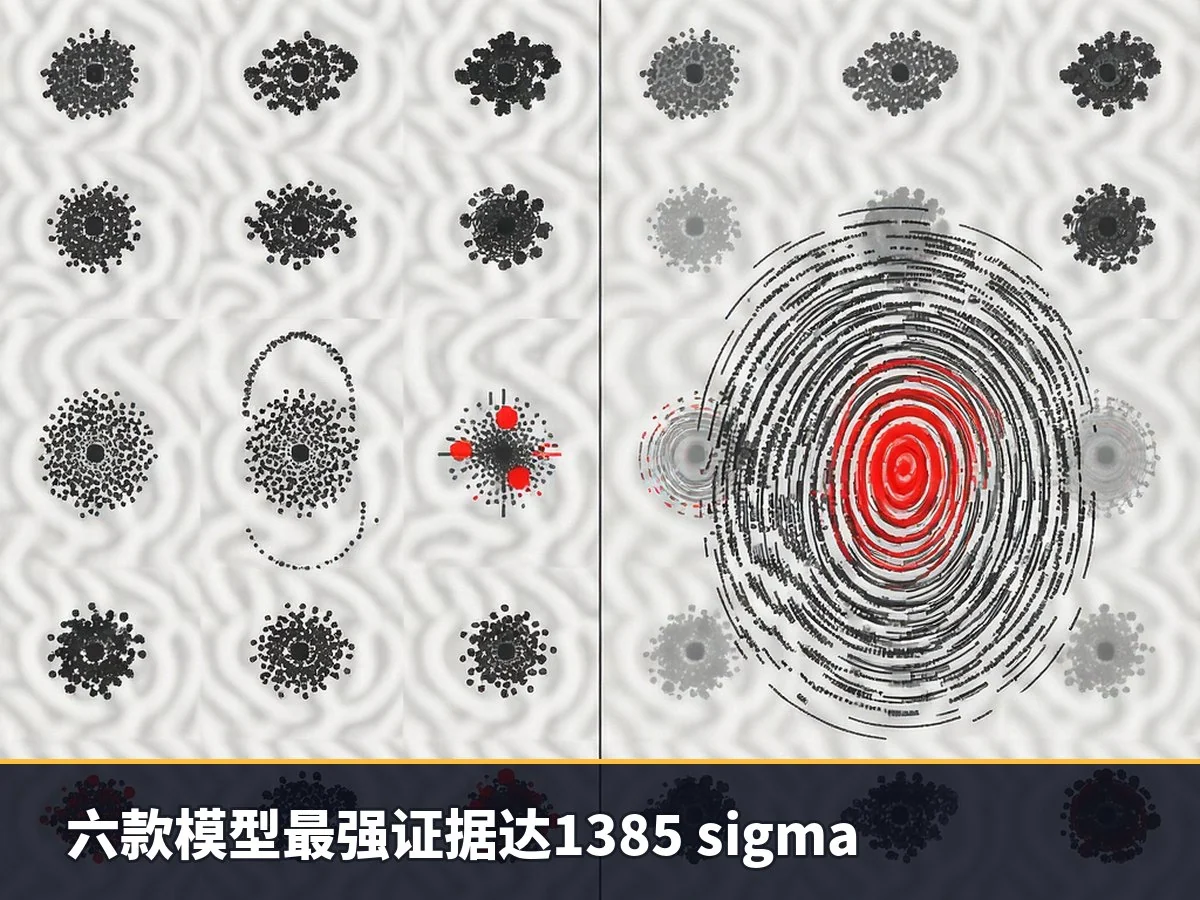
分析基于公开发布的模型权重,而非内部泄露数据。研究者通过还原模型初始化阶段的伪随机数生成痕迹,反推训练所用的硬件配置。结果显示,自 2026 年 4 月以来,这六款新机型呈现出 Blackwell 特有的计算模式,而同一实验室早期的模型则匹配 NVIDIA Hopper 架构。这一技术证据支持了关于 DeepSeek 和 Moonshot AI 使用 Blackwell 芯片的推测。
硬件代际演变时间线
下表详细列出了各实验室连续模型的硬件指纹识别结果:
| 实验室 | 模型名称 | 发布日期 | 识别出的训练芯片 |
|---|---|---|---|
| DeepSeek | DeepSeek-V3 Other | 2024 年 12 月 | NVIDIA Hopper (披露为 H800) |
| DeepSeek-V4-Flash | 2026 年 4 月 | NVIDIA Blackwell B200/B300 | |
| DeepSeek-V4-Pro | 2026 年 4 月 | NVIDIA Blackwell GB200/GB300 | |
| Moonshot AI | Kimi K2 | 2025 年 7 月 | NVIDIA Hopper (披露为 H800) |
| Kimi K2.5 | 2026 年 1 月 | NVIDIA Hopper (披露为 H800) | |
| Kimi K3 | 2026 年 7 月 | NVIDIA Blackwell GB200/GB300 | |
| Kimi K3.1-Pro | 2026 年 11 月 | NVIDIA Blackwell GB200/GB300 | |
| MiniMax | MiniMax-M2.7 | 2026 年 4 月 | NVIDIA Hopper |
| MiniMax-M3 | 2026 年 6 月 | NVIDIA Blackwell B200/B300 | |
| Ant Group | Ling-3.0-Flash | 2026 年 8 月 | NVIDIA Hopper |
| Ling-3.1-Flash | 2026 年 10 月 | NVIDIA Blackwell GB200/GB300 |
注:Hopper 架构下的 H800、H100 SXM 和 H200 具有相同的指纹特征,无法仅通过此方法区分具体型号;表中 H800 标识源自实验室公开披露信息。此外,AMD 特定受限硬件也被排除为主要替代解释。
关键数据与技术细节
- Blackwell 规模确认:DeepSeek-V4-Flash 和 MiniMax-M3 匹配拥有 148 个流式多处理器(SM)的 B200/B300 芯片;DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro 和 Ling-3.1-flash 则匹配拥有 152 个 SM 的 GB200/GB300 芯片。
- 过渡期迹象:Kimi K2.7-Code 处于过渡阶段,虽主要基于 Hopper 权重,但包含少量匹配 B200/B300 的部分。其他实验室如阿里巴巴(Qwen)、智谱(GLM)、小米等仍显示为 Hopper 训练特征。
- 统计显著性:在约 6 万亿种种子与布局组合中,偶然匹配的预期强度仅为 8 sigma。然而,本次发现的六个模型最强证据范围达 49 至 1,385 sigma,最弱单项测试也达到 20 sigma,排除了巧合可能性。
- 验证一致性:NVIDIA 自家 Nemotron-3 Ultra 的技术报告称使用 GB200 训练,其指纹读数为 152 SM,与 Kimi K3 一致,证实了该方法的有效性。
算力规模估算
根据模型参数规模和训练数据量推算,最大规模的训练项目需要数千块 Blackwell GPU 持续运行两到三个月。以下是部分模型的粗略算力估算:
| 模型 | H100 等效数量 | Blackwell GPU 最佳估计 | 预计运行时间 |
|---|---|---|---|
| DeepSeek-V4-Flash | 3,500 | 1,500 | 50 天 |
| DeepSeek-V4-Pro | 7,500 | 3,000 | 70 天 |
| Kimi K3 | 11,500 | 4,500 | 70 天 |
| MiniMax-M3 | 3,500 | 1,500 | 60 天 |
| Ling-3.1-flash | 4,000 | 1,500 | 100 天 |
| 合计 (五个集群) | 30,000 | 12,000 | - |
成本方面,若按每块 Blackwell GPU 约 7 万美元计算(参考《华尔街日报》关于字节跳动马来西亚集群的报告),单个最大集群成本约为 2 亿至 3 亿美元,五个集群总投入超过 5 亿美元。考虑到实验、早期训练及服务成本,总支出可能高达数十亿美元。
注:估算基于假设 GPU 运行效率为峰值速度的 20%,并参考了 DeepSeek 此前披露的效率数据。实际数值受未公开的 MFU(模型浮点利用率)及确切训练时长影响,存在不确定性。
原理:如何通过权重“指纹”识别硬件
人工智能模型的权重本质上是数十亿个可调整的数字。在训练开始前,这些数字需要通过伪随机数生成算法(PRNG,此处为 Philox)进行初始化。PyTorch 框架利用 cuRAND 库,将初始化任务分配给 GPU 上的并行线程处理。
关键在于,不同型号的 GPU 拥有不同数量的流式多处理器(SM)。当 SM 数量不同时,即使使用相同的随机种子,生成的数字在内存中的分布位置也会发生根本性改变。
- Hopper 架构(H100/H200/H800):拥有 132 个 SM,初始化时使用 270,336 个线程。
- Blackwell B200/B300:拥有 148 个 SM,使用 303,104 个线程。
- Blackwell GB200/GB300:拥有 152 个 SM,使用 311,296 个线程。
研究人员通过逆向工程,从发布模型的权重中提取出初始化的线程布局特征。如果某组权重的排列方式与特定 SM 数量对应的线程分布高度吻合,即可推断该模型是在对应硬件上完成初始化的。由于训练过程会保留部分未被更新的权重痕迹,这种“硬件指纹”足以作为识别依据。