8位时代的游戏编程:从常规优化到堆栈奇技
在8位PC时代,游戏硬件性能极其有限。为了在当时的标准下实现可玩的速度,早期游戏程序员不得不采用各种极端的底层优化手段。本文回顾了一个关于6809处理器上背景图块渲染优化的经典案例,展示了如何通过挖掘指令集特性将性能提升数倍。
背景:不可玩的街机移植
故事始于一名程序员试图将一款当时流行的街机代币游戏移植到80年代的PC平台。尽管代码逻辑严谨,但移植后的版本运行缓慢且帧率波动剧烈,严重破坏了侧滚动游戏的沉浸感。
经过初步审查,发现常规优化手段已无所不用其极:循环展开、消除冗余调用、清理死代码等均已实施。然而,瓶颈依然存在——大部分时间消耗在背景图块的重新绘制上。对于每一帧,程序都需要根据玩家位置移动近一个屏幕宽度的背景数据。
硬件限制与基础实现
当时的图形硬件不具备纹理映射或自动缩放功能,所有像素操作必须由CPU逐字节完成。以该游戏为例,背景图块尺寸为28x28像素,每个像素占用4位(半字节),支持16种颜色。因此,一行图块在内存中占据14个连续字节。
屏幕缓冲区分辨率为320x240像素,每行占160字节。将源图块复制到屏幕缓冲区时,需处理28行数据。利用6809处理器的自动增量寻址模式,基础复制逻辑如下:
    LDU ,X++     ; 读取源图块的一个字(2字节=4像素)
    STU ,Y++     ; 写入屏幕缓冲区
复制一行需要执行7次上述操作。完整的单行复制子程序包含外层行循环和内层字循环,初始版本的执行效率较低。
第一轮优化:循环展开与偏移寻址
通过计算机器周期,开发者发现原始内层循环每次复制4像素需消耗21个周期。复制一行共需约157个周期。
第一步优化是手动展开循环,消除了分支判断和计数器递减的开销,使每行耗时降至120个周期,提速30%。
更激进的优化在于替换昂贵的自动增量操作。6809处理器中,,X++ 指令耗时3个周期,而带固定偏移量的直接寻址如 2,X 仅耗时1个周期(0偏移为免费)。由于源和目标地址的相对位置已知,程序员改用精确偏移量进行读写:
    LDU  ,X                 ; 5 cycles
    STU  ,Y                 ; 5
    LDU 2,X                 ; 6
    STU 2,Y                 ; 6
    ... (重复至第7个字)
    LEAX TILW,X             ; 8 (finishing)
    LEAY SCRW,Y             ; 8 (finishing)
这一改动将每行复制的周期数进一步压缩至98个,相比原始代码提速60%。尽管如此,对于实时渲染而言,这仍然不够快。
疯狂的想法:利用堆栈寄存器并行传输
为了寻求突破,开发者查阅了《6809微处理器编程手册》,发现了两个关键特性:PSHS/ PULS 指令和 DP 寄存器。
与同时期的6502处理器不同,6809允许使用单条指令将多个寄存器压入或弹出硬件堆栈。PULS D,X,Y 仅需11个周期即可传输6个字节。更重要的是,6809拥有两个堆栈指针寄存器:S 和 U。
新的策略是将 S 指向源图块,U 指向屏幕缓冲区。通过交替执行 PULS(从S读入D,X,Y)和 PSHU(推入U),可以实现高速的数据搬运。
初步方案如下:
    PULS D,X,Y    ; first 6 bytes    11 cycles
    PSHU D,X,Y    ;                  11
    PULS D,X,Y    ; second 6 bytes   11
    PSHU D,X,Y    ;                  11
    PULS D        ; final 2 bytes     7
    PSHU D        ;                   7
    LEAU -WOFF,U  ; advance dst ptr   8
此方案每行耗时66个周期。虽然比之前的98周期有显著改进,但最后两字节的处理因无法整除而显得笨拙。
终极优化:利用DP寄存器凑整
6809的另一个独特之处在于 DP(Direct Page)寄存器。它类似于其他架构中的“零页”概念,但可以由软件指定任意页面作为直接页。由于当前的数据复制逻辑不需要访问直接页,DP 寄存器可以被征用为额外的数据传输通道。
将 DP 加入堆栈操作后,单次 PULS/PSHU 对可以传输7个字节(D, X, Y, DP各2字节,共8字节?注:原文此处逻辑为利用DP作为额外go-between,实际上6809的PULS/PUSH通常按字对齐,但此处特指利用DP的低字节或特定组合达到7字节有效载荷的巧妙构思,原文描述为“copy 7 bytes per pull-push pair”)。鉴于图块行宽为14字节,恰好能被7整除。
最终实现的单行复制代码仅需5条指令:
    PULS D,X,Y,DP  ; first 7 bytes    12 cycles
    PSHU D,X,Y,DP  ;                  12
    PULS D,X,Y,DP  ; second 7 bytes   12
    PSHU D,X,Y,DP  ;                  12
    LEAU -WOFF,U   ; advance dst ptr   8
总耗时仅为56个周期。这意味着利用了机器上几乎所有可用的通用寄存器(D, X, Y)以及特殊的堆栈指针(S, U)和直接页指针(DP),实现了极致的字节搬运效率。
潜在缺陷:数据顺序反转
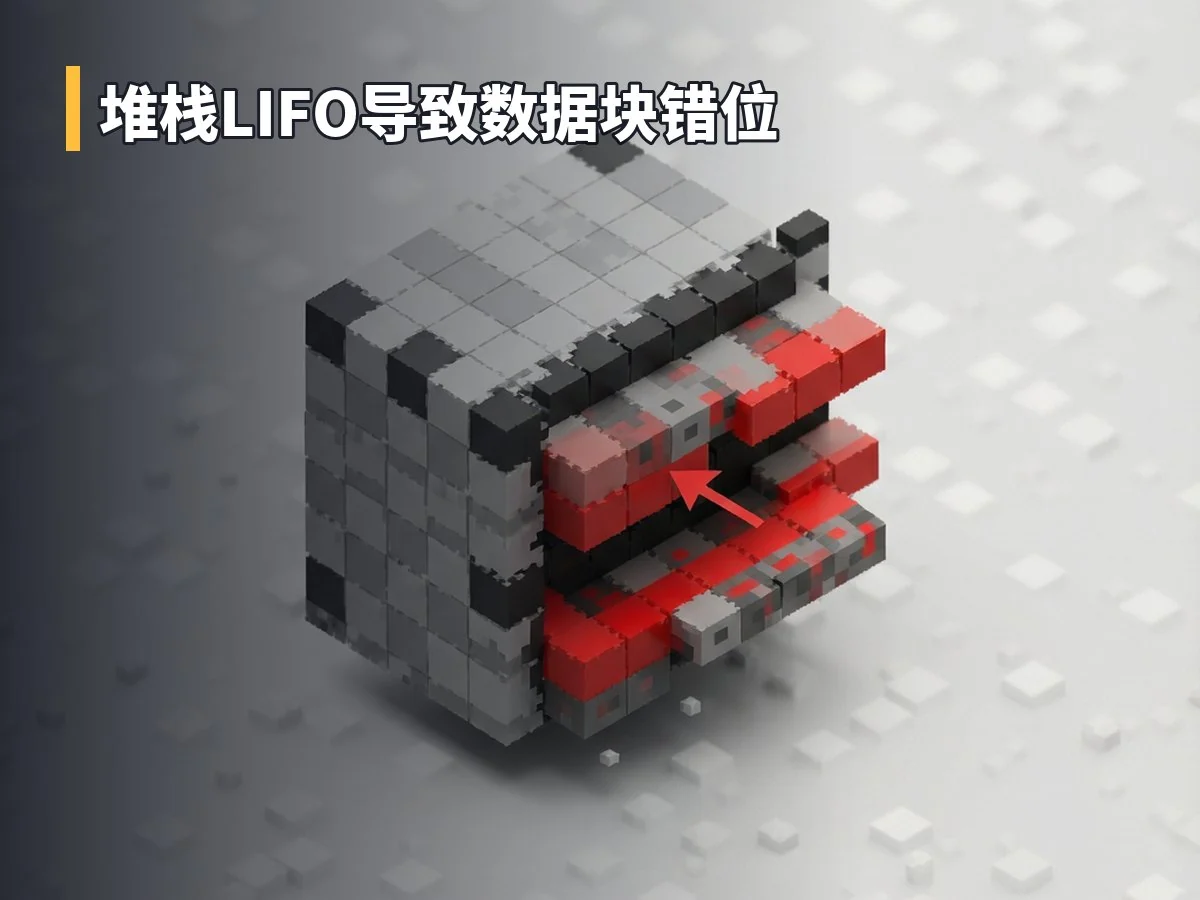
然而,这种基于堆栈的操作存在一个隐蔽的逻辑陷阱:堆栈的后进先出(LIFO)特性导致数据在传输过程中发生块级交换。
当以7字节为单位从源地址拉取并推送到目标地址时,原本连续的14字节序列 [0...6][7...13] 会被拆分为两个七元组。由于堆栈操作的对称性,如果未对指针方向或数据布局进行特殊处理,屏幕上显示的可能是 [7...13][0...6],即左右两半发生了水平互换。
尽管单个七元组内部的字节顺序保持不变,但这种块间的错位会导致图像撕裂或显示异常。解决这一问题通常需要调整源数据的预排列方式,或在渲染管线中引入额外的修正步骤,这也凸显了在极端优化下保持数据一致性的复杂性。