Nvidia 的 Vera CPU 标志着其在人工智能基础设施领域的进一步演进。随着 AI 工作流程的转变,数据中心对高性能 CPU 的需求急剧增长。尽管针对此类工作负载的标准化端到端代理基准尚未建立,但现有数据显示,Vera 在 Python 等构成 AI 软件生态系统支柱的语言中表现卓越。
Vera 展示了强大的内存带宽,这不仅体现在单插槽层面,更通过芯片间的高速 C2C 互连实现了系统级的高吞吐量。在涉及大型数据库查询等高带宽需求的代理环境中,这一特性尤为关键。尽管服务器市场竞争激烈,Vera 不仅在代理相关的工作负载中表现出色,在通用服务器任务中也提供了高效性能,经常能够匹配甚至超越同级的 AMD EPYC Torino(都灵)和 Intel Granite Rapids-AP 处理器。
在前端工作负载方面,x86 架构凭借更高的核心密度通常占据优势;而在后端数据密集型操作中,Vera 则通过强劲的单核性能和内存带宽弥补了密度上的差异。
| 核心/线程 | 88 / 176 |
| L2 缓存 | 每核心 2MB |
| L3 缓存 | 每 CPU 164MB |
| 内存 | 最高支持 1.5 TB SOCAMM2 LPDDR5X |
| 内存速度 | 最高 9600 MT/s |
| 存储带宽 | 聚合最高 1.2TB/s (约 14GB/s 每核心) |
| PCIe | 88 条 PCIe 6.4 通道 (仅 CPU), 96 条 PCIe 6.4 通道 (Vera Rubin),支持 x2 分叉及 CXL 3.1 |
| 可配置 TDP | 250W - 450W |
作为 Nvidia 首款采用定制 Olympus 核心的产品,Vera 相比 Grace 架构有了显著改进。这款基于 Armv9.2-A 架构的 88 核 CPU,通过 Nvidia 的空间多线程技术实现每核心双线程。该芯片具备类似 Arm AGI 的 10 宽解码能力,并集成了第二代可扩展一致性面料(SCF)。SCF 将 L3 缓存分布在模块网格上,提供高达 3.4TB/s 的内部带宽。
Vera 利用可更换的 SOCAMM2 LPDDR5X 内存,以 9600 MT/s的速度运行,提供总计 1.2 TB/s 的内存带宽,即每核心约 14 GB/s。这一数值是 AMD 高密度 Torino 设计的两倍多。
在 AMD Venice 和 Intel Diamond Rapids 正式推出之前,了解 Vera 在现代 AI 数据中心中的定位至关重要。
| 测试平台 | Memory | 经过测试的处理器 |
| 2P Nvidia MGX Vera 参考平台 | 16 x 96 GB (1.5 TB) Samsung LPDDR5-9600 ECC SOCAMM2 | Nvidia Vera |
| 2P Supermicro SYS-222HA | 24 x 64GB (1.5 TB) Micron DDR5-8800 ECC MRDIMM | Intel Xeon 6980P |
| 2P AMD Volcano 参考平台 | 24 x 64 GB (1.5 TB) SK hynix DDR5-6000 ECC RDIMM | AMD EPYC 9965, EPYC 9755 |
理解 CPU 在代理式 AI 中的作用
在快速发展的智能 AI 领域,对“智能 CPU”的定义因应用场景而异。鉴于代理式(Agentic)CPU 重要性的提升,其角色主要由 AMD 和 Nvidia 两家公司的观点所定义。虽然它们在并发性和多样性工作负载方面的观点具有参考价值,但从实际部署角度理解更为准确。
回顾真实的代理工作流程有助于明确 CPU 在其中的位置。如 Meta Muse 和 OpenAI Dots所示,持久代理允许在云端进行小规模计算。这些纯 CPU 机架与推理服务器通信以运行模型,其工作负载由并发性定义。重点不在于单个沙箱的性能,而在于芯片满载时每个沙箱的表现。
对于某些高要求工具调用,如代码编译和大型数据库查询,同步机制提供了重要背景。然而,读写文件、运行代码测试和无头浏览器操作并不单独依赖 CPU 算力。当芯片处理数千个工具调用时,细微的优势便会累积。随着代理会话增加,CPU 在维持性能方面发挥更大作用。
代理式 CPU 的核心原则之一是在高并发下保持性能,另一原则是可变性,这影响了 CPU 及整体基础设施。Google Cloud 人工智能和计算基础设施副总裁 Mark Lohmeyer 向 Tom's Hardware 描述了一个使用 AI 规划假期的例子:用户可能突然发起大量请求,随后长时间闲置。这种爆发式负载导致资源利用率波动剧烈,若硬件调度不当,可能影响所有会话。这也改变了 CPU 的工作类型,包括重代码编译、图形遍历和大数据库查询。多个代理独立循环运行,无法整齐对齐。
2026 年 8 月,德克萨斯大学奥斯汀分校与 Microsoft Azure 研究人员发表的《代理式 AI 工作流的架构影响》论文指出,CPU 在代理流中承担三项主要任务:除了作为 GPU 推理的调度器外,还负责一次性 LLM 查询、维护代理状态和通信的编排器,以及执行代理逻辑(通常为 Python)的工具调用运行器。
当多个代理同时向 GPU 发送请求、接收响应并执行操作时,基于 CPU 的小任务如何对齐以及在 GPU 空闲期间产生的延迟变得可见。
Nvidia 明确表示 Vera 是一款代理式 CPU,尽管定义代理循环性能仍在进行中。“行业已经建立了相当好的传统工作负载基准测试方法,”Lohmeyer 表示,“我认为这种情况正在发生在用于推理的 GPU 和 TPU 上。我们需要类似的行业级基准来评估代理式工作负载,而这些标准目前仍处于新兴阶段。”
目前尚无针对整个代理环节的标准基准测试。虽然内部测试正在进行,且像 Modal 这样的公司已在供应商层面进行了一些基准测试,但更广泛的行业尚未提出一套类似于 SPEC 或 TPC 的端到端代理循环基准。
尽管缺乏完整基准,仍可通过代理工作流的视角审视 CPU 性能,优先考虑对代理循环重要的方面。例如,通过分析编码代理的代码编译、检索代理的数据库性能,以及使用 simdjson 库分析大型 JSON 文件和 Python 生态基础,可以评估 CPU 表现。本文的重点在于确定 Vera 在已知基准测试中与 AMD 和 Intel x86 竞争对手的位置。
Nvidia 未限制测试范围或内容覆盖。感谢 Nvidia 提供双插座 Vera 系统的远程访问权限进行测试,其中包括适用于代理工作流的测试,以及 Java、加密、压缩和渲染等通用服务器 CPU 基准测试套件。
给读者的提示
服务器不同于客户端 PC。运营商拥有更深入的硬件和软件堆栈访问权限,且软件通常仅适用于特定工作负载。对于客户端 CPU,可以说某款芯片最适合游戏或拥有最高单线程性能。但在服务器领域,用例决定一切。
典型评测中会得出“X 优于 Y”的结论并用数据支持。但在本评测中,结论更为谨慎。超大规模云服务商拥有多样化的硬件组合,企业需根据运营需求及其他十几个业务变量选择最合适的硬件。
Nvidia Vera SPEC CPU 2026 估算值
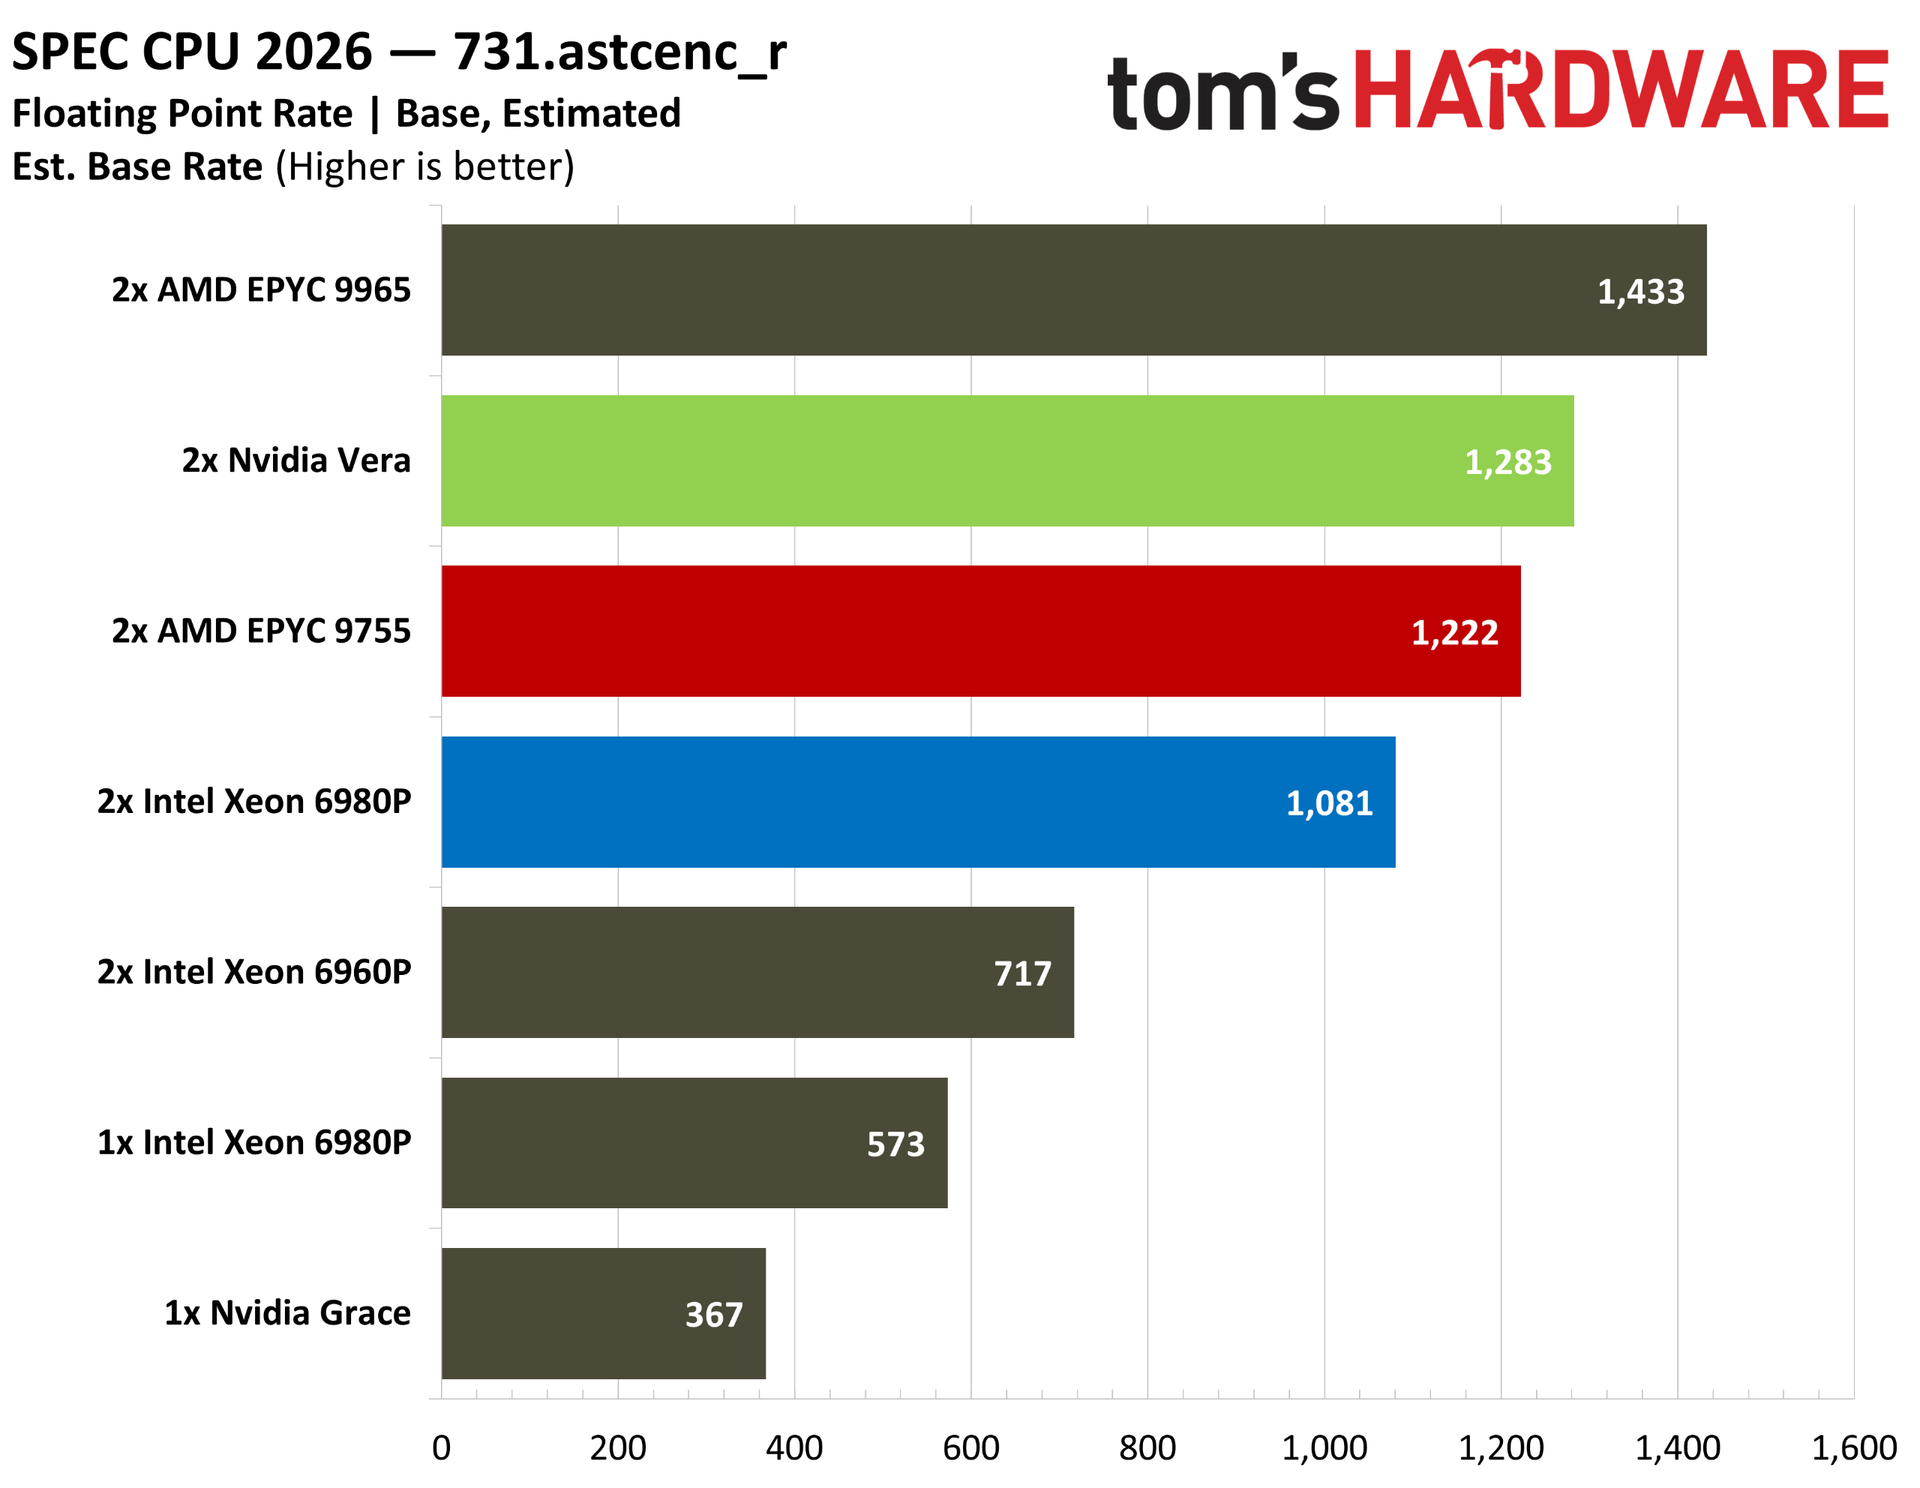
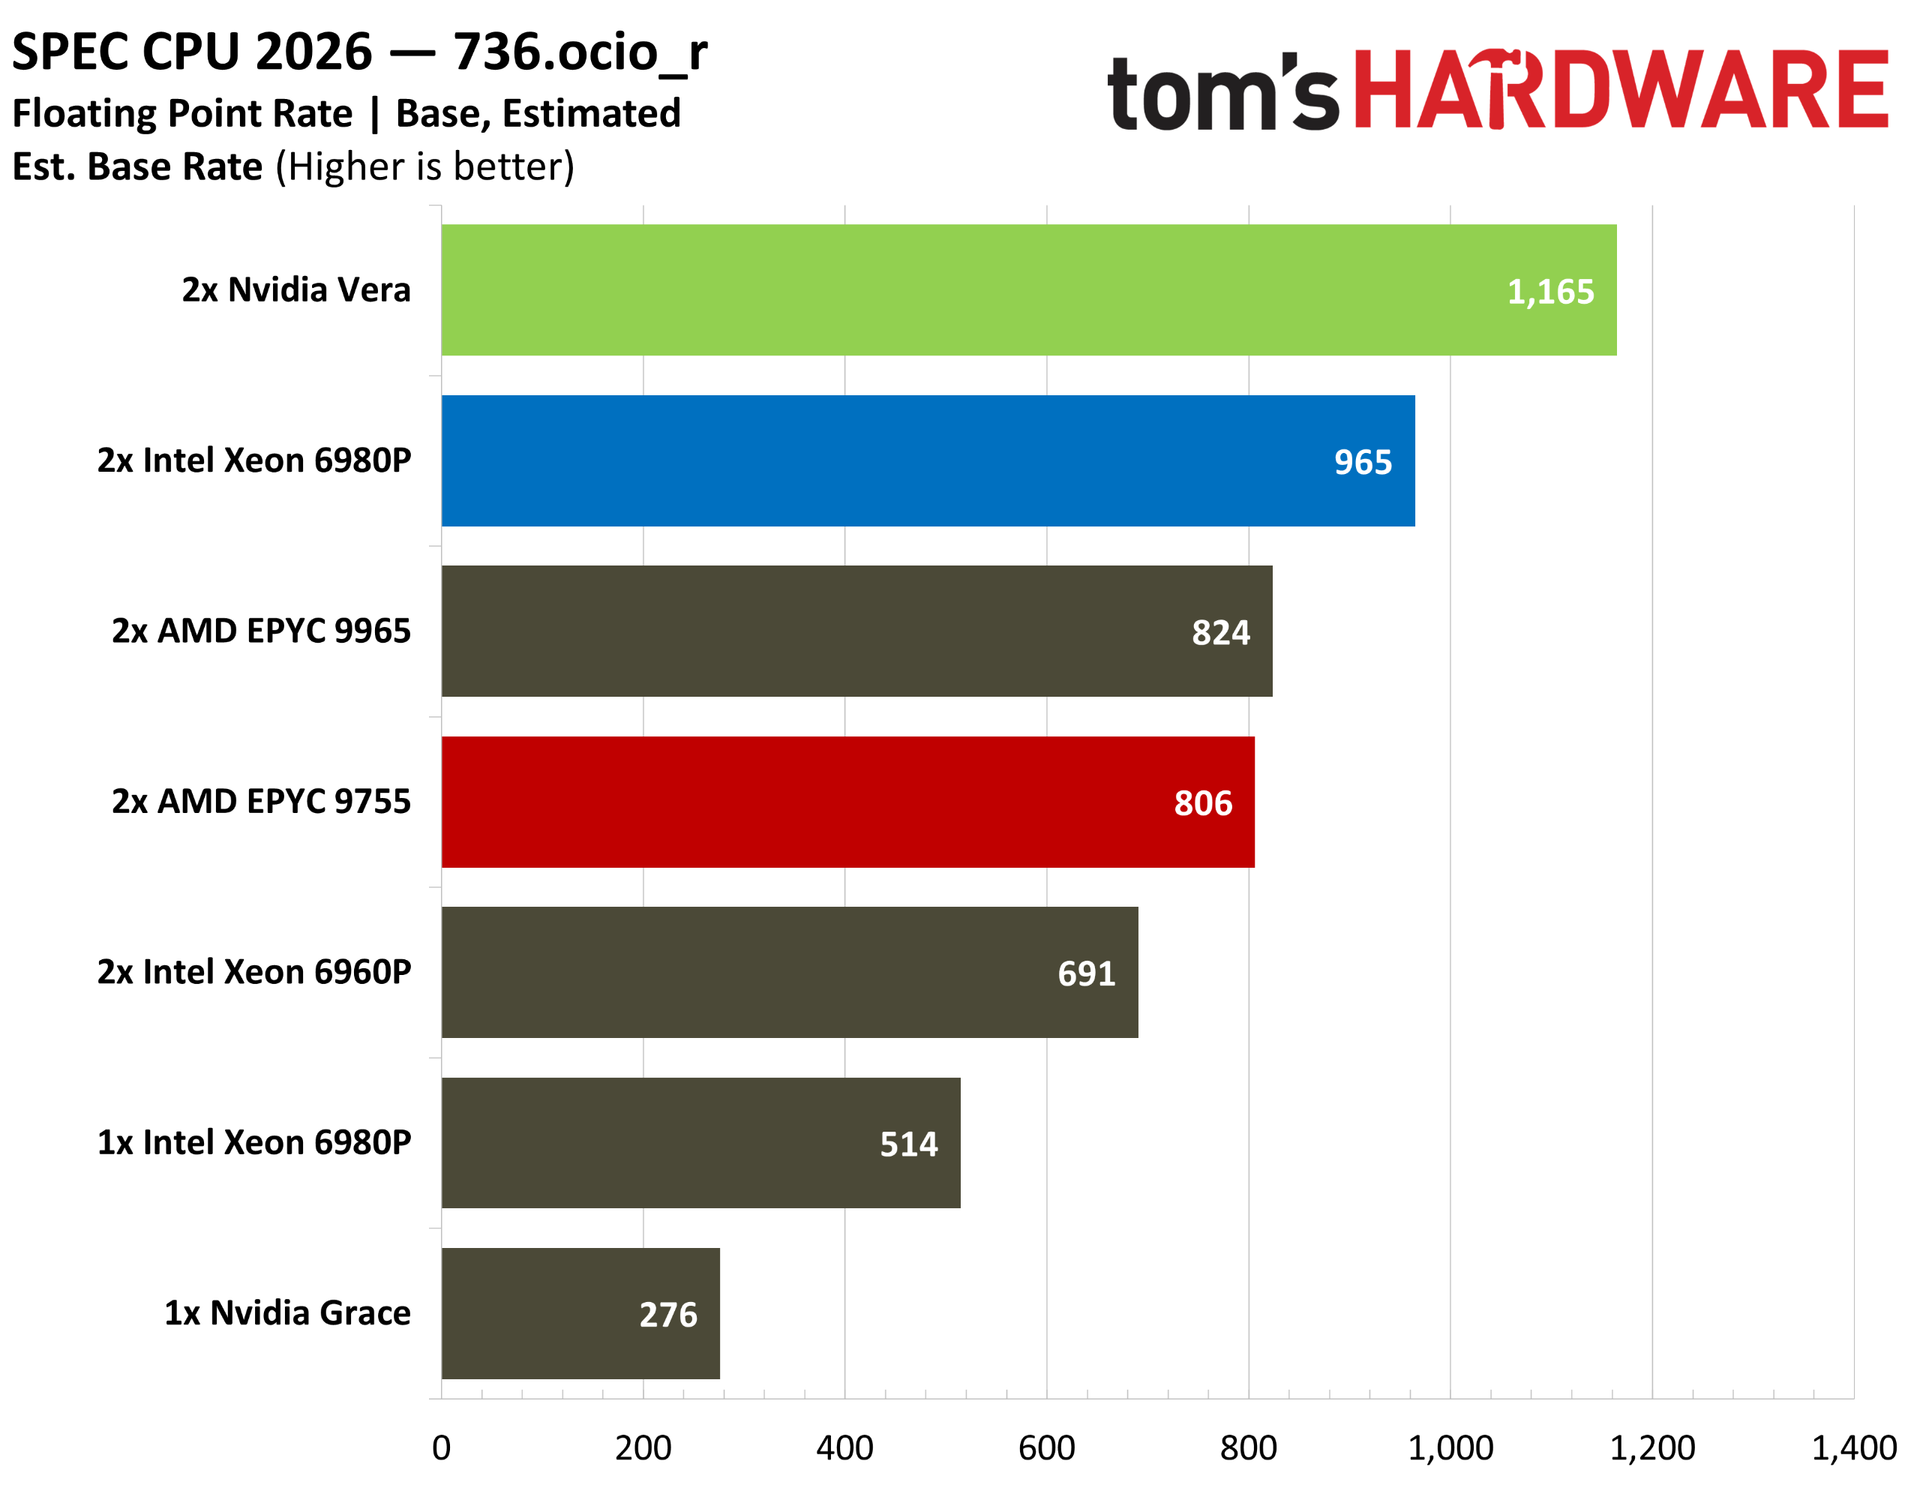
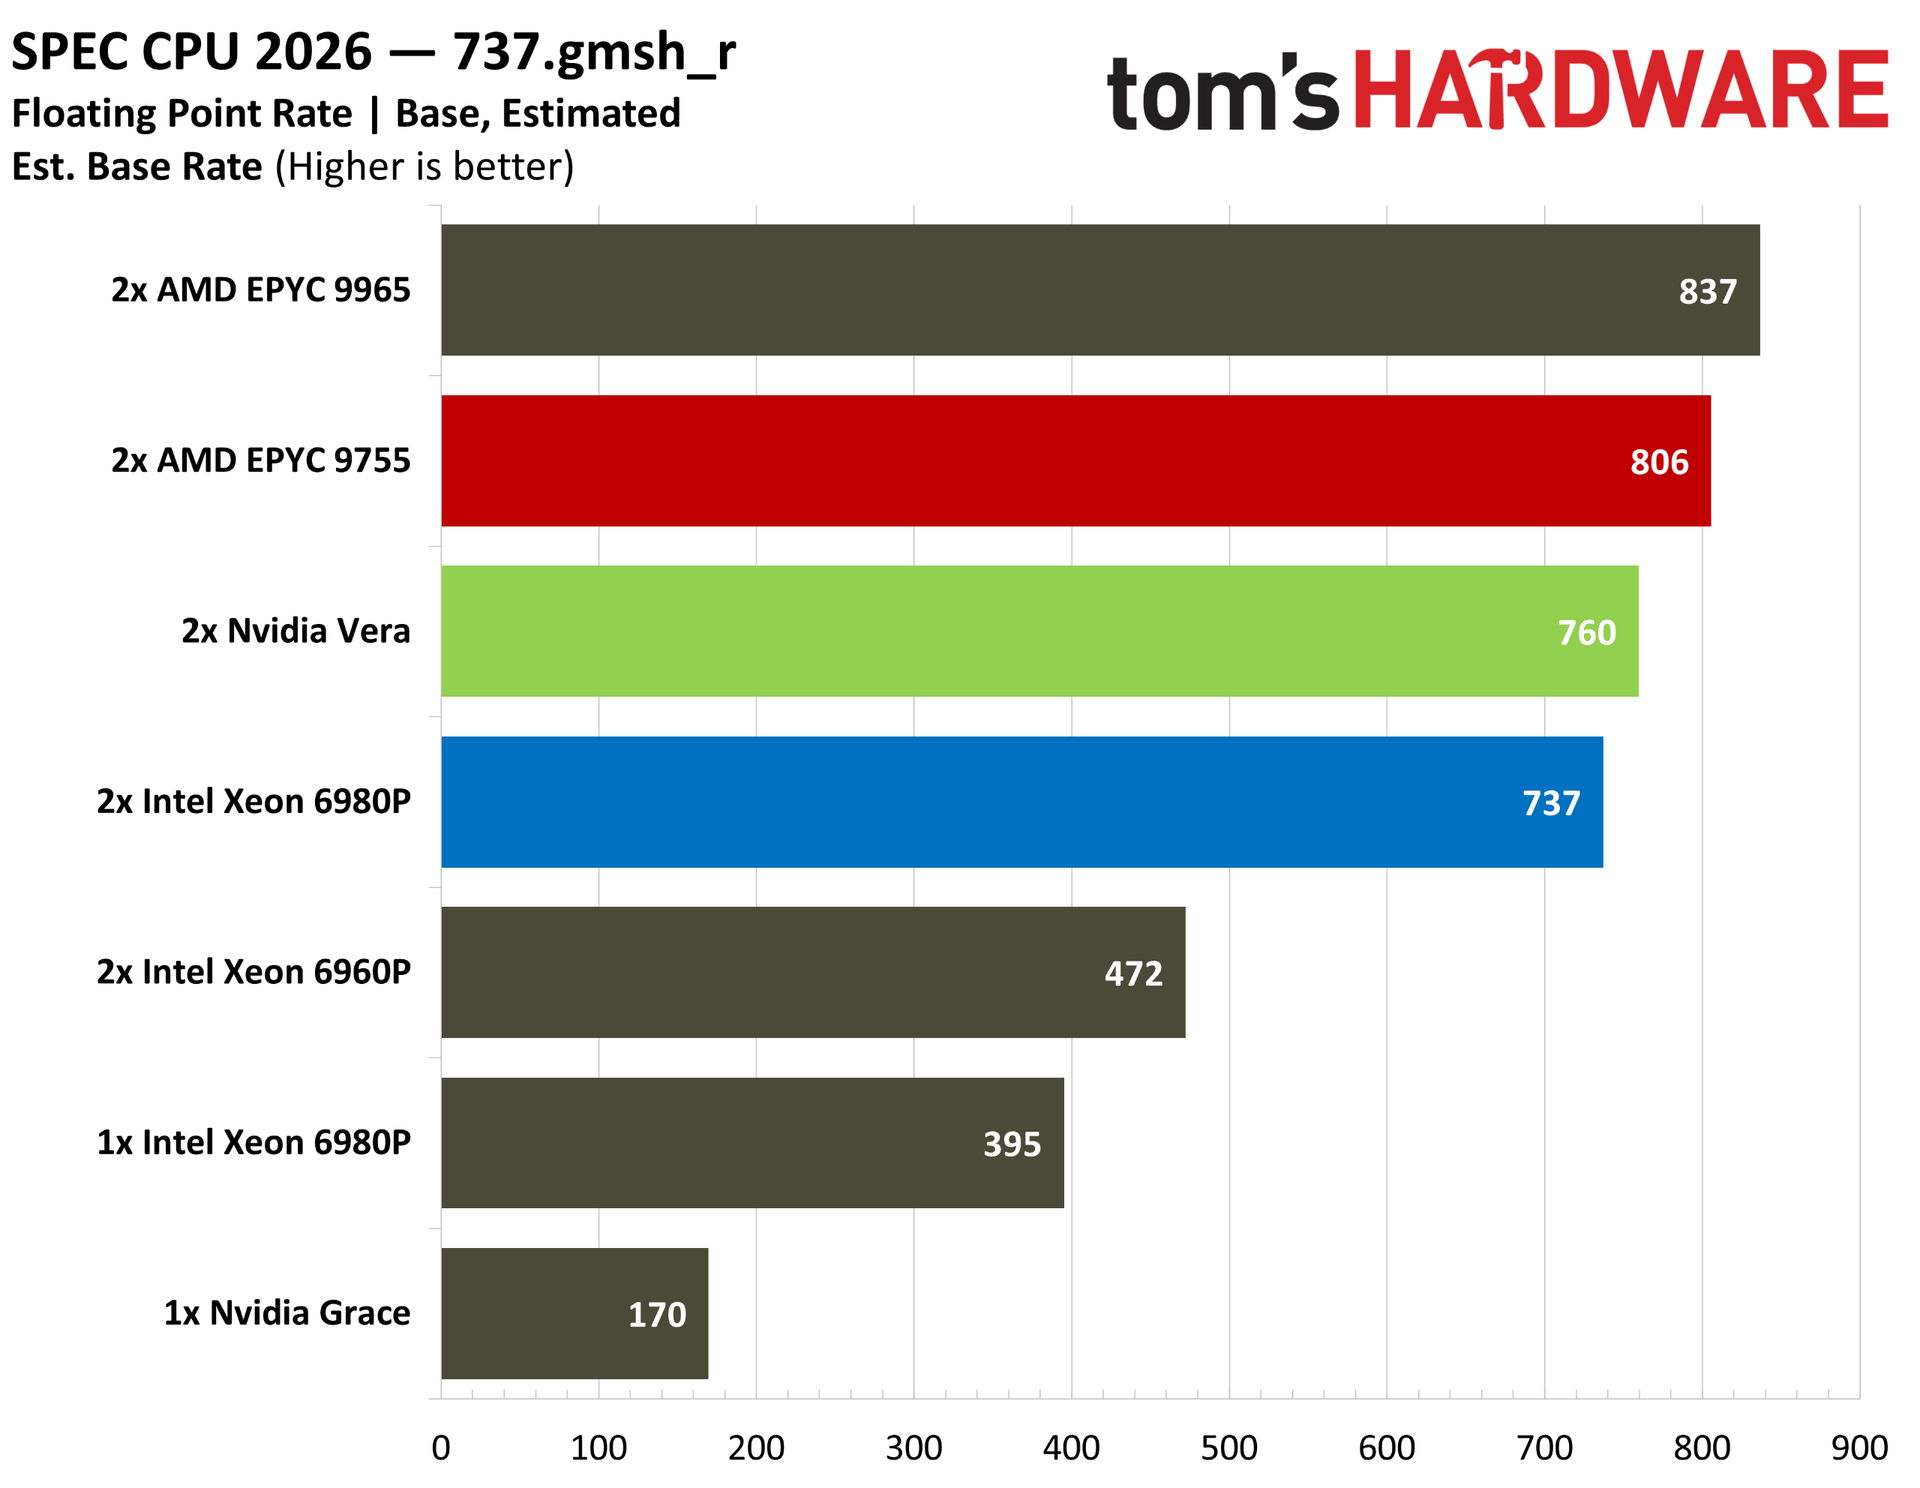
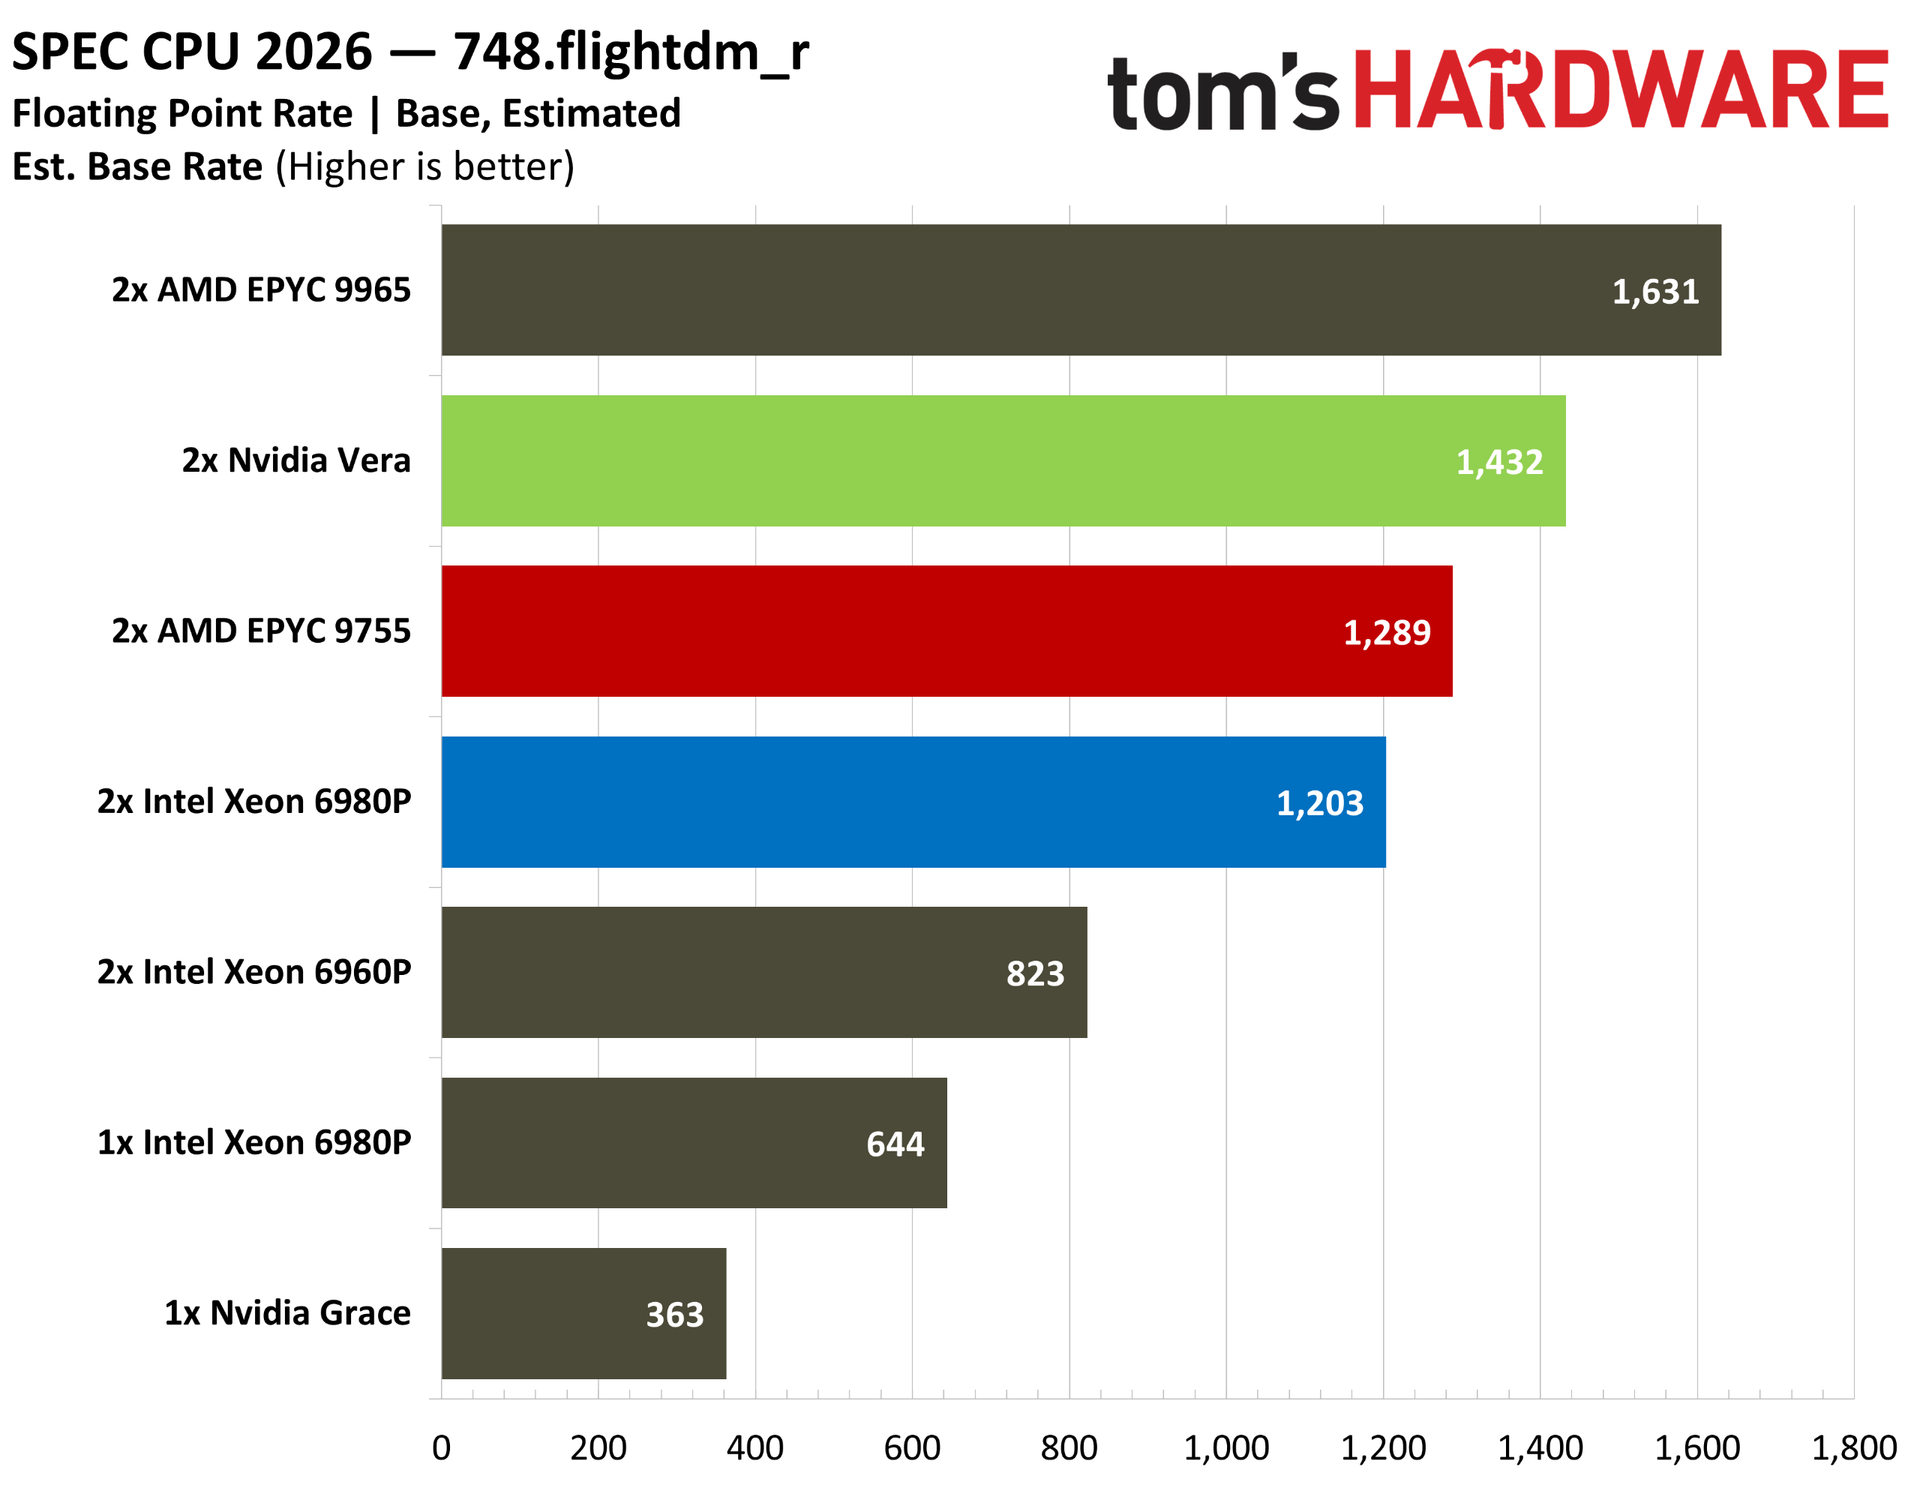
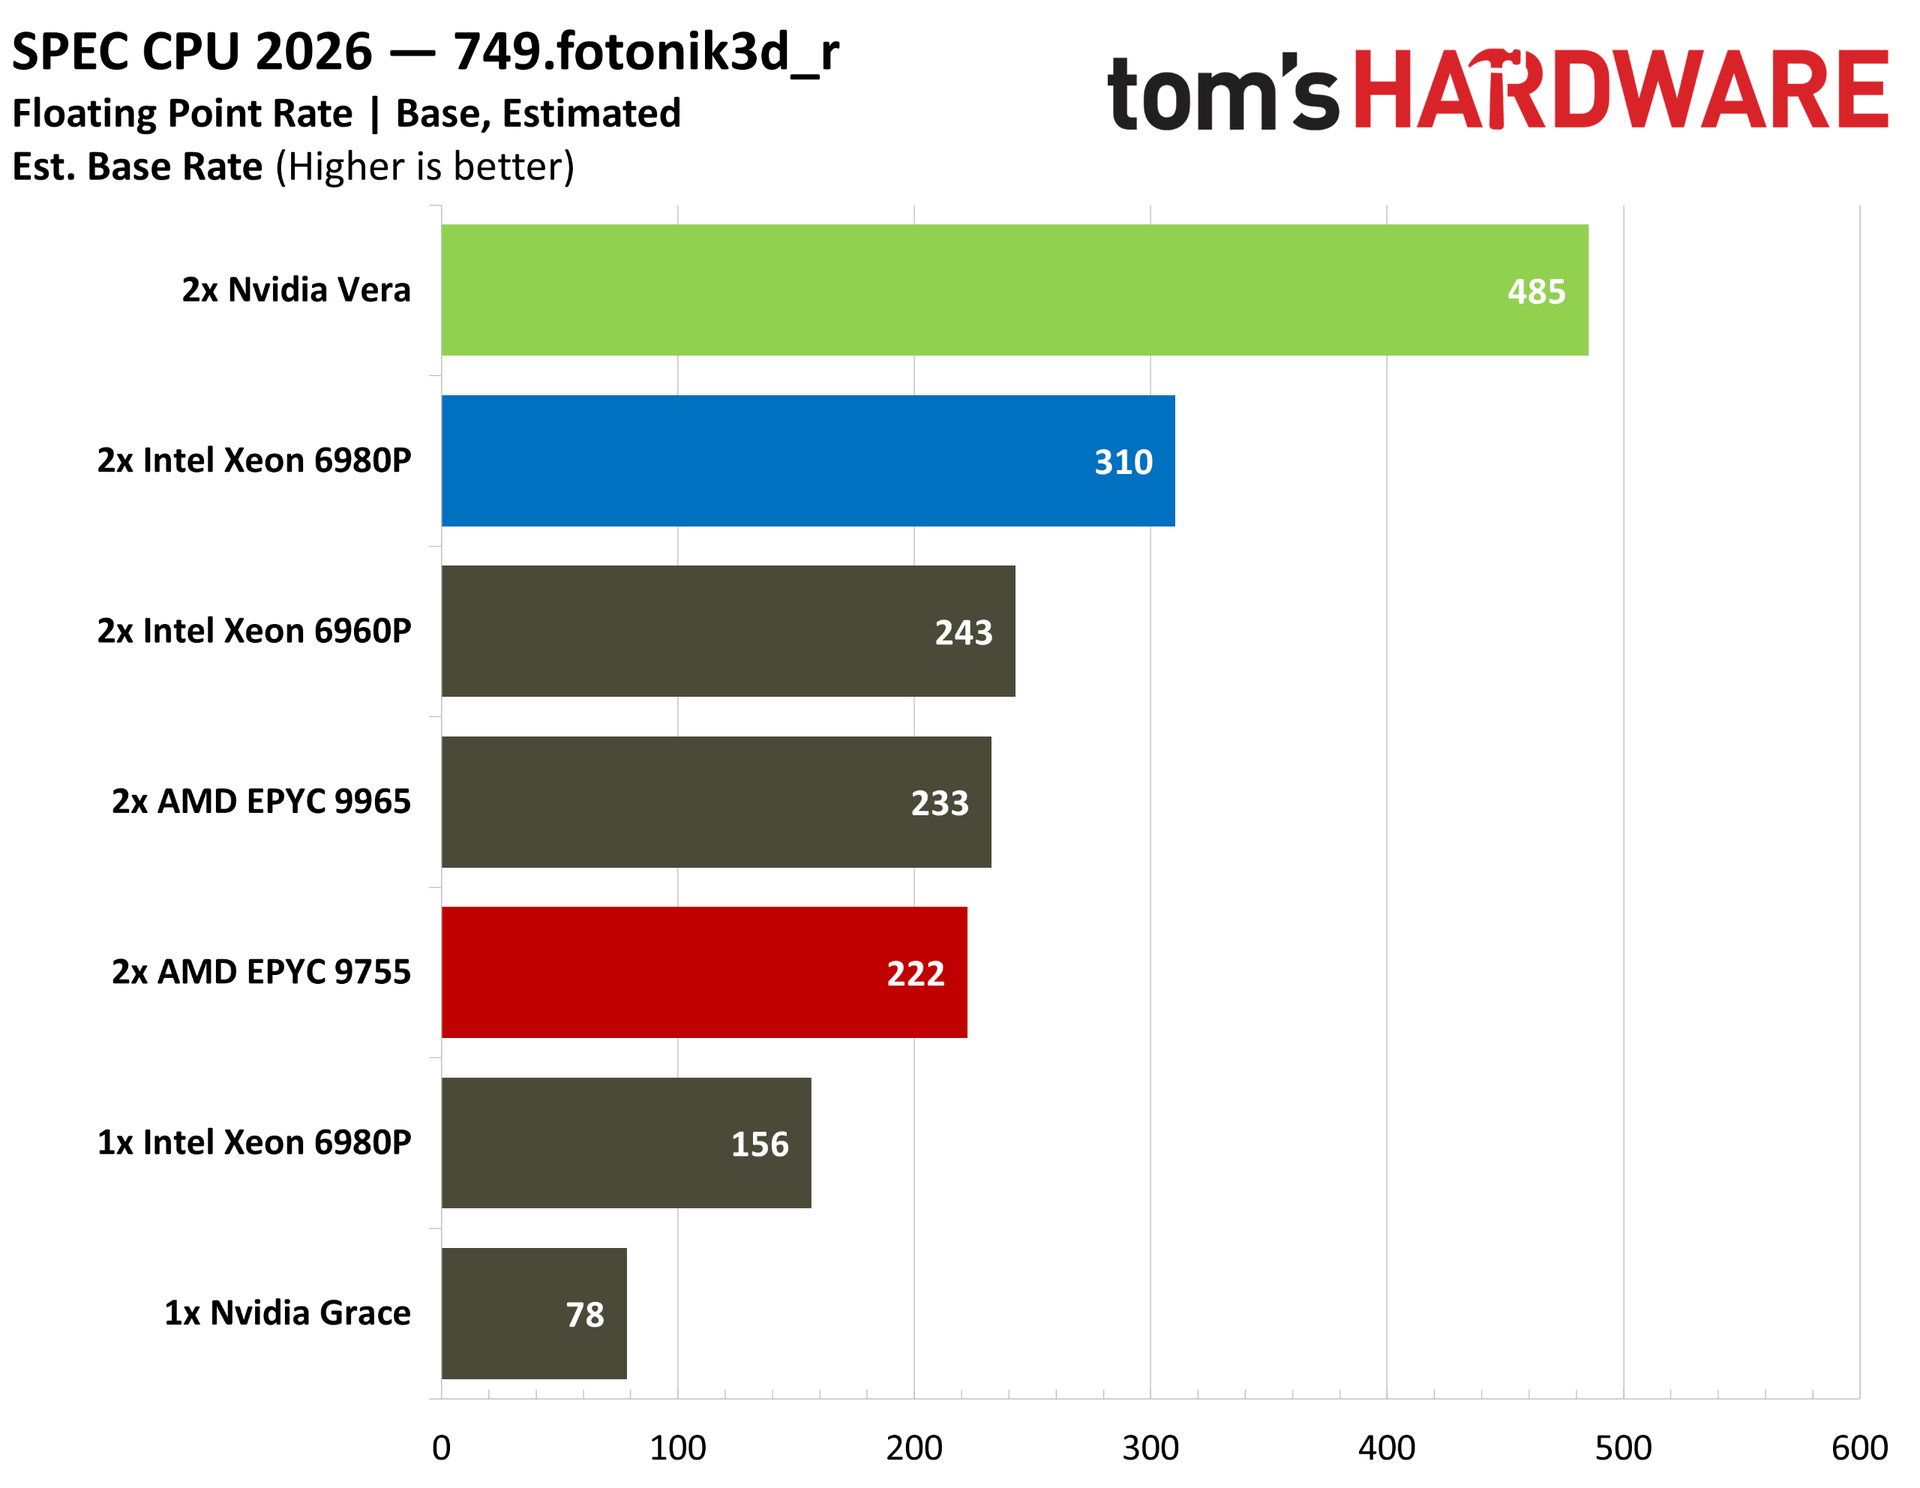
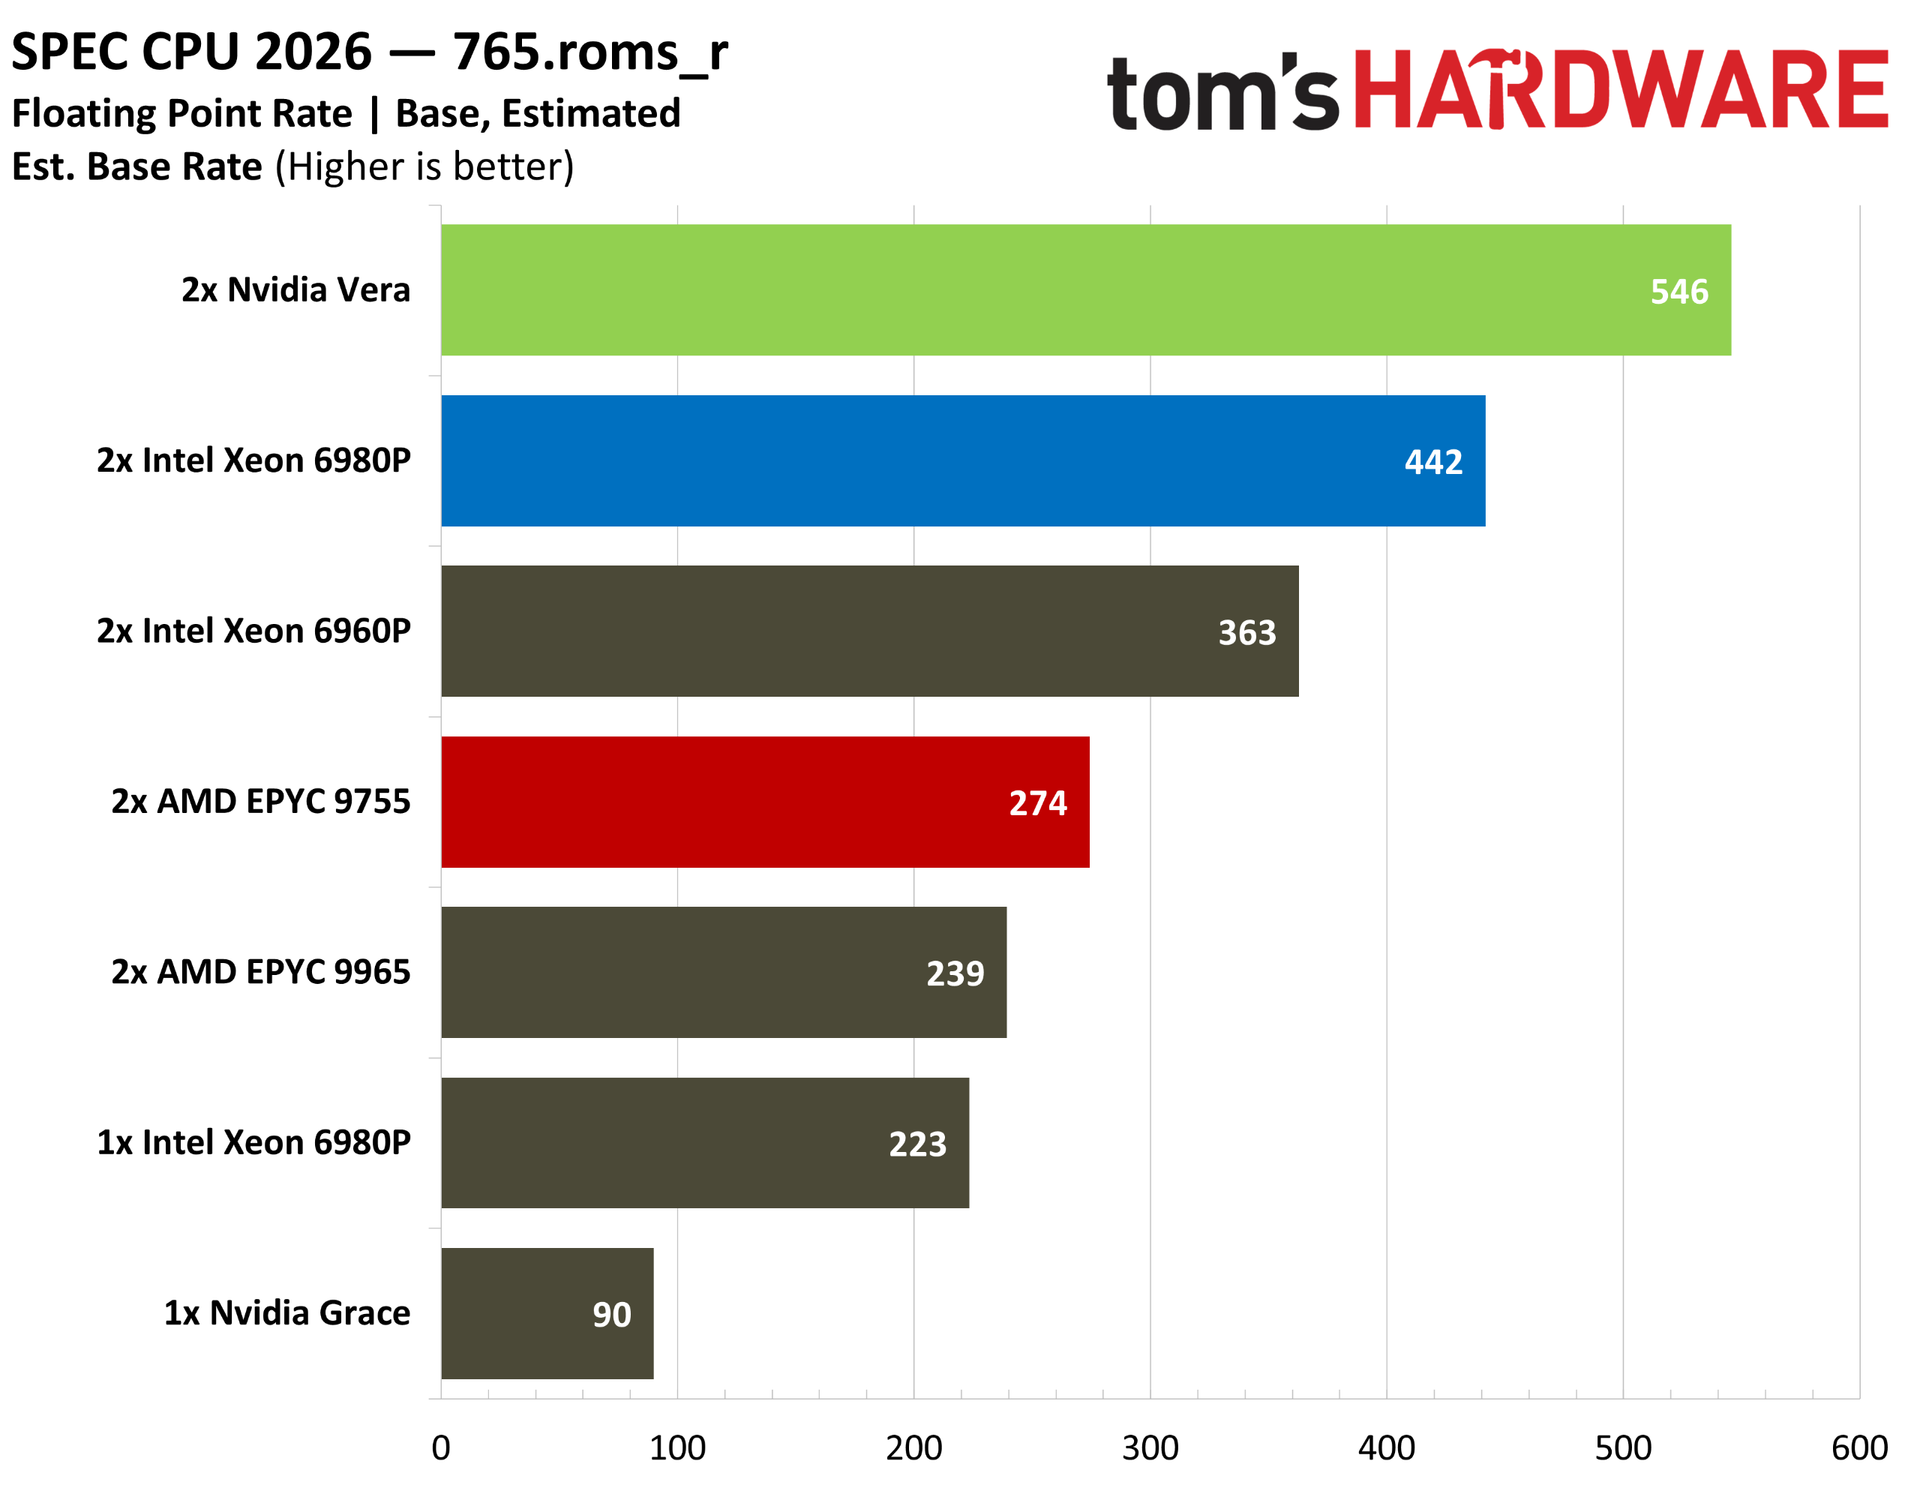
目前 Vera 的主要基准来自 SPEC CPU 2026 内置测试。我们运行了完整的 SPEC CPU 2026 套件以检查 Nvidia 的性能声明并查看浮点性能。需注意,以下结果均为估算,因为 SPEC 报告规则严格,我们未直接向 SPEC 提交这些结果。图表标注为“估计”,但数字并非猜测。我们按照标准测试程序运行 SPEC CPU 2026,每个 CPU 使用相同的编译器和标志。
编译器选用 GCC 15.2,配合链接时间优化(LTO)和 march/mcpu 标志以展示正确的指令支持。所有测试均使用通用的 jemalloc 内存分配器。
从整数吞吐率(intrate)开始,这是一组主要处理整数运算而非浮点运算的应用系列。SOP 在每个可用线程上运行应用程序副本,考察 CPU 同时运行多个应用的能力并测量吞吐量。
Nvidia 的数据与我们测得的数据基本一致。在其白皮书中,Nvidia 显示 Vera 比 EPYC 9755 领先 3%。需要注意的是,9755 系统拥有 512 线程,远高于 Vera 系统的 352 线程。在每核心分数分解中,Vera 并未表现出绝对优势。
尽管 Intel 的双路 Xeon 6980P 拥有 512 线程的高核心密度,但在本次对比中并不占优。重新测试显示,使用 oneAPI 优化的二进制文件带来了令人印象深刻的 10% 性能提升,但即使面对优化代码,Vera 在使用通用 GCC 的情况下仍领先 8.6%。
在上述图表集中,Vera 在某些测试中表现抢眼,而在另一些测试中则落后,这与文章后续部分的测试结果相呼应。可以看出,GCC 编译器性能和 Python 性能是 Vera 的强项,Nvidia 甚至击败了 AMD 顶级的 EPYC 9965。
在其他方面存在弱点。SEAL 加密测试揭示了 Vera 较弱的加密性能,这在我们的其他测试中也得到了反映。Zstd 压缩测试显示 Vera 落后于 AMD 和 Intel,这在情理之中。在单独的 Zstd 测试中,Vera 在压缩方面表现出色,但在解压方面落后。