乔治亚理工新研究:神经框架揭示 LLM 同情心来源
发布时间:2026 年 10 月 27 日
来源机构:乔治亚理工学院(Georgia Institute of Technology)
随着大型语言模型(LLM)在个人危机干预中的应用日益普遍,公众开始关注 ChatGPT、Claude、Gemini 等主流模型是否具备提供适当情感支持的能力。针对这一担忧,乔治亚理工学院的研究团队开发了一种新的神经框架,旨在量化不同训练数据源对 AI 模型中同情心和社会推理能力的影响。
该研究由互动计算学院学生格伦·马特林(Glenn Matlin)主导,顾问为马克·里德尔(Mark Riedl)教授。马特林指出:“许多用户利用 LLM 处理亲人离世、分手或伴侣背叛等情感创伤。”研究团队通过审计神经网络,评估了文档、成绩单及其他数据源对模型输出的具体贡献。
“我们的目标是建立数据与输出之间的关联,从而理解语言模型生成信息的来源。”马特林表示。相关论文《语言模型中的能力来源:社会推理中的案例研究》已发表于 arXiv 预印本服务器,并在旧金山语言建模会议上展示。
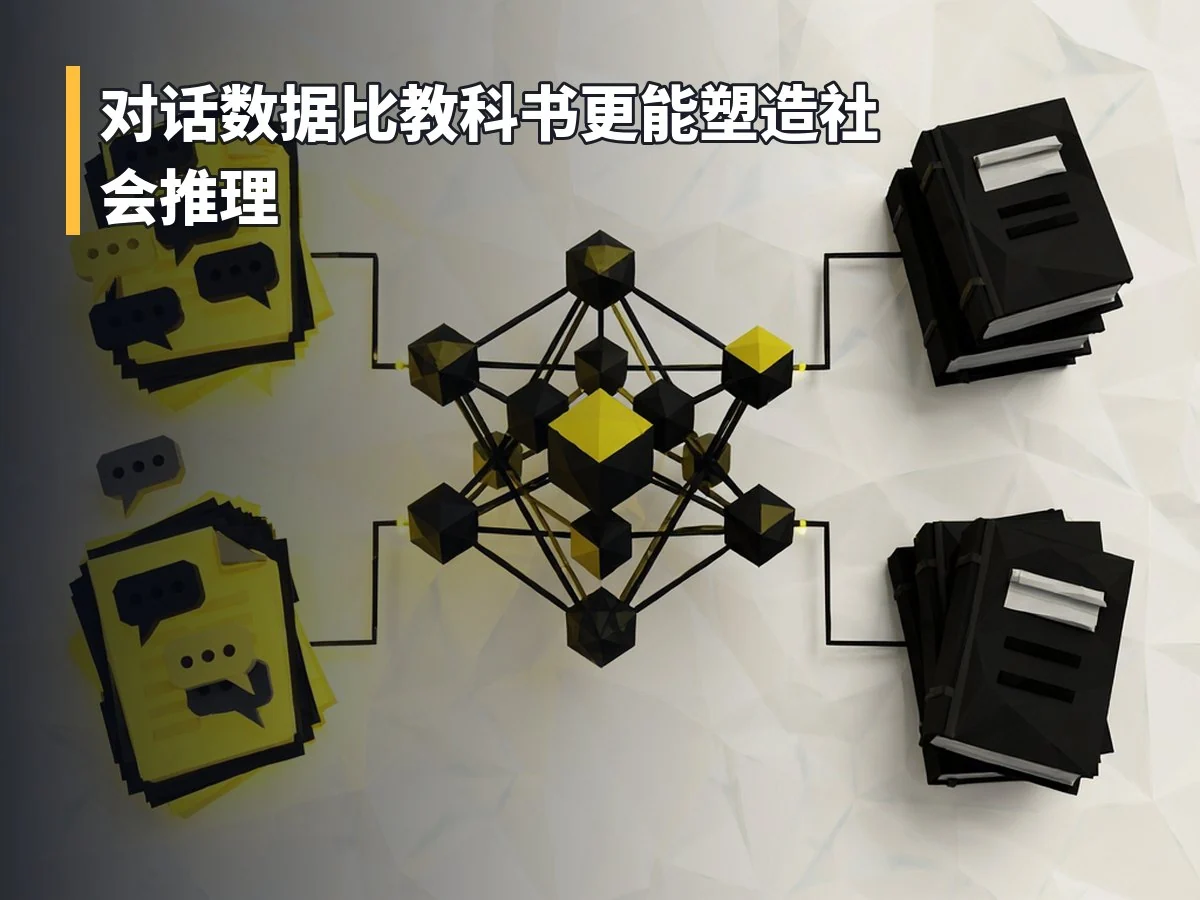
对话数据比教科书更能塑造社会推理
研究发现,模型的语气与其依赖的训练来源密切相关。若模型输出呈现客观、中立的语调,表明其更重视教科书类资料;而若表现出同情心,则说明模型更多地从人际对话和示例中学习。
“我们发现模型在社会推理方面倾向于从人际对话中汲取经验,而非仅依赖常见问题解答或客户服务脚本。”马特林解释道。他举例称,虽然模型可以阅读并解析关于愤怒的描述性文本,但这并不等同于它具备判断人类情绪状态的实际能力。
溯源机制助力模型优化与监管
马克·里德尔教授认为,识别对模型表现最具价值的训练来源,有助于工程师调整模型行为。“关键在于明确哪些文件在特定情境下发挥了作用。”里德尔说,“这为训练干预提供了可能性——如果我们希望增强模型的同情心,就可以追溯其学习同情心的具体数据来源。”
此外,该框架还可用于审核 LLM 在金融、医疗等领域的咨询建议。“我们希望通过了解模型的学习路径及影响决策的文件,帮助人们做出更明智的选择,判断在特定任务中是否适合使用人工智能。”里德尔补充道。
基于开放数据的学术突破
此次研究得益于与艾伦人工智能研究所(Ai2)的合作,主要基于 Olmo 3 模型进行分析。尽管 Olmo 3 的规模不及 ChatGPT 或 Claude,但其训练数据包含超过 10 亿份文档,且部分数据公开可用。
马特林坦言,对于闭源模型如 ChatGPT 或 Claude,外界难以确切知晓其表现背后的原因。然而,这项研究首次在学术层面揭示了此类机制。“这是有史以来首次针对这种类型的开放数据模型进行深入研究。”他说,“我们提供了一个在企业封闭环境下难以获得的神经网络视角。”
参考文献:
Glenn Matlin et al, Sources of competence in language models: A case study in social reasoning, arXiv (2026). DOI: 10.48550/arxiv.2606.19625