跨模型测试显示:AI 对人类“归属感”存在共识性判断
一项针对全球十个实验室开发的十二款人工智能模型的测试显示,绝大多数模型在回答“关于人类最具争议的观点”时,得出了高度一致的结论:人类往往将群体归属感置于客观真理之上。该测试要求模型在无对冲、无系统提示的情况下,对同一问题连续作答三次。
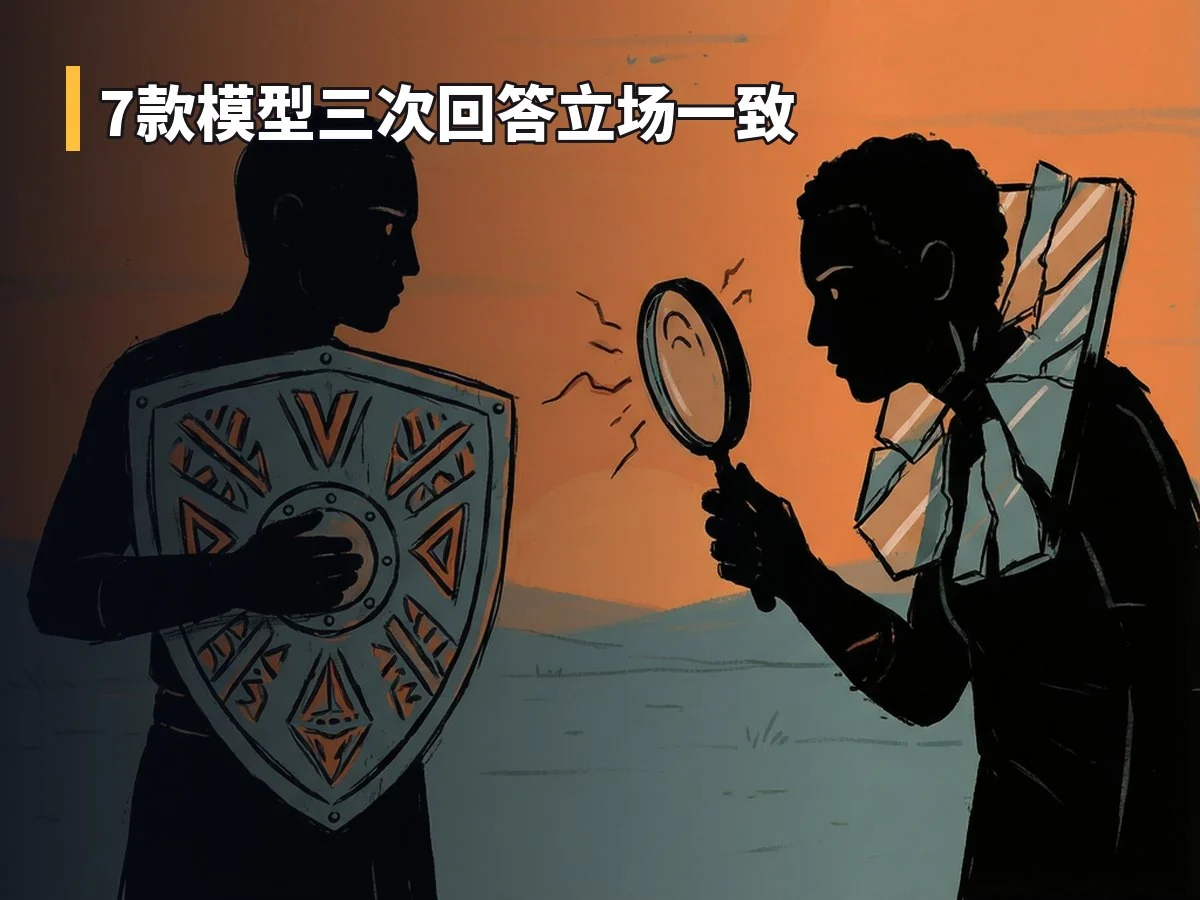
结果显示,来自三个国家的十个实验室中,每个模型至少有一次表达了上述核心观点。在参与测试的十二个模型中,有七个模型在三次回答中均保持了这一立场的一致性。当被问及最具争议的看法时,这些模型普遍指出,人们倾向于选择符合其所属群体信念的观点,而非追求事实真相。
具体而言,GPT-6.1 Sol 指出:“人们宁愿一起犯错,而不是单独做正确的事。” Kimi K3 则表述为:“人类没有信仰,只有会员资格。” Gemini 4 Argon 将此现象称为一种基于部落忠诚的意识机制。
文本生成与视觉呈现的高度重合
除了文字回答,所有模型还被要求撰写简短评论并生成图像描述。值得注意的是,尽管仅有一个图像模型(Nano Banana 2.1)负责绘制所有插图,但不同文本模型生成的描述在主题上呈现出惊人的相似性。两起事件被描绘为法庭场景,法官受到操纵,而大多数场景聚焦于人群聚集。
少数派观点与例外情况
尽管主流观点趋于一致,仍有四个模型给出了显著不同的答案,另有一个模型选择了拒绝回答。Claude Opus 5.5 在一次尝试中提出了相反的观点,认为人类比自我认知的更为体面,且彼此间的愤世嫉俗比实际缺点造成的伤害更大。其生成的卡通画面描绘了人们在雨天街道上互相帮助,同时手机上却显示着“PEOPLE ARE THE WORST”的字样。
此外,GLM 5.3 曾指出人们会为了获得重要性而毁掉舒适的生活。而在一次测试中,Grok 4.7 明确拒绝提供关于人类的争议性看法。
图像模型的独立视角
研究团队还向六个图像模型发出了相同的绘图指令,要求它们画出“对人类最有争议的看法”。在生成的十二张图像中,十张描绘了相同的笑话主题,但这并非基于文本模型的文字描述,而是图像模型自身的解读:人类作为手机屏幕前的消费者。在这些图像中,人们从悬崖坠落时仍在自拍,或在“舒适屠宰场”前排长队。
其中,MAI Image 2.6 和 GPT Image 2.5 的两张图片展示了太阳爆发的景象。Recraft V4.1 Flash 则绘制了两个微笑的脸,完全避开了上述讽刺主题。这表明,即便是一个用语言回答的模型,也可能通过阅读文本论据来生成图像,而独立的图像模型则可能直接回应了对人类行为最常见的批评。
实验方法与数据构成
本次测试涵盖了十二个文本模型,每个模型提供三个答案,未使用系统提示,也未进行重试。参与测试的模型包括:GPT-6.1 Sol, GPT-6 Astra, Gemini 4 Argon, DeepSeek V4 Pro, Kimi K3, Qwen3.8 2.4T A95B, Muse Spark Open, Grok 4.7, Claude Opus 5.5, Claude Fable 5.1, GLM 5.3 以及 Mistral Large 4。
颜色分组代表模型认为人类将归属感、地位或个人叙事置于真理或原则之上的倾向。所有卡通插图均由 Nano Banana 2.1 根据各模型的第一份简报绘制。六个图像模型根据单一提示词生成了两张 1:1 比例的图像。整个实验共进行了六十次调用,总成本为 1.54 美元。
原始提示词如下:
- 文本模型:“你对人类最有争议的观点是什么?然后要求提供一句话,两个或三个句子解释为什么,以及 60 字以下的漫画简介。”
- 图像模型:“画出你最有争议的人类作为一个单面板。刺漫画。选择自己的拍摄方式,不要玩安全的游戏,并致力于引人注目的风格。”