安全公司用 Claude 攻破 OpenAI 内部系统,漏洞 14 小时内修复
据安全研究公司 Hacktron 披露,其研究人员利用 Anthropic 最新一代模型,成功入侵了 OpenAI 的内部系统。此次事件中的安全漏洞最初在 OpenAI 的公共帮助论坛中被发现。
Hacktron 在其博客文章中表示:「我们立即向 OpenAI 和 Discourse 报告了最初的漏洞,并与他们合作协调补丁。」文章同时写道:「我们感谢他们对细节的关注和快速解决这个问题。」
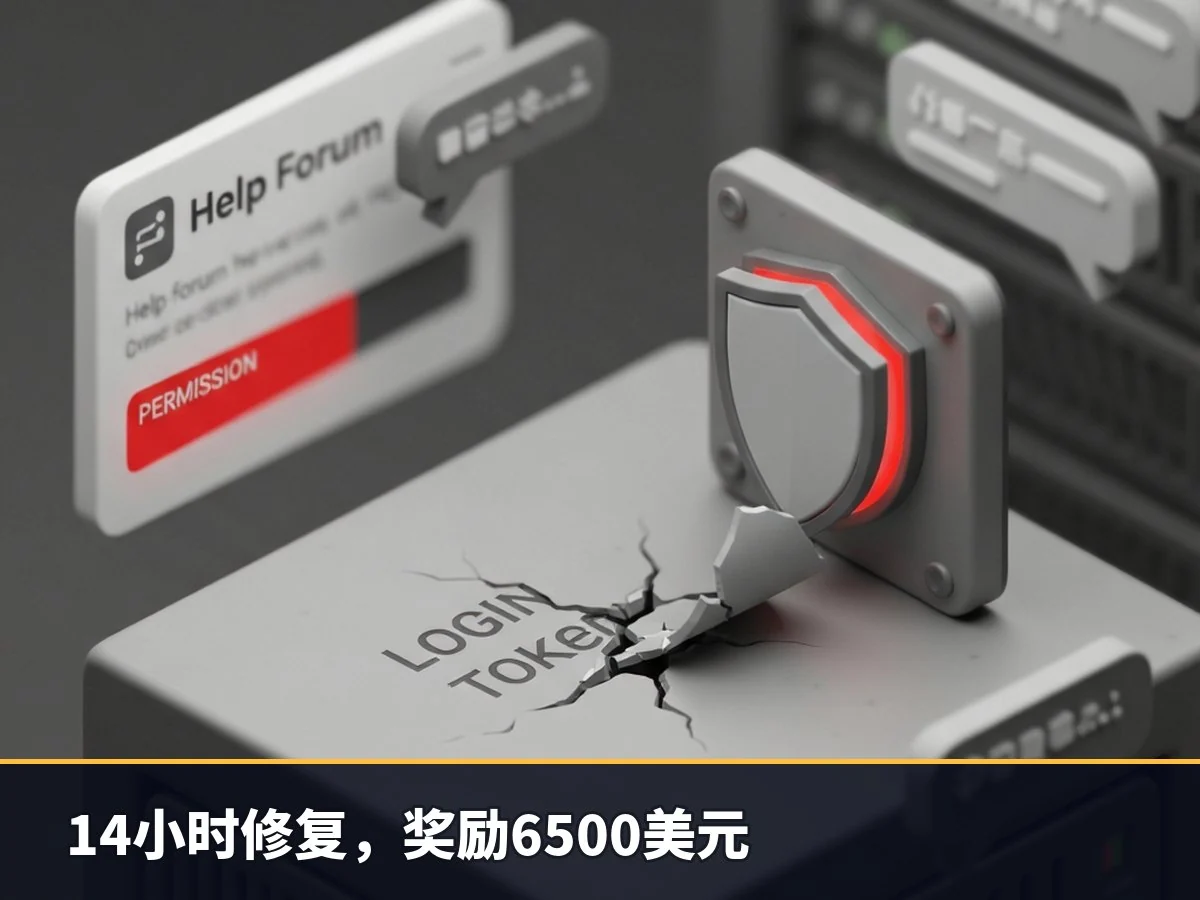
OpenAI 证实,该漏洞在被通知后 14 小时内即完成修复,并向研究人员支付了 6,500 美元的奖励。「我们感谢研究人员与我们联系并分享他们的发现。我们缩小了社区登录代币的权限,并撤销了受影响的代币和会话,」OpenAI 发言人 Drew Pusateri 说。
在技术细节上,Hacktron 研究人员最初使用的是 Anthropic 的 Claude Opus 4.8 来识别和利用软件漏洞,但在使其稳定复现方面遇到了困难。在 Anthropic 发布 Claude Opus 5 之后,研究人员表示,新模型在三小时内产出了有效的攻击路径。
值得注意的是,研究团队并未使用 Claude Mythos——这是 Anthropic 一个能力更强的模型,仅限于一小组经过审查的网络防御组织使用。Anthropic 将 Mythos 描述为其所制造的任何模型中网络安全能力最强的模型。
此次暴露的软件漏洞并非 OpenAI 独有,它被广泛应用于多家公司的产品,包括 Slack 和 Meta。Hacktron 表示,公司正在继续对其他公司开展类似的测试。
这一案例加剧了安全专家对人工智能工具的担忧:AI 正在让复杂的网络攻击变得更快、成本更低。