Meta 本周披露了其“普罗米修斯”(Prometheus)超级计算集群的运维细节。该集群位于俄亥俄州新奥尔巴尼,是 Meta 迄今为止规模最大的计算部署之一,最终容量将扩展至千兆瓦级。
随着算力规模从万卡迈向十万卡乃至百万卡级别,硬件故障已从偶发事件变为常态挑战。Meta 通过保留冗余 GPU、优化分布式检查点架构以及强化 NVLink 互联稳定性等措施,试图在超大规模训练中维持系统的高可用性。
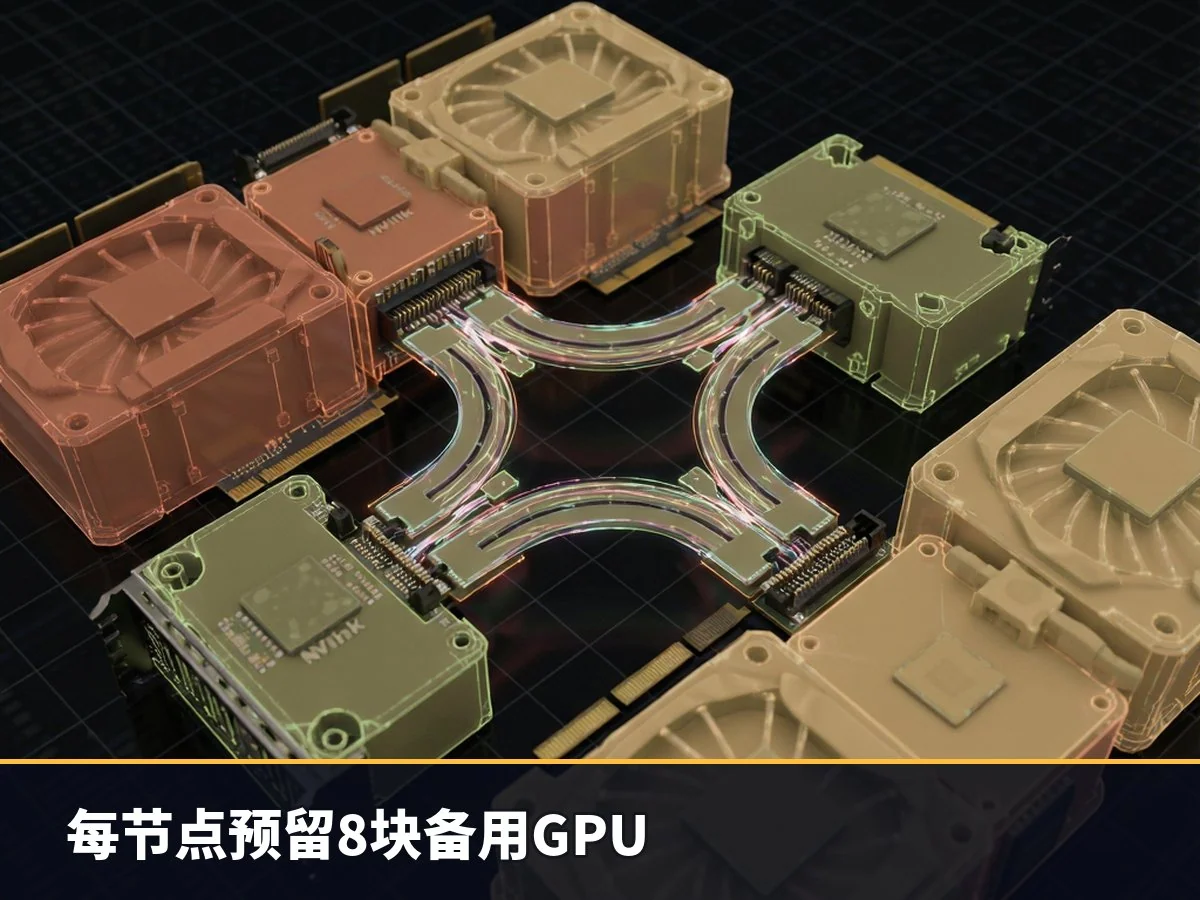
以冗余换取连续性:每节点预留 8 块备用 GPU
据 Meta 介绍,在 Prometheus 部署初期,每 8,000 个 GPU 每天大约经历 1,000 次中断。这里的“中断”并非指硬件彻底报废,而是迫使训练任务停止并回滚至最后一个已知良好的检查点。
经过一年的干预与优化,这一数字已大幅下降 99%,降至每 8,000 块 GPU 每天约 11 次中断。
实现这一目标的关键策略之一是“热备件”机制。目前,Prometheus 集群由 Nvidia Grace Blackwell (GB200) 和 Vera Rubin (GB300) 系统组成,每个 NVLink 域包含 72 个 GPU。然而,在任何特定时刻,仅有 64 个 GPU 处于活跃工作状态,其余 8 个作为备用资源随时待命。
在传统的八卡 GPU 节点中,单卡故障概率相对较低;但在十万卡规模的集群中,故障不可避免。由于单个 GPU 故障可能导致整个机架失效并中断训练,Meta 选择在故障发生时立即启用备用 GPU 进行替换。虽然这仍会导致短暂的中断,但避免了移除整个机架或等待人工更换组件所带来的长时间停机。
并行弹性与分布式检查点
为了进一步减轻故障影响,Meta 利用了大规模训练中常见的数据并行特性。在该模式下,集群中存在多个模型副本。
Meta 解释道:“当一个故障可以被隔离到特定的数据并行模型副本时,我们通过允许该有缺陷的副本离线来减少硬件故障的影响,而剩余的集群则重复该步骤并继续生产性训练。”被破坏的分片会在可用的备用主机上重新启动并重新同步,从而将潜在的总系统停转转化为总吞吐量的轻微暂时下降。
只有当故障超出数据并行域的承受范围时,训练运行才会被完全中断。为此,Meta 实施了一套全面的检查点计划,类似于文档编辑中的自动保存功能,确保系统在出现问题时无需从头开始。
“我们的分布式检查点架构不同步地将模型状态包括梯度和优化器数据存储到多层存储中,”该公司写道。
NVLink 互联的挑战与电力管理
Meta 指出,让连接 72 个 GPU 的 NVLink 织物表现得像一个巨大的加速器是一项艰巨挑战。早期基于 H100 和 H200 的系统每个 NVLink 域仅包含 8 个 GPU,链接更短且数量更少。随着 Nvidia Blackwell 一代的到来,这一规模扩大了 9 倍。
“凭借超过 60 万条 NVLink 连接,即使是微小的信号衰减也会频繁触发 NVLink 恢复周期,”Meta 表示。
为克服这一问题,Meta 实施了连续遥测系统和 L11 诊断烧机测试,以便在系统投入生产前隔离薄弱环节。
电力供应也是另一大难题。数万个 GPU 同时启动或停止训练任务会产生巨大的功耗峰值(瞬态),可能压垮供电设备。
通过专注于集群的稳定性和可靠性,Meta 声称其预训练任务的“好产量”(有用吞吐量)已超过 85%,强化学习任务则超过 90%。
展望未来,在迈向百万 GPU 规模的过程中,Meta 希望将中断率进一步降低至每 8,000 个 GPU 每天仅两次,即平均无故障时间达到约 100,000 GPU 小时。