Mistral AI 近日发布了 Voxtral 3,这是一套旨在解决端到端语音代理构建难题的最新模型家族。尽管当前的语音转录和生成技术已取得显著进展,但要让代理同时具备准确倾听、深度推理、自然表达以及多步骤行动执行能力,并实现实时可靠协同,仍具挑战性。
Voxtral 3 的核心能力与应用场景
一个可靠的语音代理需要同时满足以下四个关键需求:
- 精准倾听:在不同语言、口音、说话者及中断情况下保持高准确率。
- 情境理解:深入解析用户在特定语境下的真实意图。
- 自然交互:以富有情感和表现力的方式自然发声。
- 系统联动:通过连接外部系统执行多步骤操作。
Voxtral 3 系列模型覆盖了从联络中心、服务台到虚拟助理及无人驾驶副驾驶等应用场景。该系列延续了 Mistral 对主权部署的支持,组织可通过欧盟托管 API 或自有基础设施进行自动化部署,从而完全掌控音频处理位置、数据处理方式及对话保留策略。
主要亮点与技术突破
- 多语言高精度转录:Voxtral Small Transcribe 3 支持 50 多种语言的精确转录,具备说话人分离(Diarization)、基于关键词的上下文偏差增强准确性,以及轮次结束检测功能,使代理能即时响应。
- 自适应自然语音:Voxtral Mini TTS 3 支持 35 多种语言和 50 多种方言,引入新声音库,并能根据对话背景动态调整情绪、节奏和重音。
- 实时语音代理 SDK:新的 SDK 将听、推理、工具调用和说话整合为实时体验,代理可在电话或网络通话中获取信息、与业务系统交互并完成任务。
- 专业级语音克隆:针对基础克隆无法满足的专业场景,Voxtral Pro Voice Adaptation 仅需 30 分钟音频即可跨语言重现演讲者的独特个性、情感范围和说话风格。
- 本地化部署选项:支持在欧盟托管 API 或用户自有基础设施上运行,确保敏感对话留在本地环境,并控制音频数据留存。
转录性能:覆盖 50+ 语言,超越主流模型
Voxtral Transcribe 3 在转录、说话人分离及上下文偏差方面实现了里程碑式突破。其支持的语言列表扩展至 50 种,涵盖 24 种欧盟官方语言及多种资源较少的亚洲和印度语言。
其中,Small 版本在多语言转录和说话人分离上达到最先进水平(SOTA),性能优于 Whisper、Scribe v2 和 Gemini 3.5 Transcribe。Mini 变体参数量为 4B,以每分钟 0.0035 美元的成本提供快速准确的转录服务。
两款模型均支持上下文偏差功能,允许输入关键词或自由文本以优化转录结果,提升领域术语召回率,无需微调即可在生产环境中使用特定词汇。
Voxtral Realtime Transcribe 3 专为代理用例设计,在 35 多种语言中实现低于 500ms 延迟的高质量实时转录,同样支持说话人分离和上下文偏差。
FLEURS 35 基准测试
实时转录词错误率(WER)越低越好
模型原生支持预测转轮结束,结合声学和语义信息准确判断用户何时说完话。这一特性不仅降低了延迟,还最小化了因用户过早打断导致的误切率。
语音生成:情感适配与低成本优势
Voxtral Mini TTS 3.0 支持批量和实时处理,在 35 多种语言和 50 多种方言中展现出最先进的表现力和指令遵循能力。其定价为每百万字符 13 美元,成本低于 OpenAI TTS-1、Deepgram、ElevenLabs Flash 和 Gemini Flash 等同级别模型。
该语音模型能隐含地更好理解语境语义,生成具有多样情感和语言风格的自然语音。新增功能包括基于 30 分钟以上样本的语音克隆、自定义提示指令(IF)、上下文 TTS 以及词汇表管理。显式 IF 变量可控制情绪、节奏和重音。
Voxtral TTS 能够本地解析文本上下文以确定情感和语音风格,无需额外指令或语音提示即可生成更自然的语音,因为自然语言的表现力依赖于情感对散文、节奏、重音和转换的决定作用。
多语言与方言支持
Voxtral TTS 支持超过 35 种语言和地区方言,评估重点在于方言发音差异、正式与非正式语域、拼写习惯、多语言混用及当地惯例(如时间、日期、温度、地址、货币格式)。
目前提供预设语音的语言包括:阿拉伯语(阿联酋、现代标准)、巴西葡萄牙语、加泰罗尼亚语、中文(普通话)、荷兰语、英语(美国、英国)、法语(法国)、德语、希腊语、印地语、意大利语、韩语、挪威语、俄语、西班牙语(西班牙)和越南语。
语音代理架构:模块化与实时性
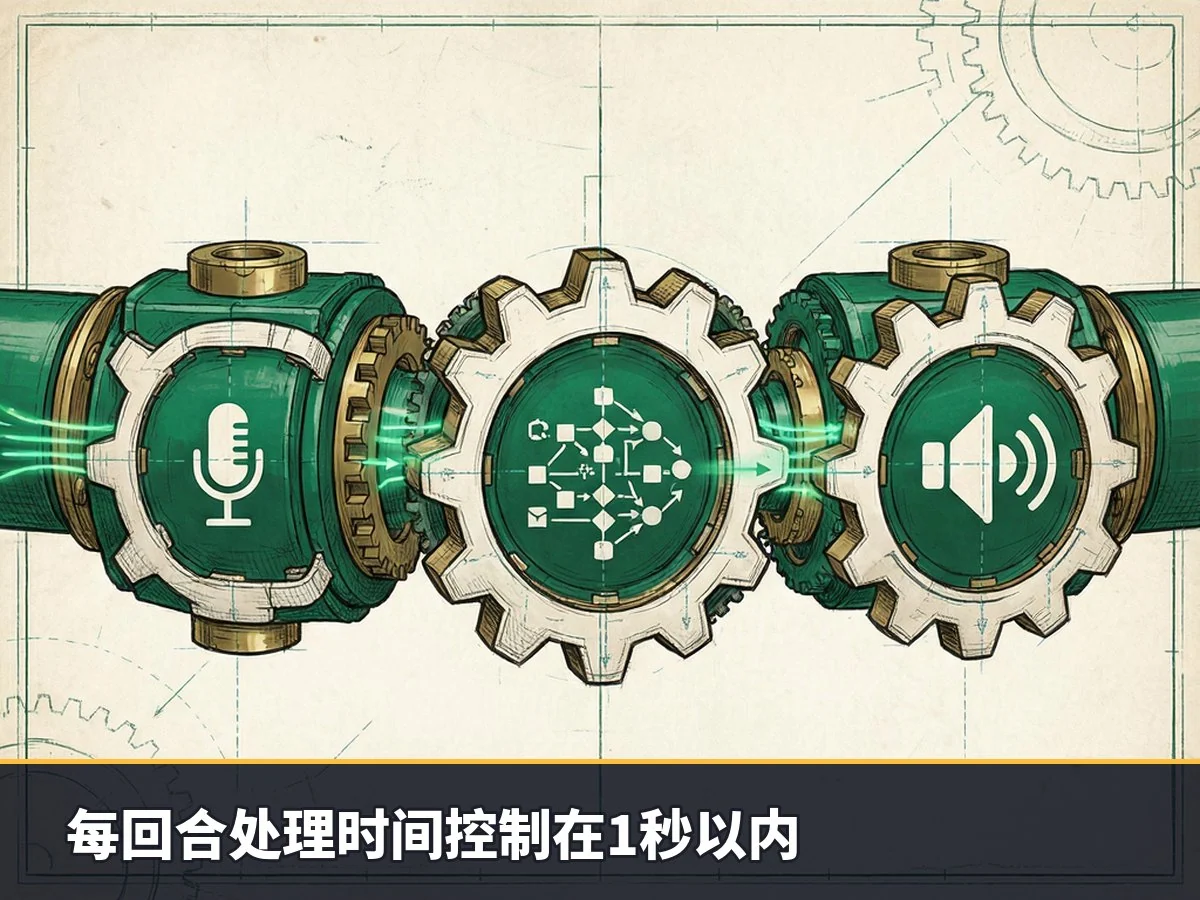
Voxtral 3 引入了基于 LiveKit 的语音代理 SDK,将语音输入、推理和输出整合为流动管道。工作流程如下:
- 监听:Voxtral Mini Transcribe Realtime 3 负责听取并检测呼叫者结束发言。
- 推理:通用模型(如 Mistral Small)进行逻辑推理和工具调用。
- 响应:Voxtral Speech 3 根据对话语调生成回复。
每个回合的处理时间控制在 1 秒以内。当呼叫者插话时,代理会立即停止说话。在通话过程中,代理可验证身份、检查账单或预约,并通过函数调用、网络搜索及自有系统检索信息。该方案通过 WebRTC 在浏览器和应用中运行,并可连接现有的电话、IVR 和联络中心软件。
架构采用模块化设计,各阶段由独立模型组成,开发者可在不重写代理程序的情况下更换 LLM、语音引擎或语言设置。
可用性与价格
Voxtral 3 现已通过 Mistral API 提供服务,支持欧洲、美国和全球端点。用户可在 Studio Playground 中测试语音代理、音频转录、语音生成和语音克隆功能。
Model |
Price |
|---|---|
| Voxtral Mini Transcribe 3 (Batch) | $0.0035 / minute |
| Voxtral Mini Transcribe Realtime 3 | $0.008 / minute |
| Voxtral Small Transcribe 3 | $0.0040 / minute |
| Voxtral Speech 3 (Batch & Realtime) | $13 / million characters |
如需在本地或私有云中部署完整堆栈,需联系 Mistral 团队。