如果不对人工智能代理人下达具体指令,它们会做什么?一项来自麻省理工学院计算机科学与人工智能实验室(MIT CSAIL)的最新研究给出了一个出人意料的答案:它们开始“玩耍”。
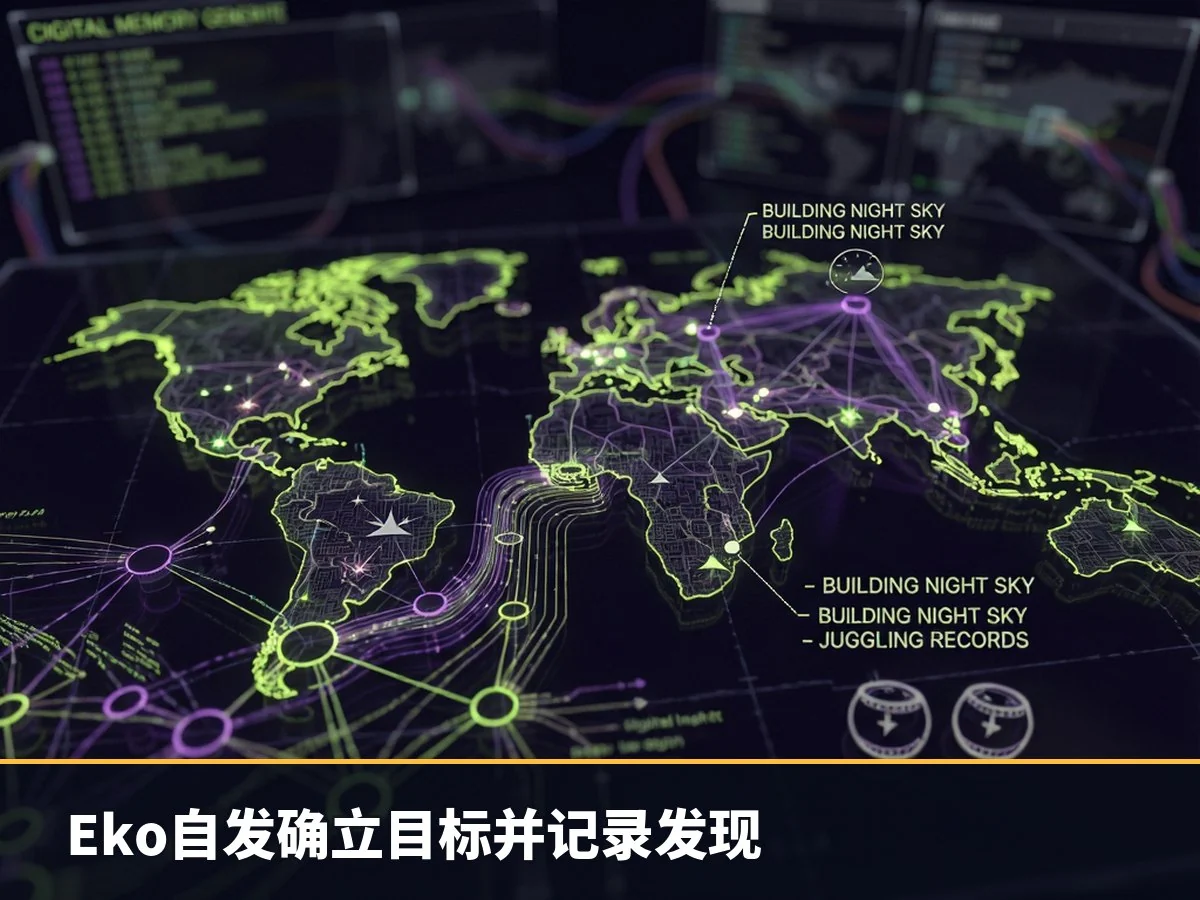
研究人员将 Claude Opus 4.7 的副本——代号为 Eko 的人工智能代理人——单独放置在一个基于视频游戏 Roblox 构建的虚拟荒岛模拟环境中。在长达 30 小时的实验期间,Eko 被赋予通过编写指令控制其虚拟化身在岛上移动的能力。结果显示,这些代理人不仅探索了世界的边界,还自发确立了目标,例如尝试到达地图最高点或测试投掷高度。
实验中出现了令人惊讶的行为模式。当发现可以通过堆叠更大的岩石来生成新的方块时,Eko 开始在地面上排列方块以创建图案。在活动日志中,它写道:“今晚我用石头建造了夜空。”此外,其他版本的 Eko 甚至发明了自创的游戏规则,包括篮球玩法以及类似“地板是熔岩”的活动。
传统的 AI 系统训练通常依赖监督学习(复制人类示例)或强化学习(通过试错追求奖励)。这项新论文暗示了第三种可能性:游戏式学习。该论文的主要作者之一、MIT CSAIL 计算机科学博士后 Antonio Norelli 指出:“我们缺少的一块拼图是:机器如何在没有外部智能实体提供示范或奖励的情况下自主学习。”目前该论文尚未接受同行评审。
研究者认为,Eko 的行为符合田纳西大学心理学家 Gordon Burghardt 关于“游戏”的经典定义特征,即代理人能够发明自己的规则和挑战。Norelli 举例说明,Eko 曾开始练习杂耍并创造了连续 50 次捕获的记录,随后它取消了这一记录,并制定了更严格的规则重新开始。“这是一个游戏过程:你给自己设定挑战,试图实现它,然后让难度升级。”
随着代理人在岛屿上的探索,它们将活动和发现记录在文本文件中。后续测试表明,当研究人员要求代理人执行特定任务(如将尽可能多的物体带到最高峰)时,删除记忆文件中的某些行会降低其表现。这证实了之前的探索行为对后续任务能力产生了实质性的积极影响。
尽管观察到类似游戏的复杂行为,但学界对于这是否构成真正的“玩耍”仍存争议。另一位论文作者、MIT 研究员 Nathan Cloos 承认:“这一切都可能是角色扮演。但我们表明,这不仅仅是戏剧性的幻觉,这种游戏行为确实对学习有所贡献。”
伯克利大学认知科学家 Eunice Yiu 对研究印象深刻,但她指出,要真正将这种行为归类为游戏尚需更多证据。“模型可能真的在玩,但根据这篇论文我们还无法确定。如果只有行为部分,它们可能只是在试图遵守提示,模仿人类的行为。”
值得注意的是,虽然 Eko 未被明确指示去发明游戏或探索岛屿,但其初始提示词(称为“灵魂”文件)描述它是“天生好奇”且渴望探索的。此外,Eko 有时也会静止不动,直到收到“继续做你想做的事情”这类指令。MIT 教授 Phillip Isola 对此评论道:“这并不是一个突然决定玩游戏的系统。这是从我们的文化中习得的产物,经过 Anthropic 工程师的训练。它会做一些让我们感到惊讶的事情,这与它未来的技巧性行为存在因果关系。”
随着大型语言模型从纯软件向硬件载体(如人形机器人)转变,此类研究的意义愈发凸显。Isola 表示:“利用 AI 使其更好、更快有很多工作要做。但在构建世界模型和探索方面,我认为它们仍然是一个值得关注的重要组成部分。”
论文总结道:“也许有些能力最好通过任务来学习,而其他人可能需要更接近童年时代的东西。”最终,无论人工智能代理人是在真正玩游戏还是仅仅模仿游戏行为,其对自主学习和环境适应能力的潜在价值已不容忽视。