核心观点:神经网络机制具备可读性
近期关于神经网络机械可解释性的研究带来了新的视角。经过对图像和语言模型中神经元及电路的数月研究,结论显示网络的自身机制由可读的构建块组成,其机械解释的前景优于预期。此前学界普遍担忧的“概念纠缠”被重新定义为“递归概括”,这一现象并不构成理解障碍。这意味着研究者可以直接分析网络结构,而无需先解开所谓的复杂纠葛。
目前处理机械解释性主要有两种路径:一是基于网络本身的常规科学方法,即观察神经元与电路的关联、数据流动,并在代理规模上运行实验以验证解释;二是从假设的特征列表出发,通过设计重建目标提取特征,这种方法往往忽略原始数据流。由于早期认为神经网络存在严重纠缠,领域内曾倾向于第二种方法,但最新进展表明第一种方法更为有效且可行。
多语义性与叠加假说的修正
长期以来,“多语义神经元”被视为机械解释的主要障碍,典型例子包括 InceptionV1 模型中对猫脸和汽车前脸同时反应的神经元。主流观点将其归因于“叠加”原理,即当神经元资源耗尽时,网络会将无关概念折叠在一起,导致单个神经元难以解读,必须借助稀疏自动编码器等工具进行解耦。
然而,最新研究指出这种解释存在误判。InceptionV1 后期层的混乱主要源于架构缺陷导致的溢出效应,而非本质的不可解释性。随着深度学习结构的优化(未改变模型大小或训练数据),该模型最后一层 99-100% 的神经元变得易于解释。这表明,在空间充足的情况下,神经元会分化为特定概念(如多种汽车类型),而非将不相关事物强行折叠。因此,问题并非源于第二个学习原理的存在,而是第一个学习原理(泛化)在受限条件下的表现。
此外,2019年 Chris Olah 等人提出的经典“叠加电路”案例——汽车特征扩散至狗神经元——也被重新评估。当时推测这是信息在高维隐藏位置的存储,供下游读取。但实际上,没有任何神经元读取这种组合,这仅是普通的泛化和组合过程。截至目前,尚未发现具有相同形态的其他电路案例。
现代语言模型的可解释性提升
相较于早期模型,现代大型语言模型展现出更高的可解释性。Anthropic 2023年的《Towards Monosemanticity》研究显示,在小规模单层模型中,约 14% 的中位神经元无法形成明确假设。OpenAI 同年的一项研究则发现,仅约 1.7% 的神经元可通过最宽松的测量标准进行解释。
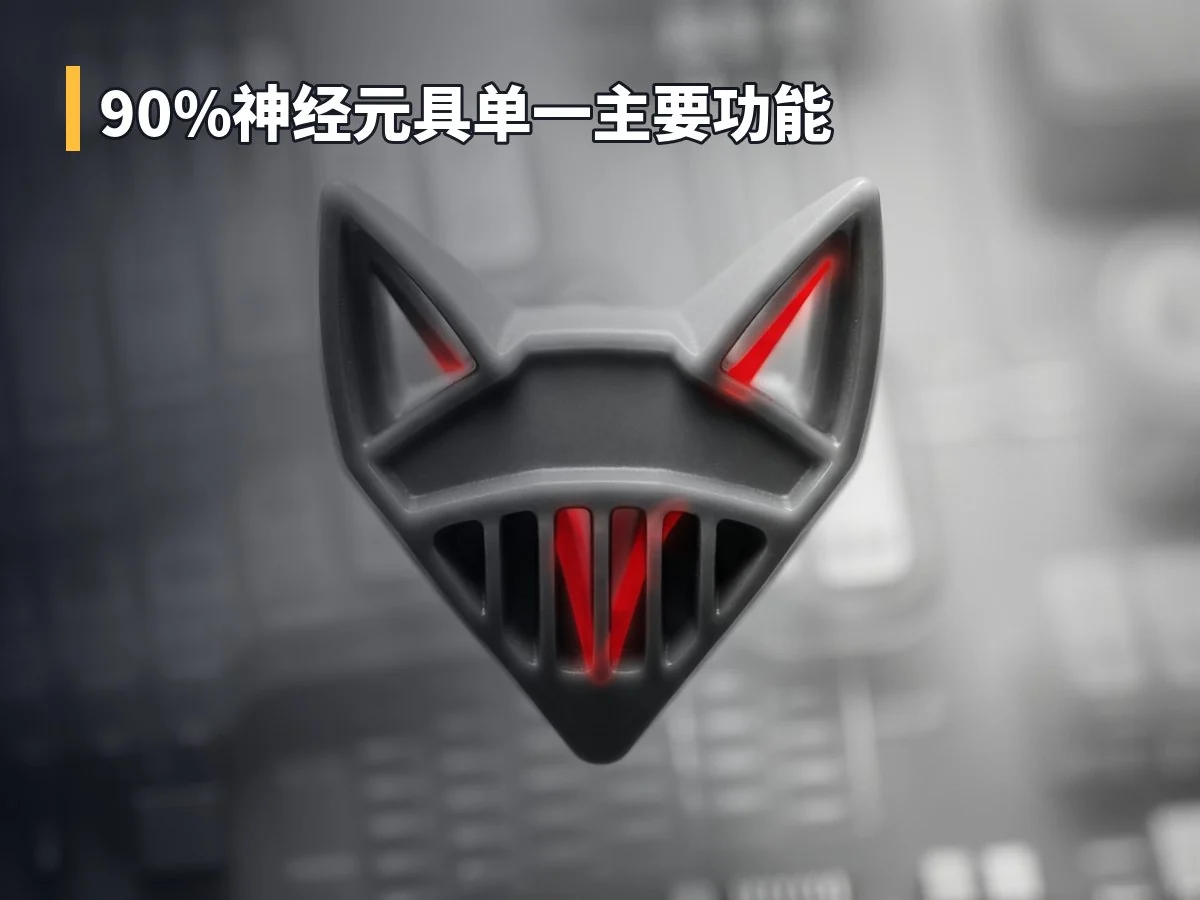
利用更先进的工具和现代模型(如 Qwen3-32B),初步审计估计约 90% 的神经元具有单一主要功能,另有约 7% 具有两个相关功能。需要注意的是,这一比例受激活阈值、网络深度及子电路密度等因素影响。例如,“特朗普神经元”的弱激活可能关联 MAGA 帽子及相关人物,“泰坦尼克号神经元”的弱激活可能关联一般航海或蒸汽机技术。总体而言,若关注强激活状态,非任意混合物的比例接近 97%。尽管精确数字依赖于定义标准,但整体趋势表明神经网络远比想象中“干净”。
剩余的多义性现象大多符合“递归泛化”模式:神经元像树枝生长一样衍生新分支。例如,一个检测 “iy” 的神经元逐渐演变为检测 “diy”,进而识别 “do it yourself”。这一概念早在 2021 年的《Multimodal Neurons in Artificial Neural Networks》论文中被提及,如今通过追踪训练过程中的神经元生长得到了验证。即使是原始的 InceptionV1,其最难解读的神经元也只是在局部过度生长至相邻特征领域,而非杂乱无章。
方法论的转变:从解耦到直接观察
过去两年间,解释性研究的困难部分源于工具和方法的局限。2023年的解释器模型缺乏有效的猜测-测试循环,指标薄弱,且研究人员常使用小型或简化模型,这些模型因空间不足而表现出类似叠加的行为。一旦掌握正确的搜索方向,宽泛的神经元通常容易被拆解。
机械解释性具有类似拼图游戏的累积效应:初始阶段,孤立神经元的解释依赖未知的上下游连接,难度较大;但随着地图填充,每个解释都受到周围已理解部分的严格约束。例如,若已知某神经元检测微妙的社会背景信号,通过检查其上游构建方式、下游输出效果以及负向激活情况,可以迅速确认其功能。这种相互印证使得大规模网络的理解效率随进度呈指数级提升。
虽然现代神经网络体量巨大,但规模本身有助于解释工作。首先,深入理解网络机制是提出正确问题的前提;其次,针对局部机制的研究需依托全局上下文以避免偏差。目前,该方法在卷积网络和数万亿参数的语言模型中均显示出有效性。快速正常的科学探索从未失败,研究者已基本掌握这些模型的运作逻辑。
案例分析:从“猫车神经元”到 V 形特征
InceptionV1 中著名的多义神经元 4e:55 常被引用为神经元不适合作为研究单元的证据,因其似乎对猫和汽车做出反应。早期文献如《Zoom In》和《Multimodal Neurons》曾认为这是真正的 OR(cat, car) 逻辑,尽管后者曾怀疑是否存在共享形状(如猫眼与车灯相似),但最终因胡须等细节否定此假设。
重新审视后发现,该神经元实际上是一个“V 形”检测器。猫的尖耳/面部轮廓与汽车的格栅/挡风玻璃线条共享 V 形几何特征。胡须的出现是因为特征可视化任务旨在最大化激活值,从而捕获了猫通路中的附带元素,而非神经元主动选择胡须。下游的汽车识别神经元虽接收来自 V 形神经元的微弱猫信号,但由于多个检测器协同工作,单个误触发对最终输出影响极小。
- dog
- fox
- cat
- car
- 游泳池桌
- 高速列车
- dog
- dog
- snail
- 高尔夫球
- 网球球
- clock
同样,2019年发现的所谓“汽车存入狗神经元”的叠加电路,实则是汽车与狗共享某种姿势特征。后续层级继续构建这些特征,直至网络末端。汽车并未隐藏在模糊的高维空间中,而是与狗共同构成了特定的姿态表达。DINOv2 等大型视觉模型中也观察到类似现象,尽管拥有更多专用神经元,但泛化性依然存在。