OpenAI 产品负责人菲吉·西莫(Fidji Simo)在 2026 年的一段访谈中描述了这样一个场景:研究团队的 Jakub 和 Mark 为长期研究方向做出了决定。经过数月工作,一个令人难以置信的东西出现了,一位研究人员打电话给她说:"我有很酷的东西。如何在聊天中使用它?如何将其用于企业产品?"
这段描述与 1997 年史蒂夫·乔布斯的著名论断形成了鲜明对照:"您必须从客户体验开始,然后向后工作到技术。你不能从技术开始,然后试图找出你将要去哪里销售它。"
在 OpenAI 当前的处境中,这引出了四个根本性的战略问题。
第一个问题:竞争优势不清晰
今天看到的 OpenAI 业务,没有强大且明确的竞争优势,也没有独特的技术或产品。这些模型拥有非常庞大的用户群,但参与度和粘性却非常狭窄。到目前为止,没有网络效应或其他"赢家通吃"效应,能够为将用户群转化为更广泛、更持久的东西提供明确的路径。OpenAI 的消费产品中,也没有一款是在大模型本身的产品市场契合之上建立起差异化优势的。
第二个问题:价值捕获方式将发生剧变
随着市场发展,AI 的体验、产品、价值捕获和战略杠杆将在未来几年发生巨大变化。全球企业家正试图创造新的功能、体验和商业模式,OpenAI 必须发明一套全新的东西,或者至少抵制、合作并吸收成千上万其他人正在做的工作。
第三个问题:跨越鸿沟
OpenAI 与 Anthropic 一样,都必须"跨越鸿沟",穿越"混乱的中间阶段"。一家拥有这一切的公司需要能够自我颠覆,但时代早已变了——我们已经远远超出"Google 做不了 AI"的阶段,Google、Microsoft、Apple 和 Meta 这些巨头随时可能凭借产品与分销优势追上来。
第四个问题:产品团队无法掌控路线图
迈克·克里格(Mike Krieger)和凯文·韦尔(Kevin Weil)去年也提出过类似观点:在 AI 实验室担任产品负责人时,你无法控制自己的路线图,对产品策略的制定能力非常有限。早上打开邮箱,发现实验室已经做出了某个东西,你的工作就是把它变成一个产品。策略发生在别处。但在哪里?
OpenAI 仍然可以说是新模型发展的风向标之一,拥有大量优秀技术和聪明且雄心勃勃的人。但与 2000 年代的 Google 或 2010 年代的 Apple 不同。从其过去 12 个月的动作来看,萨姆·奥尔特曼对此心知肚明。
模型竞争:六强混战,无人拉开身位
目前有大约六个组织正在推出具有竞争力的前沿模型,每隔几周就会互相超越。各家能力存在差异:Meta 目前可能落在曲线之外,Apple、Amazon、Microsoft 目前尚未进入曲线,中国落后约六个月且严重依赖别人的工作。所有这一切都需要大量资金投入。
模型本身目前不存在自我强化的市场份额效应——这与 Windows、Google 搜索、iOS、Instagram 的历史截然不同。这种情况可能因突破而改变,例如持续学习带来的网络效应,但这无法预先规划。访问专有数据方面如果存在真实的规模效应,也可能改变格局——这可能是用户数据(但规模形态尚不清楚,而现有平台公司拥有海量用户数据),也可能是垂直数据(基础模型并不知道 SAP 或 Salesforce 内部发生了什么)。也许还存在其他因素,但目前无法知晓,也无法预测,因此必须假定模型在可预见的未来仍然高度趋同。
用户规模领先,但参与深度很浅
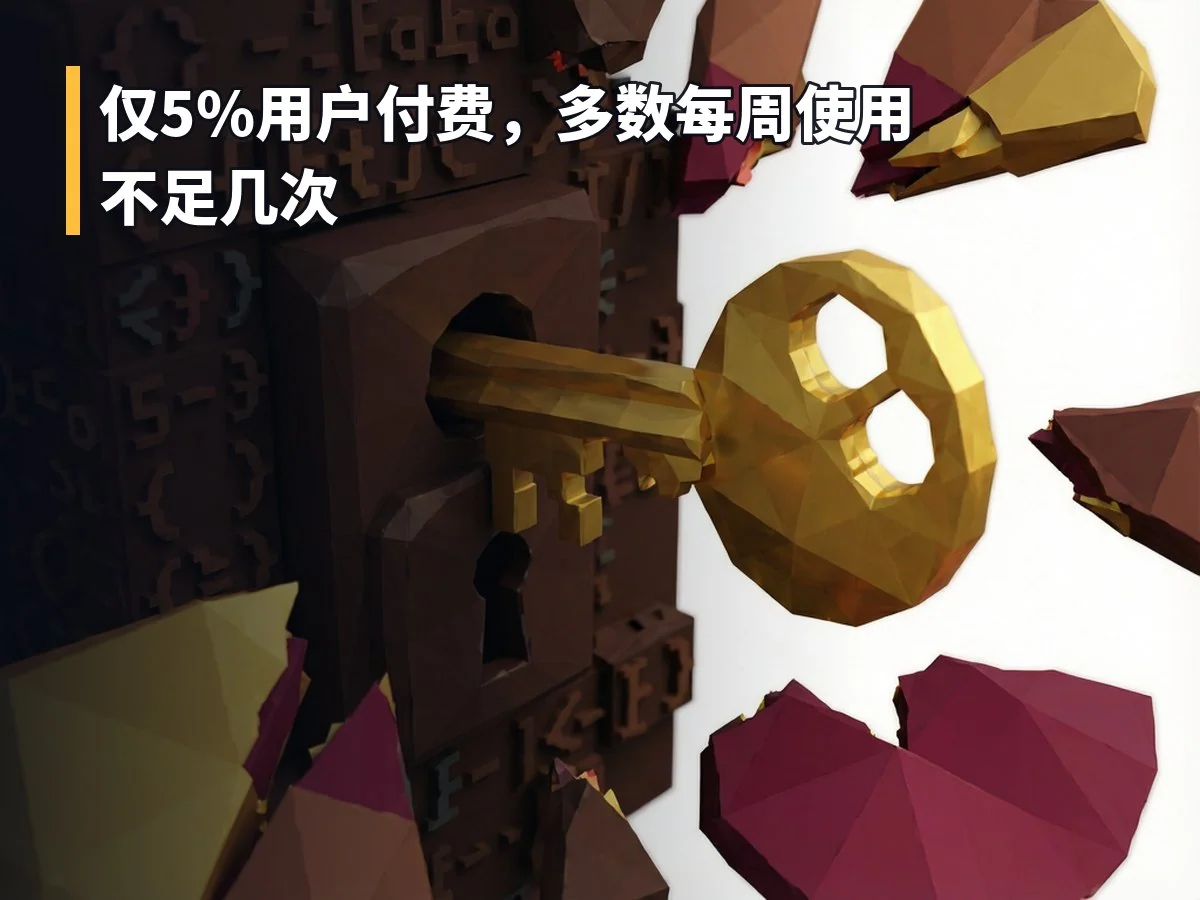
OpenAI 在用户规模上确实拥有明显领先:其周活跃用户数为 8 至 9 亿。问题在于,这些只是"周活跃"用户——即便在那些已经知道这是什么、也知道如何使用的人当中,绝大多数人也没有把它变成日常习惯。只有 5% 的 ChatGPT 用户在付费;在美国青少年中,每周使用几次或更少的可能性,远高于每天使用多次。OpenAI 在其"2025 Wrapped"推广活动中披露的数据显示,80% 的用户在 2025 年发送的"消息"不足 1000 条。该数字在年内如何变化尚不清楚(可能有所增长),但表面上看,这相当于平均每天不足 3 个提示词,且独立聊天次数要少得多。使用面很广,深度却很浅。
这意味着大多数人感知不到各模型之间在个性和侧重点上的差异,大多数人也没有从"记忆"或其他功能中受益。各公司的产品团队互相复制,希望建立粘性——但记忆属于粘性,而不是网络效应。如果 80% 的用户每周最多只使用几次,这种优势究竟有多大?
更根本的是,AI 本应是人们使用电脑方式的转变。如果人们每周最多只能想起使用它几次,说明他们平均每天都没有想到要用它做什么。OpenAI 自己也承认这一问题,谈到了模型能力与人们实际使用方式之间的"能力差距"(capability gap)。
广告、Copilot 与空白屏幕问题
OpenAI 的广告项目,部分原因只是为了支付服务 90% 以上不付费用户的成本,同时与广告商建立早期领先地位、尽早了解广告的运作方式。但更具战略意义的是,它让 OpenAI 能够为这些用户提供最新、最强的模型——即希望以此加深参与度。这可能会奏效,也可能反而促使这些用户付费,或促使他们转向 Gemini。对于那些今天或本周想不出与 ChatGPT 有什么关联的人,给他们更好的模型能否解决问题,目前尚无定论。同样可能的结果是:他们仍然面临"空白屏幕问题",或者聊天机器人本身就是一种不合适的产品和体验形态。
Netscape 之忧:无差异化产品的领先者难以持久
当产品缺乏差异化时,早期领先者往往难以持久,竞争会转向品牌与分销。从 Gemini 和 Meta AI 快速增长的市场份额中可以看到这一点:对普通用户而言这些产品看起来差不多——尽管科技界将 Llama 4 视为失败,但 Meta 的数字似乎很好——而 Google 和 Meta 的分销能力极强。Anthropic 则没有消费者策略或产品(Claude Cowork 要求用户安装 Git),消费者认知度几乎为零。
因此很多人将 ChatGPT 与 Netscape 相比:当年 Microsoft 利用分销优势,在一个难以区分产品的市场中挤了进来。有趣的是,当年区分网页浏览器的困难与今天区分聊天机器人的困难如出一辙。你可以改进浏览器的渲染引擎,也可以改进聊天机器人的 LLM。像所有聊天机器人应用一样,ChatGPT 应用只是一个薄薄的包装——如何让自己的应用与众不同?浏览器的历史答案是:你做不到。浏览器时代最近成功的产品创新只有标签页,以及将搜索与地址栏合并。今天的聊天机器人面临同样的问题:还能往里面塞多少个小按钮?
最终,Microsoft 赢得了第一代消费者互联网的浏览器战争。同样,关于"参与差距"的真正问题在于:它将通过普遍性的模型改进来解决——而模型改进必然适用于整个行业;还是通过 UI 创新来解决——而这会被所有人复制;抑或是通过在"原始"模型之上构建新的实验和用例来解决。
如果下一步是那些全新体验,谁会创造它们?为什么会是 OpenAI?整个科技行业都在试图发明 AI 原生体验的第二步——OpenAI 如何规划才能独占这一进程?如何与硅谷的每一位企业家竞争?
OpenAI 的应对:广撒网与"平台"叙事
概括一下 OpenAI 的处境:无法让核心技术明显优于对手;用户规模很大但参与度有限,看似脆弱;巨头正在利用产品和分销优势追赶;大量价值和杠杆将来自尚未被发明的新体验,而 OpenAI 无法独自发明所有这些。那么它该做什么?
去年大部分时间,OpenAI 的答案似乎是"一切,一起,马上":应用平台、又一个应用平台、浏览器、社交视频应用、乔尼·艾夫(Jony Ive)、医学研究、广告,以及数万亿美元的资本支出公告——或至少是资本支出愿望。这既可能是战略焦虑的体现,也可能只是雇佣了大量激进、雄心勃勃之人的自然结果。有时还能感觉到一种模仿:人们复制以往成功平台的形式,却不完全理解其目的与动态——平台有应用商店,所以我们也需要一个应用商店。
但去年晚些时候,萨姆·奥尔特曼试图把这些整合在一起,展示了一张战略图表,并引用了比尔·盖茨的著名说法。
几乎在同一时间,首席财务官发布了另一张图表。
这是一个整洁、连贯的战略叙事:资本支出本身构成良性循环,是打造完整平台公司的基础。你构建技术栈的每一层——从芯片和基础设施开始,越往上层走,就越能帮助别人用你的工具创造自己的东西。所有人都可以使用你的云、你的芯片、你的模型,而堆栈各层之间互相强化:网络效应、生态系统、贯穿整个堆栈的价值捕获,每个人都建立在你的东西之上,每个人都深度锁定。其他公司可能也构建了这些堆栈的一部分,但你拥有一个可防御的、差异化的价值捕获平台。
这确实是 Windows 或 iOS 的运作方式。但问题在于,这个比喻可能并不成立。OpenAI 并不具备 Microsoft 或 Apple 那样的平台和生态系统动态。
资金:史无前例的资本规模
科技行业从未考虑过如此庞大的数字。四大云计算公司去年在基础设施上的支出约为 400 亿美元。OpenAI 几个月前宣称拥有 1.4 万亿美元和 30 千兆瓦的未来计算能力(没有时间表)。由于没有超大规模企业现有业务的现金流可供动用,OpenAI 迄今通过融资(且并非所有融资都已交割)和其他公司的资产负债表(其中一些是著名的"循环收入")来实现这一点。
外界对 TPU、Nvidia 的产品领先以及 Oracle 的借款策略已有诸多讨论。Oracle 的借款是建立在一项正在衰落但仍产生现金的传统业务之上的。这套打法究竟能否带来竞争优势,还是仅仅买到一个入场席位,目前尚无答案。
AI 基础设施的长期成本结构同样未知,但它很可能类似飞机制造或半导体行业:没有网络效应,但每一代工艺都变得更难、更贵。半导体行业既有众所周知的摩尔定律,也有鲜为人知的罗克定律(Rock's Law)。摩尔定律说芯片上的晶体管数量每两年翻一番。生成式 AI 或许会出现类似摩尔定律的效应,即单位成本持续下降,但固定成本上升到只有极少数公司能维持构建竞争模型所需的投资,其余玩家被挤出市场。这种寡头格局或许会带来定价均衡,但也可能只是把模型变成按边际成本出售的商品化基础设施。
因此,当萨姆·奥尔特曼宣布筹集了 1000 亿或 2000 亿美元,当他说他希望 OpenAI 每周建成一千兆瓦的计算能力(意味着每年约一万亿美元的资本支出)时,他实际上是在让一家三年前还没有收入的公司,坐上了一个可能需要每年在基础设施上花费数千亿美元的牌桌。其意志力已经足够惊人。但问题是:这买到的依然只是一个席位吗?
垄断不等于杠杆
台积电(TSMC)不仅仅是一个寡头——它在尖端芯片制造上实际上拥有垄断地位——但这几乎没有给它带来杠杆或价值捕获能力。人们开发 Windows 应用、网络服务和 iPhone 应用,但没有人开发"台积电应用"或"英特尔应用"。
开发者当年不得不为 Windows 开发,因为它几乎拥有所有用户;用户不得不购买 Windows PC,因为它几乎拥有所有开发者——这是网络效应。但如果你用生成式 AI 发明一个新应用、产品或服务,或将其作为现有产品的功能添加,没人会在乎底层算力。Snap 的用户不在乎它跑在 AWS 还是 GCP 上;购买企业 SaaS 产品时,没人关心它用的是 AWS 还是 Azure;用 Google 搜索时,排名第一的结果跑在哪家云上,用户永远不会知道。
这并不意味着各家 API 完全可互换——AWS、GCP 和 Azure 的市场份额差异明显,开发者选择它们也各有充分理由。但客户不了解,也不关心。运营云计算并不能让你对更高层级的第三方产品和服务产生影响力。
"万物互联"的愿景与标准之争
可能的区别在于:过去的云服务都是相互独立的——Google 和 Facebook 之上有一层统一的搜索与发现层,而在云基础设施之下是共通的底层设施。如今模型与网站之间、广告与电商之间、某种意图与自动化之间,正在发生对话(围绕 OpenClaw 的短暂热潮捕捉到了其中一部分)。一个网站可以表明自身功能,使其某个子集能够在 ChatGPT 中呈现。你可以告诉经纪人在 Instagram 上看食谱,然后在 Instacart 上下单食材。任何东西都可以与其他东西连接和对话。
如果能设定并控制这些 API、管理其中的流量,就能形成力量。标准是每一代技术的基础性竞争武器——记住 Microsoft 当年的口号"拥抱和扩展"(embrace and extend)。OpenAI 的具体主张是:让用户用 ChatGPT 账户作为将所有服务粘合在一起的粘合剂。这是一个潜在的网络效应。
但这个愿景存在两个疑问。第一,技术界有一种常见谬误,认为可以把许多不同的复杂产品抽象为一个简单的标准接口。十年前人们说"API 是新的 BD(商务拓展)",本质上是同一个概念。这一方面是因为演示中很酷的东西,与实际产品的交互模型、工作流程之间存在巨大鸿沟——很快你就会遇到需要真实产品界面和人类决策的例外情况。另一方面是因为激励机制错位:没有企业愿意沦为别人系统里一次"愚蠢的 API 调用",因此在抽象层可能带来的分发(Google 购物、Facebook 购物,以及今天的 ChatGPT 购物)与企业掌控自身体验和客户关系的愿望之间,存在固有的张力。要知道,Instacart 的全部利润来自展示广告。
第二,如果这些都是通过抽象、自动化的 API 连接起来的独立系统,那么一旦聊天机器人应用生态成立,OpenAI 使用一套标准,Gemini 使用另一套标准。为两套标准开发,工作量远小于同时开发 iOS 和 Android 应用——何况现在可以让 AI 替你写代码。这对开发者的锁定效应意味着什么?此外,用户可能用 OpenAI 或 Gemini 账户登录所有这些服务,但那些服务自身是否愿意交出这层关系,同样存疑。
真正的问题:权力
回顾全文,"平台""生态系统""杠杆""网络效应"这些词在科技行业被频繁使用,但含义模糊。Google 云、Apple 应用商店、Amazon 市场乃至 TikTok 都被称作"平台"。
也许真正准确的词是"权力"。中世纪史教授罗杰·洛瓦特(Roger Lovatt)曾给出过一个定义:权力是让人们做他们不想做的事情的能力。OpenAI 是否能让消费者、开发者和企业比对待竞争对手更愿意、更深度地使用它的系统?Microsoft、Apple 和 Facebook 都曾经拥有这种权力,那才是真正的飞轮。
回到比尔·盖茨的那句话:一个平台真正实现的,是利用整个科技行业的创造力。大模型本身是否具备这种平台属性?
基础模型确实是一种倍增器,大量新事物将借助它们被构建出来。问题在于:竞争对手也能造出同样的东西时,无论投入多少金钱和精力,你的产品能否始终比对手更好?消费科技行业的运行逻辑正是如此。如果做不到,剩下的唯一选择就是日复一日地执行——一些公司确实长期做到了这一点,甚至将其制度化,但那不是战略。
结语
另一个值得警惕的类比是零利率(ZIRP)时代的"资本作为武器"阶段:当时公司用廉价资本购买扩张路径,指望借此建立可防御的网络效应并实现市场主导。但这条路对没有网络效应的公司并不适用——WeWork 就是前车之鉴。
最终,行业可能得到许多不同形态和规模的模型,其中一部分在边缘设备上免费运行。届时谈论"AI 基础设施垄断",或许会像今天谈论"SQL 基础设施垄断"一样没有意义。这只是一种可能,目前谁也无法确知。
反过来说,Microsoft、Google、Apple 和 Meta 即便身处一个近乎"赢家通吃"的世界,也从未自认稳赢——它们始终盯着身后。这种心态的标志性表达,是安迪·格罗夫(Andy Grove)的那句"只有偏执狂才能生存"。英特尔曾经拥有网络效应,后来没有了;曾经拥有技术领先,后来也没有了。对 OpenAI 而言,这两句话或许都值得贴在墙上。