在人工智能技术飞速发展的当下,科学家的编程学习方式正经历深刻变革。随着大型语言模型(LLM)和自主AI代理的普及,构建复杂计算管道、进行统计分析及数据可视化的门槛大幅降低。这引发了一个核心问题:既然AI能在数秒内完成过去需要数周排错的代码编写,科研人员是否仍需学习编程?
答案是肯定的,但重点已从掌握编码语法转向如何高效引导AI工具解决科学问题。早期职业生涯的科学家正逐渐承担起类似高级软件工程师的角色:监督、批评并完善由AI生成的输出。以下是利用这一新范式提升工作效率的六个关键策略。
像系统架构师一样思考
许多科研人员在引入AI辅助编程时,担心自身长期积累的技能会退化。然而,真正的价值不在于记忆特定函数或库(如Python pandas)的确切语法,而在于理解这些方法的存在、基本原理及适用场景。通过阅读文档了解不同函数的功能,科研人员可以像系统架构师一样,将AI引导至强大且可重复的解决方案中,从而避免陷入琐碎的语法细节。
采用模块化思维
面对能瞬间生成数百行代码的AI模型,试图要求一个单一脚本完成从原始数据清洗到最终出版级图表输出的全流程,往往会导致脆弱且难以调试的系统。一旦变量变更或AI出现幻觉,整个架构可能崩溃。更有效的做法是促使LLM编写小型、离散且目标单一的函数,例如分别负责数据摄取格式化、数值标准化及可视化生成。这种模块化管道不仅易于隔离和修复错误,还允许代码块在不同项目中复用,从而建立起可靠的人工智能工具库。
实施标准化项目结构
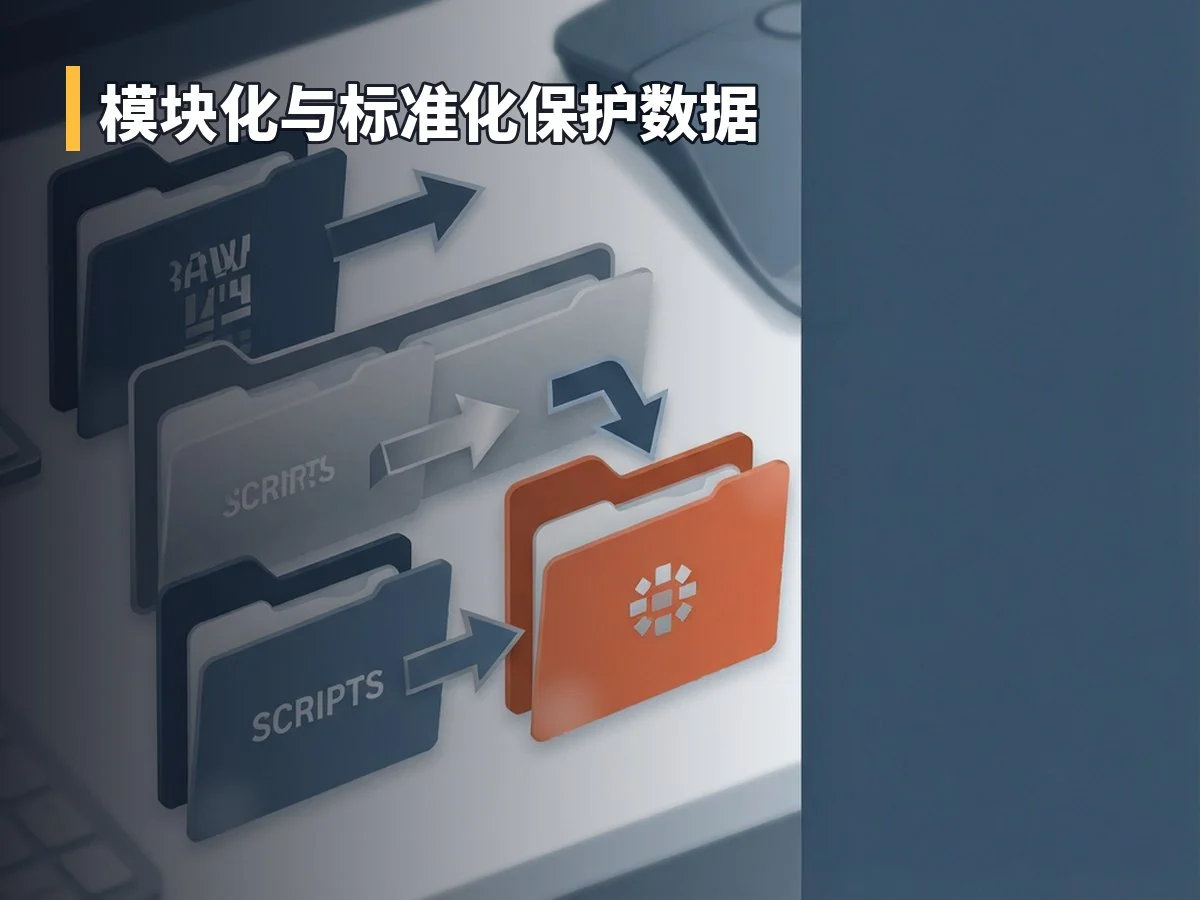
AI降低了编写代码的摩擦,导致脚本和数据输出激增,项目目录容易陷入混乱。曾有案例因未规范化管理而意外覆盖原始数据文件。因此,采用如Cookiecutter数据科学框架等标准化工具已成为必要实践。该框架严格分离输入文件与分析脚本:所有原始数据(如测序文件或临床电子表格)存储在只读文件夹中,活动分析脚本位于另一文件夹,所有输出则进入第三个文件夹。这种结构强制执行了数据保护机制,防止AI生成的脚本意外破坏主要数据集。
确保数据隐私与安全
将AI融入科学工作流程引入了伦理和监管风险,因为公共模型通常基于用户输入进行训练,敏感的患者数据若输入云端LLM可能导致泄露。为规避此风险,建议在请求AI编写分析脚本前,先提供“假数据”:仅给出列标题、预期数据类型(整数、字符串或浮点数)及数据维度,明确不共享任何真实值。随后,让模型基于虚构数据集编写、测试和调试代码,再将经过验证的代码复制到本地安全环境中处理真实受保护数据。这样既利用了AI的能力,又确保了法律法规下的数据完整性。