在 OCP 2026 大会上,Intel 正式将代号“新月岛”(Crescent Island)的 AI 加速器命名为 Intel GPU D-Series。此次发布首次披露了该芯片的理论峰值性能目标为 FP8 精度下 1.3 PFLOPS,以及人工智能推理加速器的最终内存带宽达到 1.5TB/s。这一信息延续了 Intel 自 2026 年初以来对“半月岛”相关技术的逐步披露节奏。
作为首款基于 Intel Xe3P 图形架构(亦称大规模并行计算架构)的芯片,GPU D-Series 将以空冷 PCIe 形式推出,热设计功耗(TDP)为 350W,最高支持 480GB LPDDR5X 内存。
与 Nvidia Vera Rubin NVL72 机架级系统中的 Rubin GPU 相比,后者单卡理论 FP8 吞吐量可达 17.5 PFLOPS,但需液冷支持且功耗可能以千瓦计。由此可见,Intel GPU D-Series 的目标并非追求极致的单卡算力,而是定位于完全不同的性能包裹与基础设施需求。
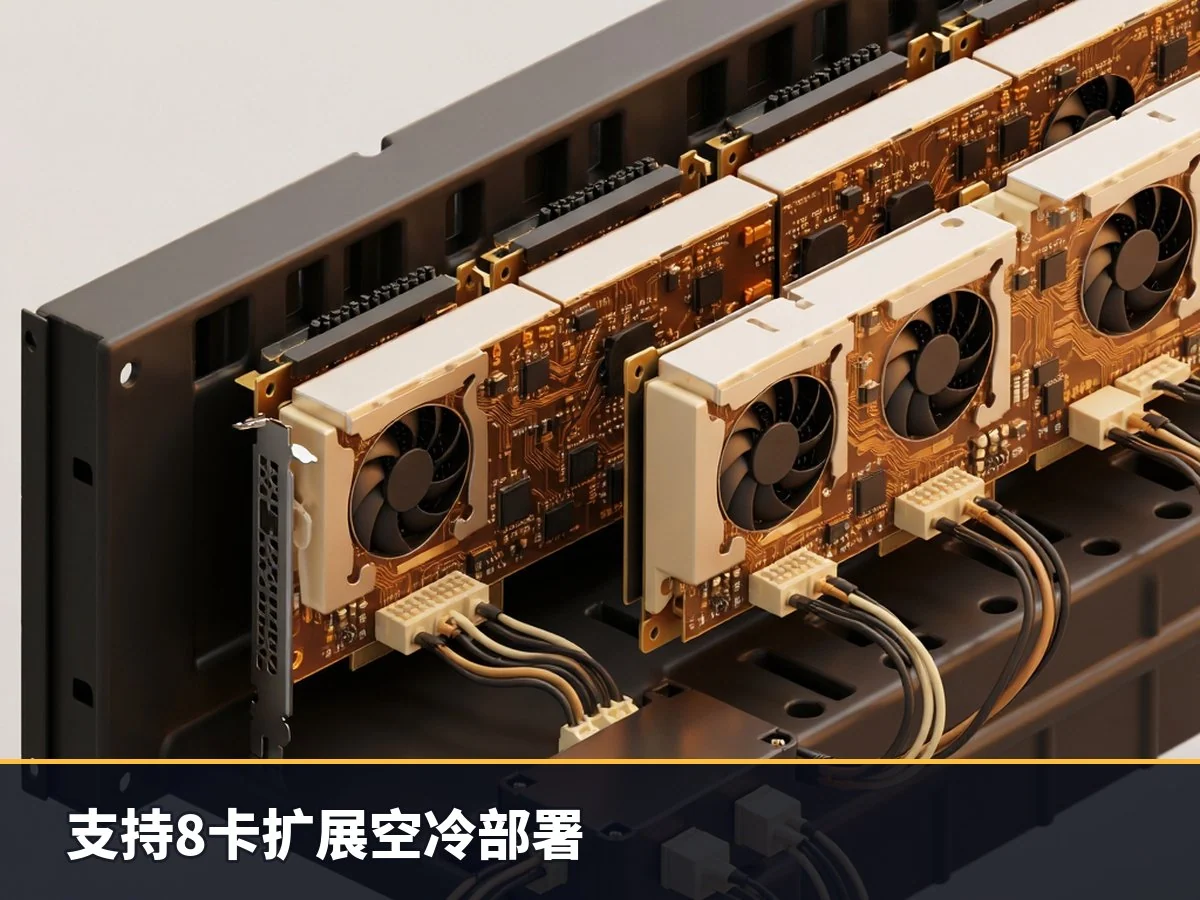
Intel 强调,GPU D-Series 旨在部署于传统空冷机架服务器中,支持扩展至 8 个 GPU,类似 Nvidia HGX 系统的配置。在此类分布式推理部署中,多个 GPU 可协同工作,Intel 表示该系列芯片能够处理跨越一万亿参数的模型推理任务。此外,该产品主要面向大型语言模型、长上下文推理及并发推理服务,并为多租户 AI 服务、机器人及其他延迟敏感型工作负载提供基础支持。
为实现上述分布式推理能力,Intel 指出其依赖于强大的软件栈支持。公司正在推广其在集成显卡和独立显卡 Xe 核心中构建的“共同 Xe 软件基础”,以确保 AI 计算的兼容性。
在生态合作方面,Intel 表示正与 OEM、ODM、新兴云服务商、独立软件供应商、家电厂商及 AI 原生企业展开广泛合作。目前,GPU D-Series 产品的客户采样正在进行中,但官方尚未公布全面上市的具体细节。
鉴于此前数据中心 GPU Max 系列(代号 Ponte Vecchio)及其后续产品未能成功整合进连贯的 AI 战略,加之多次收购未达预期,Intel GPU D-Series 能否成为其 AI 加速器业务的转折点仍待观察。然而,在当前对每一个计算周期都至关重要的推理市场中,一款具备成熟架构、专门针对可访问的热电包裹进行优化的产品,或许正是行业所需。