一项完全在浏览器内运行的本地实验:大语言模型在面临选择题时,可以直接读取所允许选项的概率分布,而无需经历完整的文本解码过程。该实验允许用户选择模型尺寸,在自己的 GPU 上运行,并实测两种路径的差异。整个流程不依赖任何后端服务,输入不会离开页面,模型文件缓存在浏览器中;首次加载所需时间取决于所选模型、网络状况与 GPU 性能,可能需要数分钟。
加载模型
默认选用 MiniCPM5 2B;若在手机或配置较低的设备上运行,可在模型选择框中切换至 Qwen3 0.6B。需要注意的是,更大的模型加载速度较慢,部分低端设备可能无法承载。
下表为原生检查点(native checkpoints)在自测与公开基准上的实测模型质量,所有列均为平衡准确率(balanced accuracy)。其中「TypeSafe」列为同一 102 行公开子集上的等级协议,取公布值。浏览器端量化可能会改变模型的实际准确率。
| 模型 | 下载体积 | 作者列(平衡准确率) | 另一基准列 | TypeSafe |
|---|---|---|---|---|
| Qwen3 0.6B | 639 MB | 44.0% | 52.8% | 40.7% |
| MiniCPM5 2B | 1.56 GB | 68.6% | 69.3% | 63.7% |
| 3.5 4B | 3.01 GB | 81.3% | 76.6% | 84.5% |
| 托管模型(hosted) | hosted | — | — | 88.3% |
加载流程分为三个阶段:下载与缓存仅在用户点击加载时启动;随后进行模型加载,即下载并准备模型;最后执行 warmup,为两种推理方法分别完成编译 pass。
给定一个真实决策
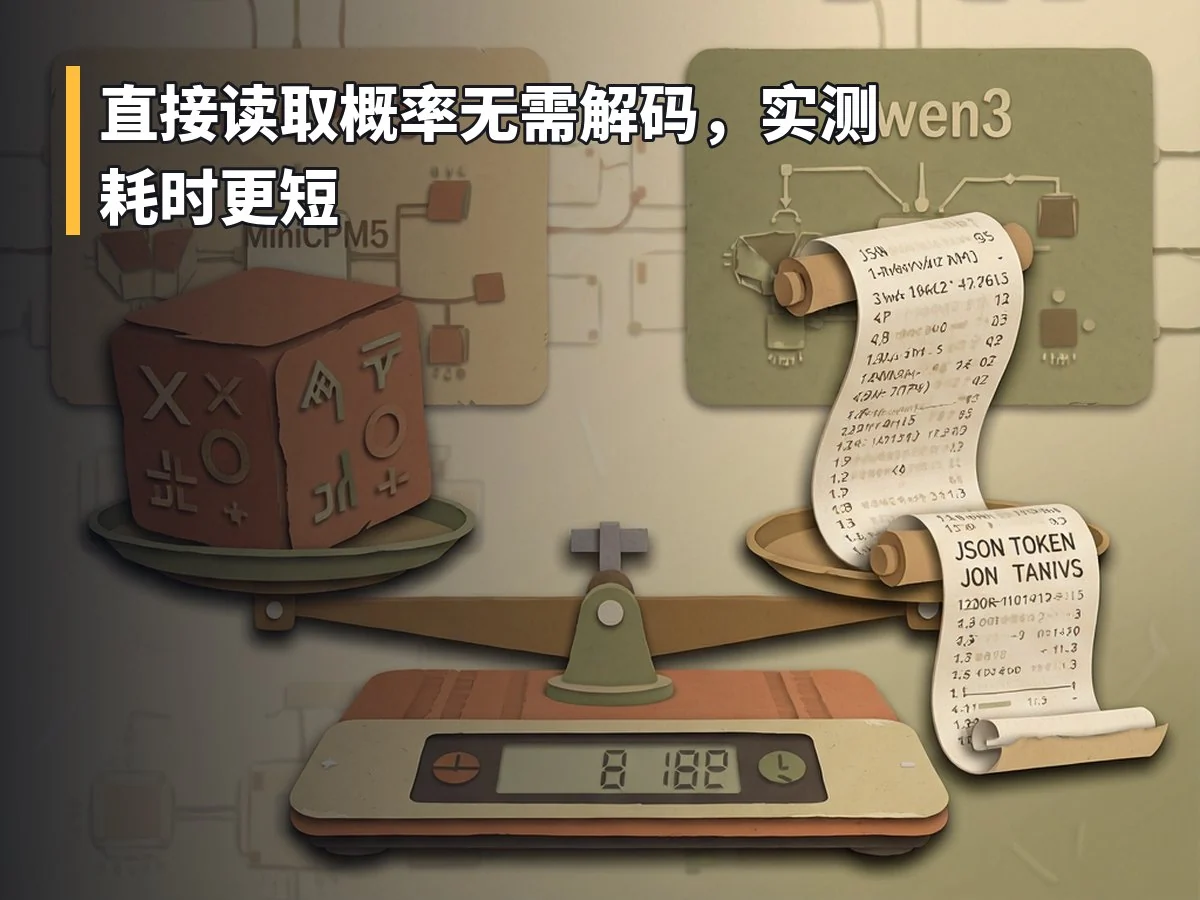
实验向模型提供状态(state)、问题(question)与一组选项(options),由同一个本地模型——MiniCPM5 2B——给出决策。两条路径产生相同的决策结果,但机制不同:一条直接读取选项 logits,即各选项 A…T 的概率;另一条则要求模型将选项概率写成 JSON 文本,逐 token 生成。
用户可直接输入自己的决策场景进行测试,也可尝试页面提供的示例。
路径 A:直接读取概率
该路径不做任何解码(no decoding),直接读取模型的选择 logits,并仅对用户提供的选项进行归一化处理。运行后页面会显示总耗时、输入耗时与输出读取结果。
路径 B:生成 JSON 概率
该路径逐 token(token by token)运行,要求模型估计同一组选项的分布,并将其写成 JSON。用户可以观察每个 token 的到达过程,并对比首 token 延迟、总耗时、输入与输出耗时。
实测时间比
两种方法在同一个已加载模型上顺序运行,不会争抢 GPU 资源:先执行直接读取,再执行生成路径。页面最终给出两种方法的实测 wall-time 比率,具体数值取决于用户自身的 GPU 性能。